几乎每个研发都踩过这个坑
改了某个服务的业务逻辑,单测全过、CI 绿灯、CR 通过,顺顺利利上线。十分钟后监控告警炸了——服务响应时间直线飙升。
你反复核对两遍 diff,逻辑挑不出毛病。但要定位根因,你得跨至少 5 个平台:日志去 SLS 搜、指标去 Grafana 拼、链路去 APM 查、变更去发布系统翻、拓扑找运维要 CMDB 数据。每个平台查询语法不一样,权限卡一半,最后还得在群里 @SRE 帮忙拉数据。来回多轮跨团队沟通协同,半小时过去了,你全程只能盯着对话框等回复。
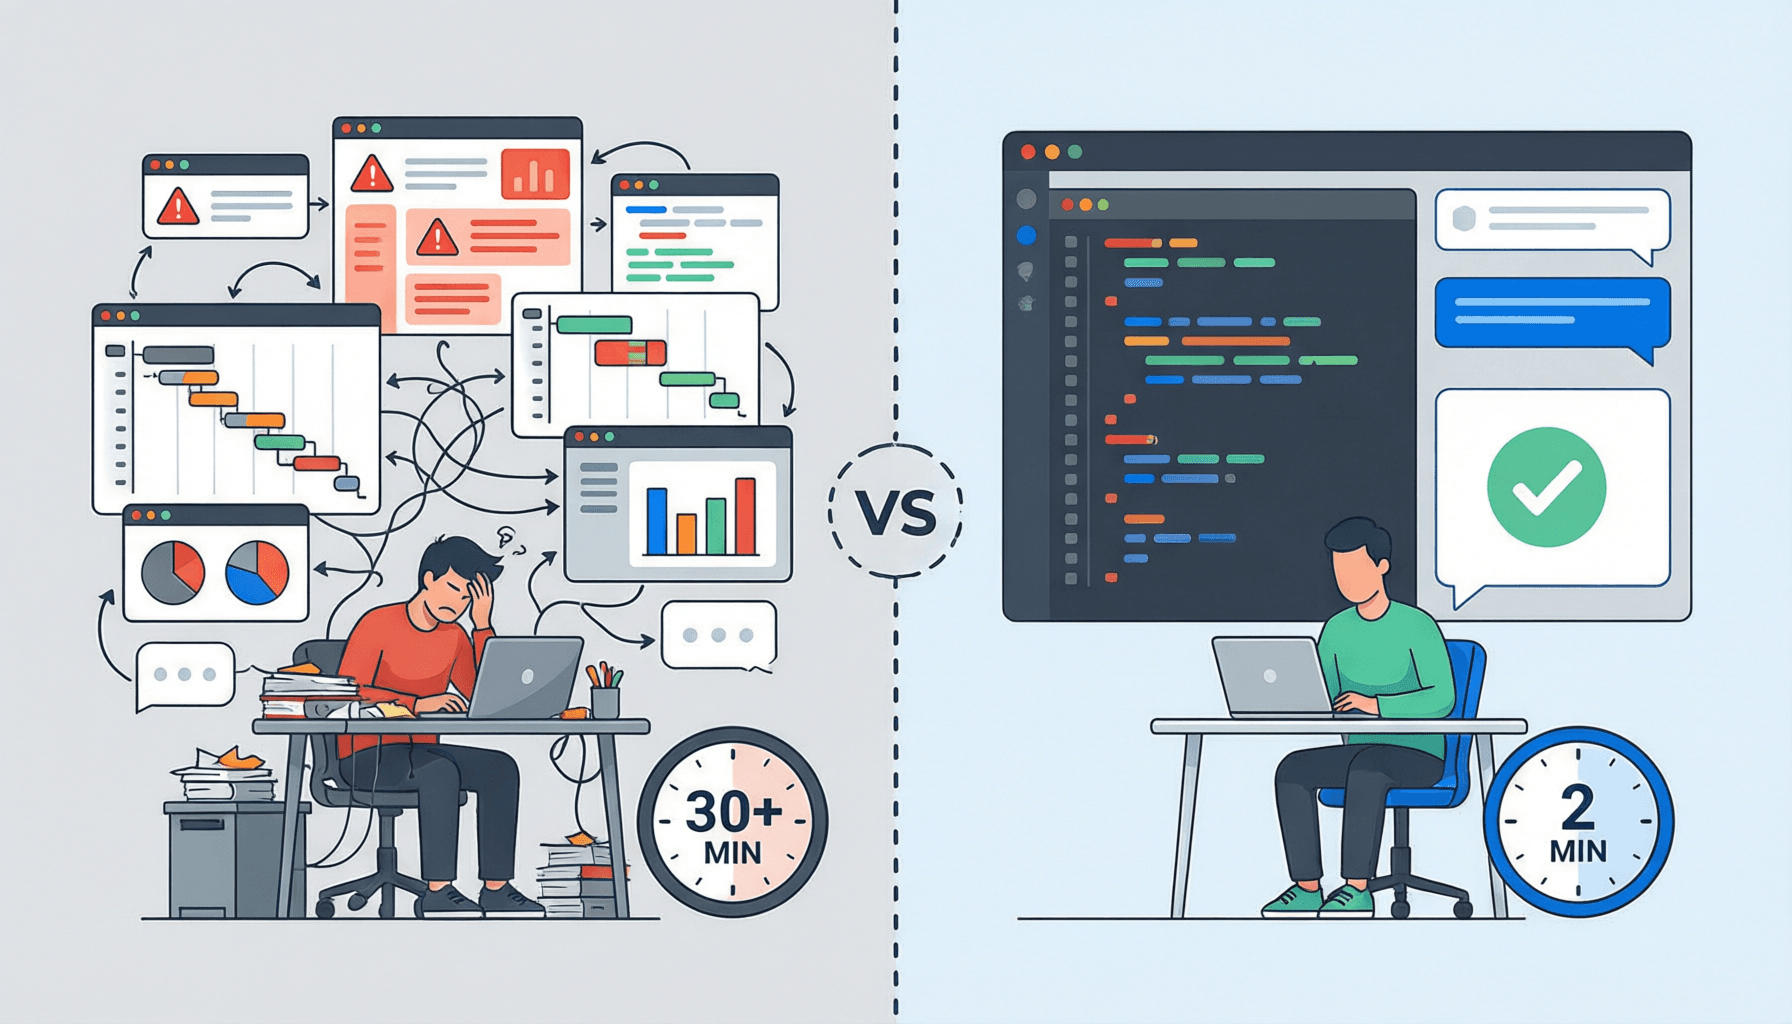
而这样的场景,可能每周都在你的技术团队里重复上演。
问题的本质从来不是缺工具。据 Gartner 2025 年 DevOps 工具链报告,中大型企业平均部署 6-8 套运维监控工具,覆盖监控、日志、链路、变更、事件管理等多个领域——什么都不缺。但这些工具的目标用户是 SRE 和运维团队,核心设计目标是「全面、专业、可定制」,对应的是复杂的查询语法、专业的概念体系和冗长的操作路径。
矛盾的核心是工具的目标用户错配。对研发工程师而言,线上排查是低频应急场景,为了一次故障花 1 小时学习 PromQL、SLS 查询语法,投入产出比远低于直接求助运维——这恰恰造成了跨团队沟通损耗,也让运维团队陷入大量重复查数的事务性工作,无暇投入更核心的稳定性建设。研发工程师要的从来不是学会用运维工具,而是直接拿到可执行的诊断结论。这不是要替代运维,而是把标准化的诊断能力下沉到研发侧,让双方都聚焦在自己的核心价值上。
如果有一种方式,让你不用离开 AI Coding 工具就能查线上、看诊断、问根因呢?
当 STAROps 长在 Qoder 里
先花一句话介绍阿里云 STAROps 全域智能运维平台:用自然语言就能查指标、分析日志、追踪链路、诊断告警。它背后是阿里云沉淀多年的运维统一数据模型 UModel——不同于传统 CMDB 只记录静态资产关系,UModel 打通了不同运维工具的数据孤岛,构建了应用、服务、资源、告警、变更的全要素语义网络,统一了实体关联关系与数据口径。这是大模型能够精准完成跨域根因推理的核心底座,从根源上避免了跨工具数据对不齐、关联错的问题。
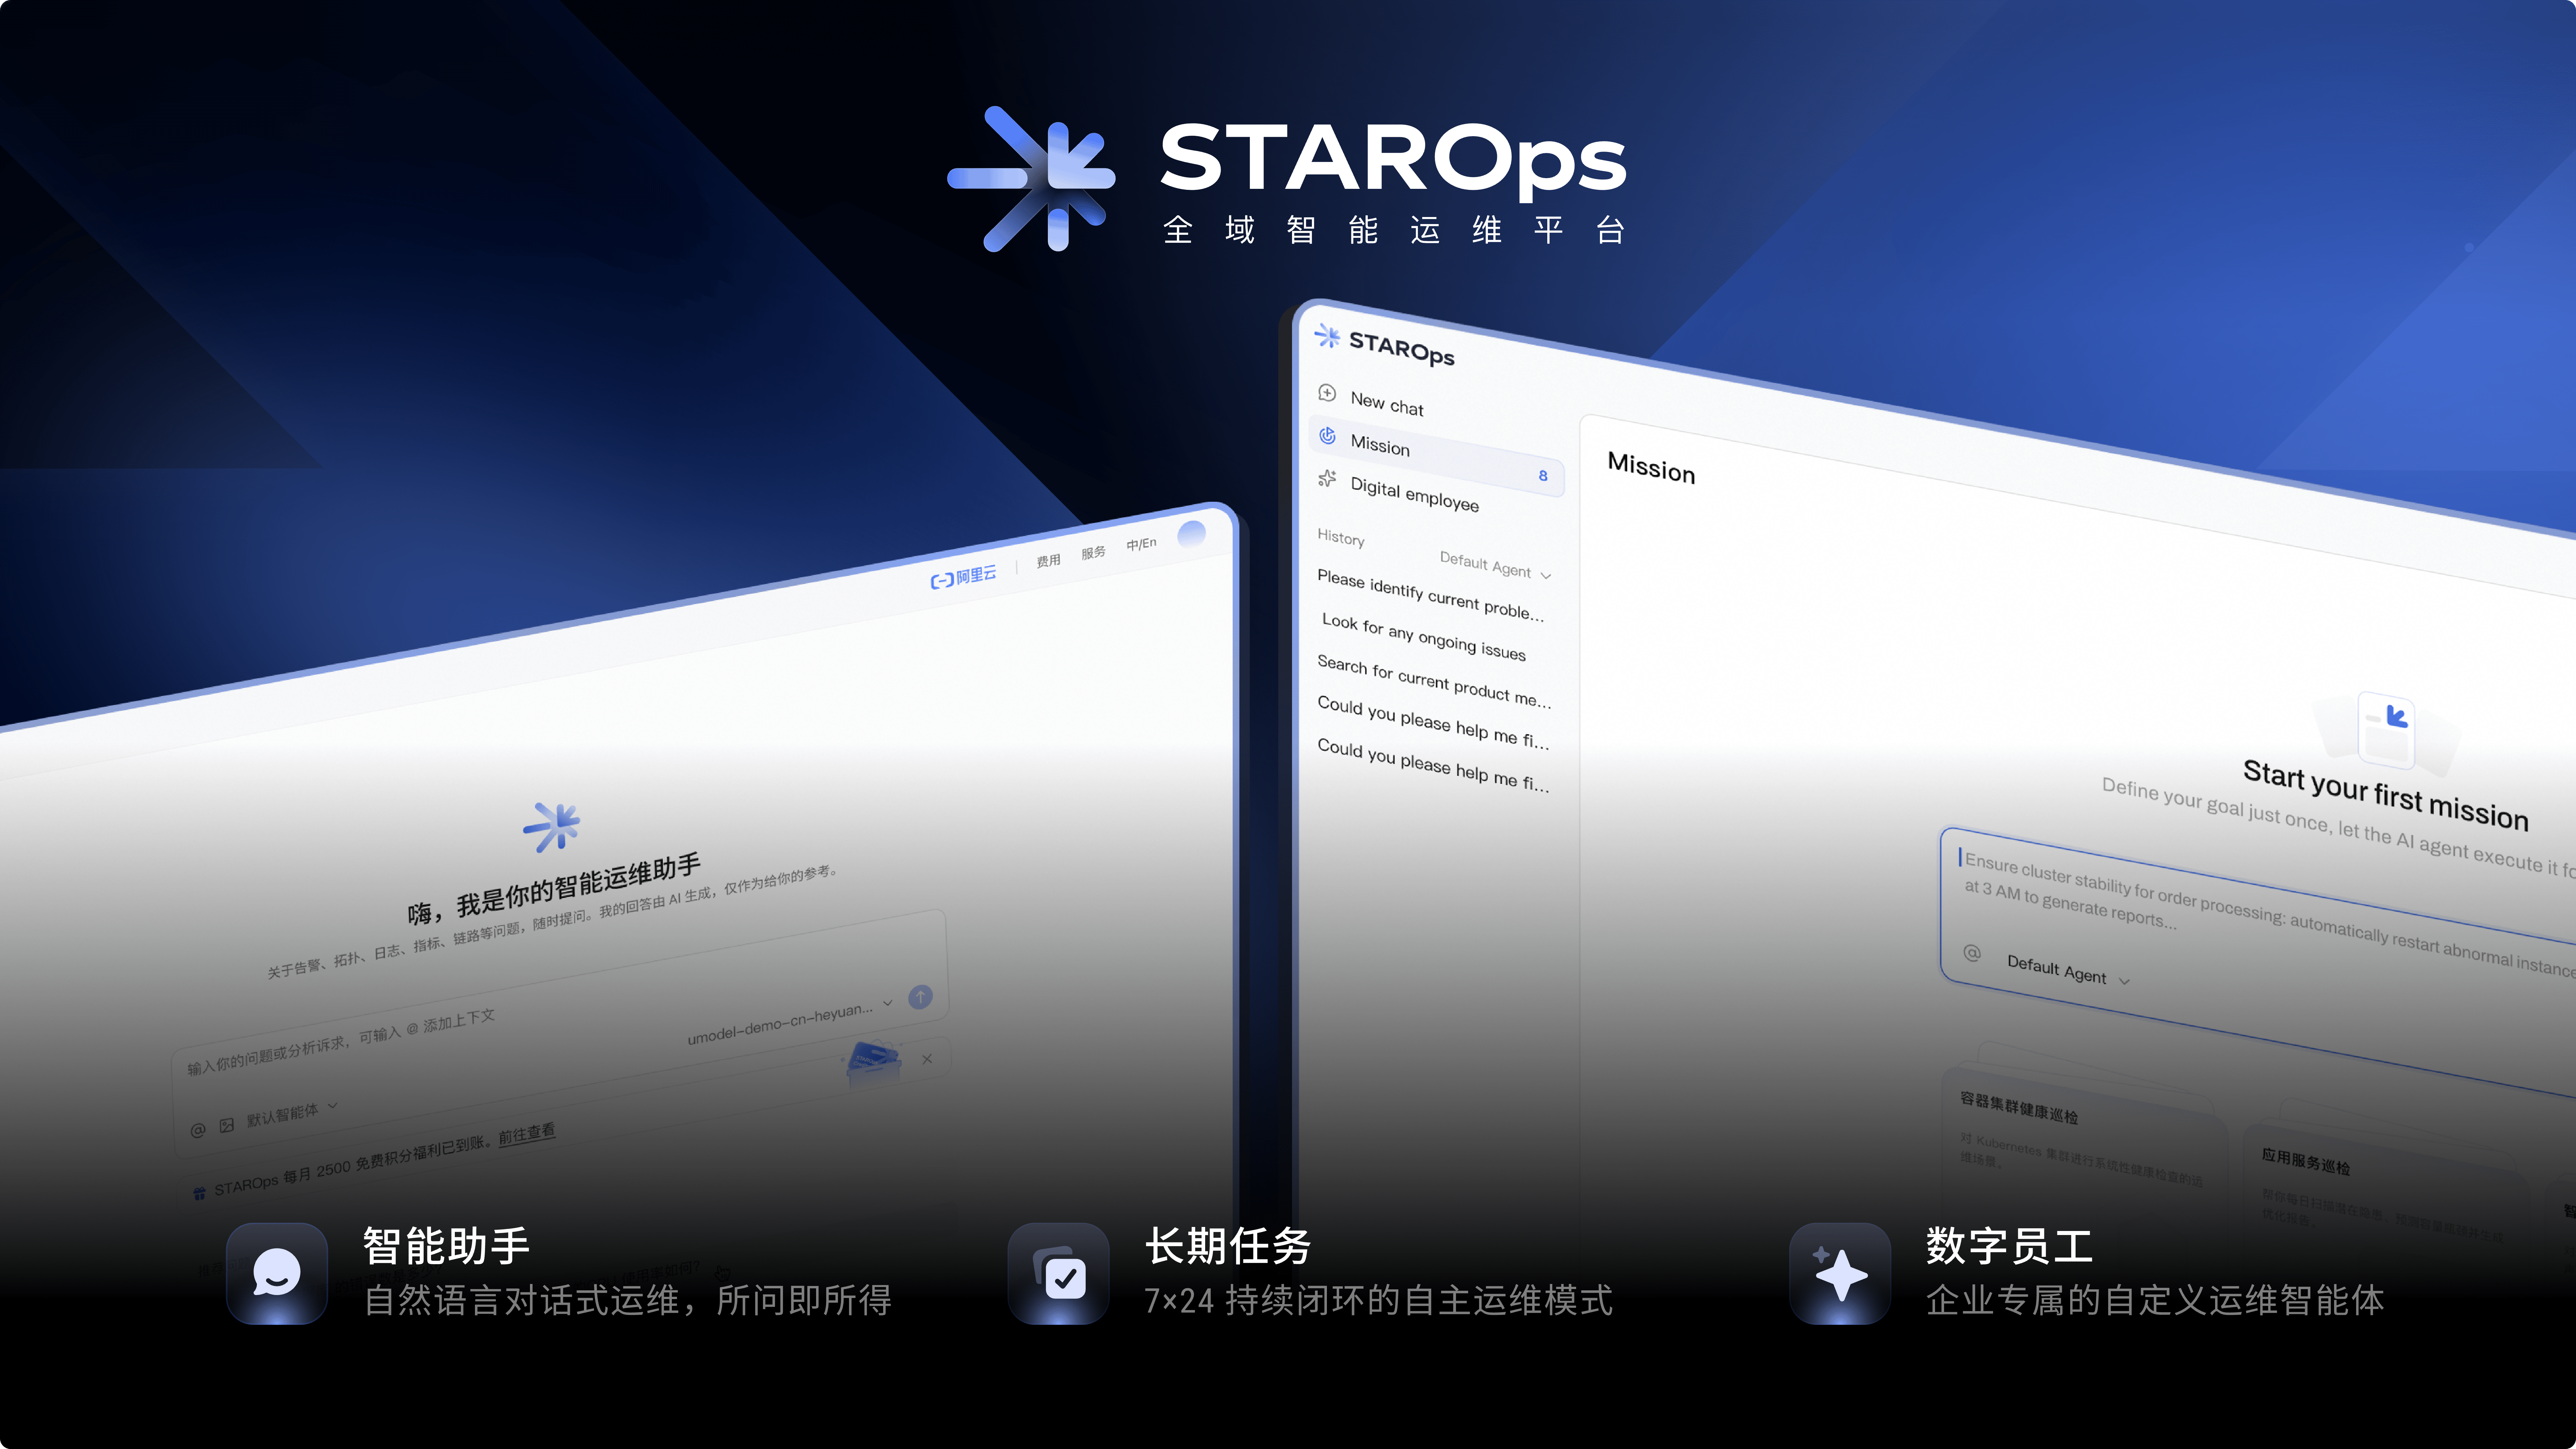
STAROps 本身已经非常强大——运维团队通过控制台或 IM 就能完成日常的诊断和巡检。现在,这套能力被进一步延伸到了研发工程师的 AI Coding 工具里。装上 STAROps 官方插件之后,你在 Qoder 的对话框里用自然语言提问,STAROps 完成跨域数据查询和根因推理,结构化结论直接出现在你的 Qoder 里。不用切窗口。不用等运维同事。不用学任何新的查询语法。这意味着研发工程师第一次拥有了生产环境的可视化诊断能力——你在写代码的同时,可以随时看一眼线上的真实状态,而且看的方式不是翻监控面板,而是像跟同事聊天一样自然。
三个场景,看看实际怎么用
以下三个场景按日常开发的时间线排列:出了问题怎么查、查完怎么追、改之前怎么看。
场景一:服务报错了,直接在 IDE 里问
回到开头的例子。发布后响应时间飙升,你现在在 Qoder 里直接问:
我收到 product-catalog ListProducts 高延迟告警,P95 从 <60ms 飙到 1875ms,分析一下问题根因STAROps 收到请求后自动开始工作。它会做这么几件事:先查服务最近的错误日志,提取异常堆栈和错误模式;然后拉取 APM 指标,看 P95 延迟、容器副本数和吞吐量的变化趋势;接着查拓扑关系,看上下游服务的调用链有没有异常;最后关联变更记录——它会拉出最近的发布事件清单,逐条比对部署时间与延迟曲线的关联性。整个分析过程以流式方式返回,你在 Qoder 对话框里就能看到 STAROps 一步步收集证据、推理根因的过程。最终结论可能是这样的:
根因分析:DB 连接池饥饿(MaxOpenConns=1, MaxIdleConns=1),触发版本:v2.2.0-buggy(commit d9420f7,工单 OPS-1024,操作人 David Zhang)。证据链: 14:06 v2.2.0-buggy 部署后,P95 延迟立即从 <60ms 飙升至 1875.8ms,容器 ReadyReplicas 从 2 暴增到 24(自动扩容触发),偏差超 ±4.1σ。回滚到 v2.1.0 后延迟立即恢复。核心机制: ListProducts 需要并发执行多个 GetProduct → 多条 SELECT 同时争抢仅 1 个数据库连接 → 大量请求在连接池上排队,单条 SELECT 实际耗时被排队等待放大到 300ms ~ 3400ms。结论: v2.2.0-buggy 版本将 MaxOpenConns 从合理值降到 1,并发 GetProduct 在数据库连接池上排队,导致 ListProducts P95 延迟从 <60ms 飙到 1875.8ms。建议立即回滚到 v2.1.0,并通过特性标记隔离问题版本。置信度:80%。
[从提问到 STAROps 返回结构化根因分析的全流程]
传统模式下,这类发布后故障排查需要跨 3 个以上平台——容器监控看副本数和资源指标、APM 平台看调用链和延迟分布、发布系统翻部署记录——协调 2 位运维同事,平均耗时 40 分钟以上。通过 Qoder + STAROps,从提问到拿到结论,可能只要两三分钟。而且这个结论不是"你自己去翻日志"——它已经帮你把容器指标、延迟曲线、发布时间线、配置差异交叉关联过了,是经过推理的诊断结论——你可以直接基于这个结论去改代码。
场景二:诊断不是一锤子买卖
真实世界的排查很少是一轮就能定位的。你拿到了"连接池饥饿"的初步结论,但你还需要确认更多:延迟飙升是从 v2.2.0-buggy 部署那一刻就开始的,还是有一个渐进的过程?是 ListProducts 单个接口导致的,还是全局性的?v2.2.0-buggy 到底改了哪些配置?你还需要进一步下钻验证 —— 而这一切同样不用离开 IDE,不用重新输入上下文。
在 Qoder 里,你直接追问:
把发布时间和延迟曲线叠加对比一下,
确认因果关系对比一下 v2.2.0-buggy 和 v2.1.0 的关键配置差异哪些接口受影响最大?
连接释放延迟有没有异常?
STAROps 支持多轮对话。同一会话 Thread 内的上下文全程保留——它知道你问的还是 product-catalog 服务,知道你关心的是 OPS-1024 这个工单对应的连接池问题,不会每一轮都重新扫描全量数据。你像跟一个熟悉系统的 SRE 同事聊天一样,一轮一轮地追问,逐步收敛排查范围。
它会给你拉出发布时间与延迟曲线的关联分析——14:06 v2.2.0-buggy 部署后延迟立即上升,14:06 到 14:22 二次部署期间 P95 急剧攀升至峰值,回滚到 v2.1.0 后延迟恢复正常,时间高度吻合。它会帮你做版本配置差异对比——定位到 SetMaxOpenConns、SetMaxIdleConns、SetConnMaxLifetime 这些连接池参数的具体变更,以及 SetProduct 写入操作的异常引入。最终你可能定位到:v2.2.0-buggy 不仅把连接池压缩到极限,还在查询路径里插入了不必要的数据库写入操作,双重因素叠加导致连接池瞬间耗尽。
根因找到了,修复方案也很清晰——恢复连接池参数到合理值,移除多余的 SetProduct 写入,给查询加上 100ms 的 context timeout 防止慢查询阻塞。
[从初步结论 → 发布时间关联分析 → 版本配置差异对比 → 精确定位根因的逐层收敛过程]
这个场景的价值在于深度。单轮诊断给你方向,多轮追问帮你精确定位到具体的代码变更。整个过程不需要你掌握任何运维查询语法,不需要你理解 Prometheus QL 或者 SLS 的查询语法,你只需要用自然语言描述你想知道什么。
场景三:根因找到了,接下来怎么修
前两个场景帮你定位了根因:product-catalog 服务的 v2.2.0-buggy 版本将数据库连接池压缩到极限,并在查询路径中引入了不必要的写入操作,导致 ListProducts 接口 P95 延迟飙升到 1875.8ms。但诊断不是终点——你还需要把这个结论变成一个具体的代码修复方案,完成提交,推动上线。
在 Qoder 里继续问:
OPS-1024 这个连接池饥饿问题应该怎么修?给我具体的代码修复方案,改完帮我提交 MRQoder+STAROps 不只告诉你"哪里出了问题",还能直接帮你修。它会基于刚才的诊断上下文——工单 OPS-1024、buggy commit d9420f7 引入的连接池参数变更、ListProducts 接口的 P95 从 <60ms 飙到 1875.8ms——生成具体的修复代码:
修复方案(12 条修改项):修复文件:src/product-catalog/main.go
你拿到的不是一句笼统的"检查连接池配置",而是精确到代码文件和具体参数的修复方案。但更关键的是接下来发生的事——你不需要自己手动执行这些修改。Qoder+STAROps 直接接管了整个提交流程:它自动创建了修复分支 fix/product-catalog/revert-ops-1024-pool,把修改后的代码 commit & push 到远端。然后通过 MCP 协议调用云效 Codeup 的 API,自动创建了一个 MergeRequest,目标分支是 master,MR 标题为 fix/product-catalog: revert OPS-1024 DB pool starvation and pg_sleep audit——连 MR 描述都是自动生成的,包含了完整的故障背景、根因分析和修复说明。你在浏览器里打开云效 Codeup,MR 已经在那里等你 review 了。
[STAROps 自动生成修复代码、创建 Git 分支、通过 MCP 调用云效 Codeup API 创建 MergeRequest 的全流程示意,最终在浏览器中确认 MR 已成功创建]
这个场景的价值是闭环。传统流程里,从定位根因到写出修复代码之间还有一段"翻译成本"——你得自己理解问题的技术细节,想清楚怎么改,改哪些文件,改完还要手动走 Git 流程、登录代码平台创建 MR。Qoder+STAROps 把这整段成本都省了:诊断结论直接衔接修复代码,修复代码直接变成 MergeRequest。从发现问题到 MR 等待 review,整个过程可以在一个 IDE 窗口里完成,中间不需要切换到任何其他平台。研发工程师的编码决策不再只基于代码逻辑和本地测试,而是有了生产环境真实数据的支撑——你提交的修复不只是"逻辑正确"的,还是"了解线上环境"的。
背后发生了什么
三个场景看完了,你可能想知道:这一切是怎么做到的?
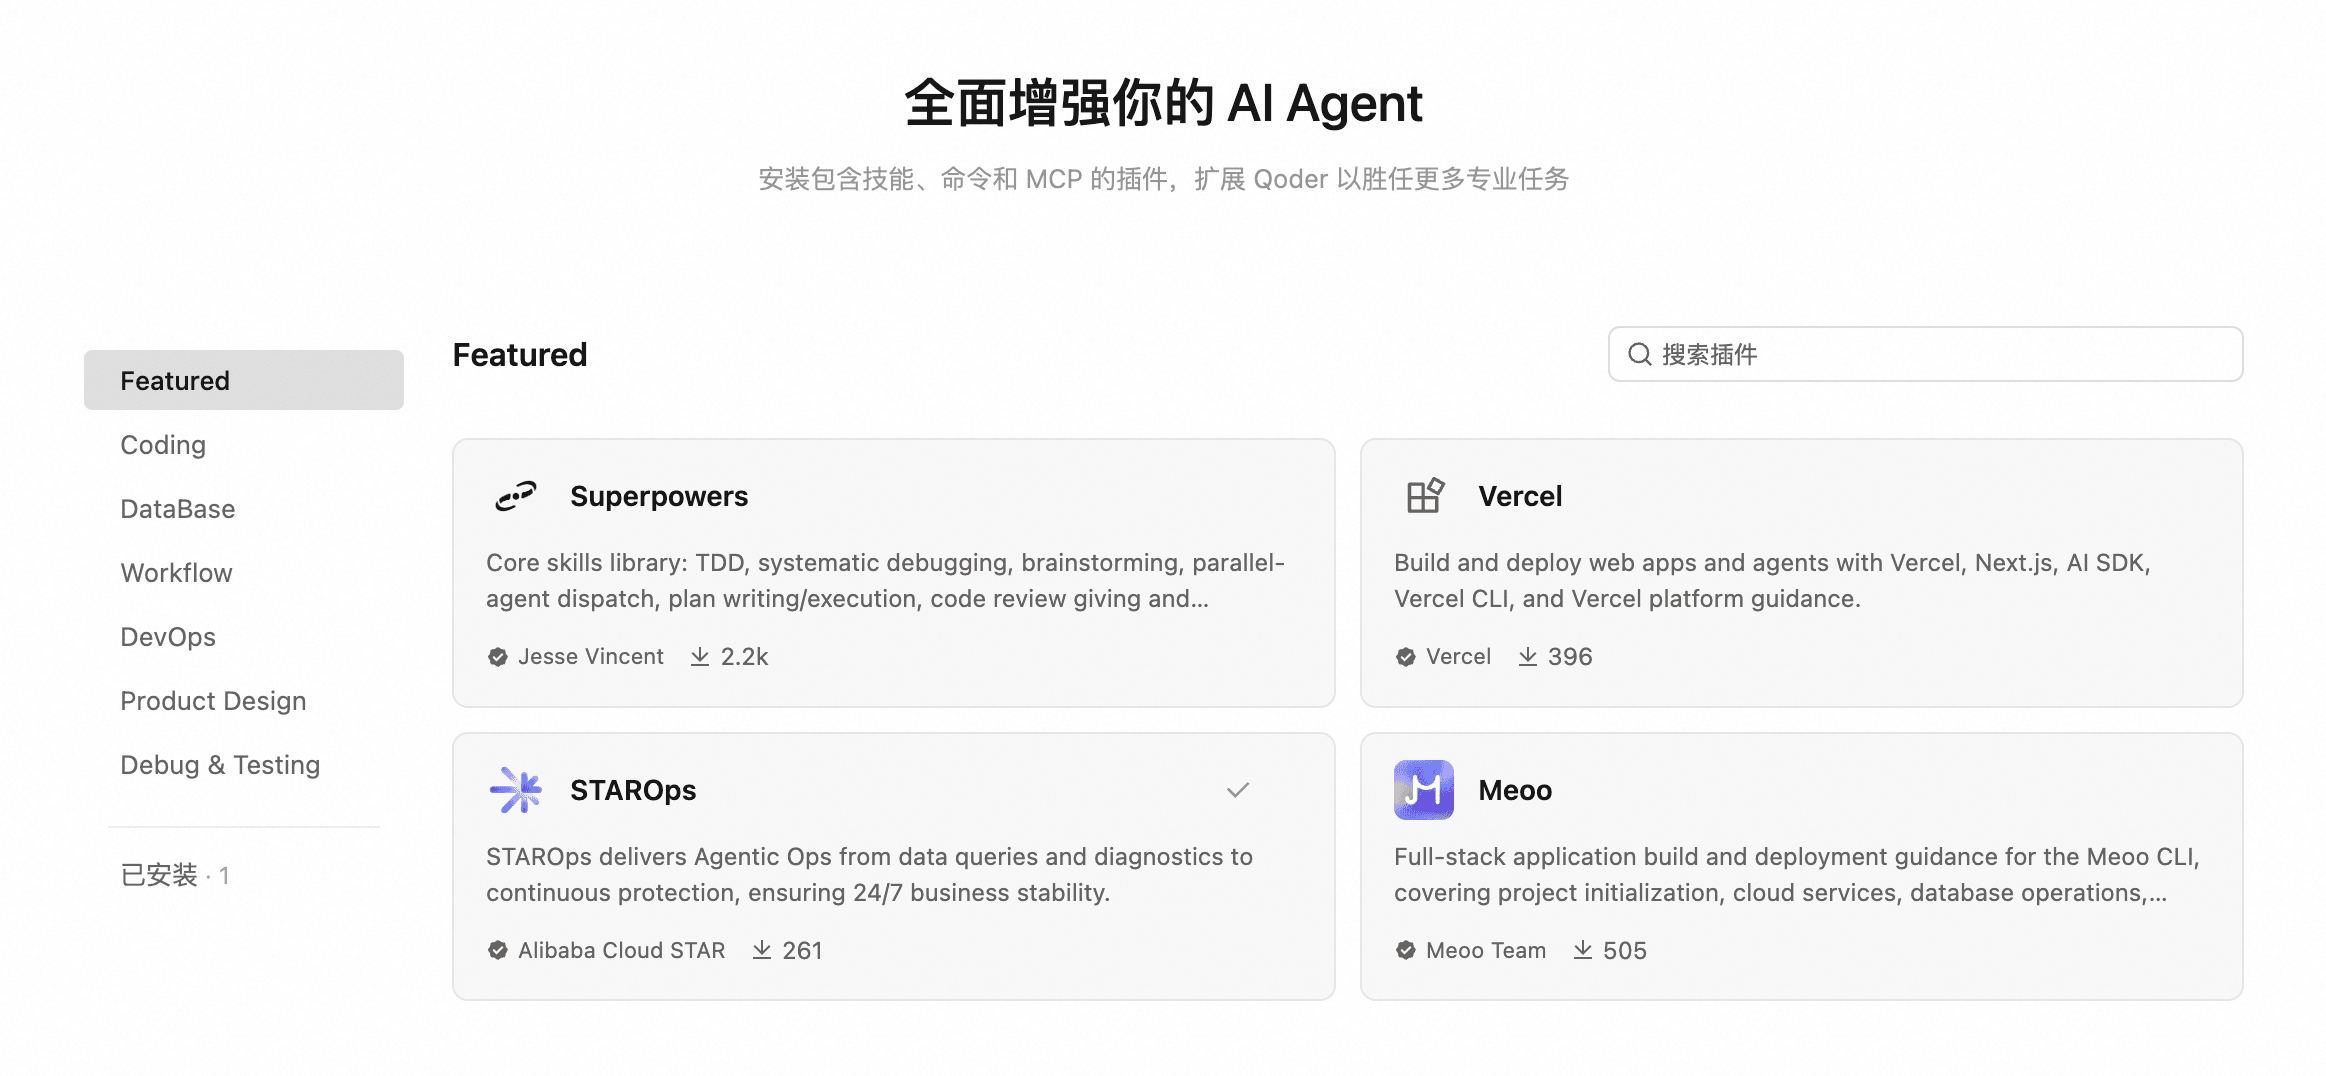
答案是 Qoder 的 Plugin 插件机制。STAROps 提供了官方插件,在 Qoder 插件市场一键安装后,你在对话框里的每一句运维相关提问都会被路由到 STAROps 处理。
调用链路很简单:你输入自然语言 → Qoder 识别运维意图 → 请求转发给 STAROps → STAROps 执行跨域数据查询和根因推理 → 结构化结论返回你的 IDE。
安全机制遵循阿里云企业级规范:继承 RAM 权限(无越权)、只读查询(无变更)、自动脱敏(无泄露)、全量审计(可追溯)。凭据走 Credentials SDK 默认链,支持环境变量、配置文件、OIDC,无需明文密钥。
值得说明的是,STAROps 有三种能力形态:智能助手(即时问答诊断)、长期任务(持续巡检守护)、数字员工(可配置职责和权限的运维 Agent)。你在 Qoder 里调用的是智能助手——即时、精准、按需触发,最适合研发工程师在编码过程中快速获取运维洞察。如果后续需要持续监控(比如"发布后自动盯一个小时"),可以升级到长期任务。
怎么开始
三步上手,全程 3 分钟:
第一步,安装 STAROps 插件。在 Qoder Desktop 切换到 Quest 视窗,在插件市场搜索「STAROps」一键安装。
第二步,配置阿里云凭据。 遵循 Credentials SDK 默认链标准,支持环境变量、配置文件、OIDC 等多种方式,无需明文配置密钥。
第三步,开始提问。 打开 Qoder 对话框,用自然语言描述你想查询的运维问题即可。
STAROps 新用户赠送 10000 积分,有效期 1 个月;每月再提供 2500 积分免费额度。参考消耗:单次轻量查询约 30 积分,一次完整跨域根因诊断约 200 积分。
运维能力左移:一个正在发生的趋势
到这里,这篇文章讲的其实是一件具体的事:研发工程师通过 Qoder 获得了 STAROps 的运维诊断能力。但如果把视角拉远一点,你会发现这件事的意义不止于"IDE 里能查线上"。
传统模式下,研发和运维之间的能力边界是硬性的。研发写代码,运维保系统,中间靠人传话、靠工单流转、靠开会同步。STAROps 插件接入 Qoder 之后,这条边界第一次被技术而非人来跨越——研发工程师不需要学会运维工具,就能获取运维洞察;运维团队不需要替研发查日志,诊断能力通过 Qoder 与 STAROps 插件变成了人人可用的基础设施。
这是 Dev 和 Ops 之间信息壁垒被打破的第一步。对研发工程师来说,不用再做信息传声筒,写代码时就能感知生产状态,故障排查从小时级压缩至分钟级。对运维团队来说,可大幅减少重复查数、基础排查工单占用的精力,把时间释放出来聚焦架构优化、稳定性体系建设等高价值工作。当研发和运维共享同一套生产上下文,不仅故障恢复会更快,那些"同样的坑反复踩"的问题也会越来越少——最终实现整个技术团队效率与稳定性的双向提升。
可直接前往 qoder.com 下载 Qoder,3 分钟完成配置,立即体验 IDE 内一句话排查线上问题。现在注册即可领取 STAROps 10000 积分,把生产环境的诊断能力直接装进你的 Qoder。