也许你也曾经遇到过这样的场景:线上突发故障,你顺着线索一路排查,终于锁定了一个随新版本上线、包含关键信息的日志字段。但点击查询时,系统却提示:“该字段未配置索引,无法进行分析”。
在半结构化日志日益普及的今天,写入端可以灵活扩展字段,分析端却仍然依赖预先配置的索引。每次发版带来新字段,都要手动补索引,对于历史数据可能还要再等待索引重建。这使得“写入的灵活”并没有完全转化为“分析的便利”。
AI Agent 的兴起,则让这个矛盾更加突出。Agent 在执行任务时会动态生成新的日志字段,在多轮“推理—检索”中也会根据中间结果不断调整查询分析路径。这些字段和分析需求都在运行时产生,难以提前预设,也无法每次都依靠人工实时跟进索引配置。
为此,阿里云日志服务 SLS 推出自动发现字段索引功能,让索引具备自适应数据变化的能力,自动为新写入的字段创建索引并开启统计,无需手动干预。无论是开发运维人员还是 Agent,都无需逐个配置字段索引,就能使用新字段进行分析,从而实现数据的开箱即用。
一、手动维护索引,越来越难跟上变化
字段很难在接入时一次确定
通过字段索引进行日志查询和 SQL 分析,通常需要先确定字段,再配置索引。当日志结构稳定、查询需求明确时,这套方式很容易落实。
但实际业务中的字段往往是逐步增加的。应用升级会带来新的观测信息,接入不同数据源会引入新的日志结构,还有一些字段只在特定条件下出现。接入时看到的日志样本,很难覆盖后续所有数据。
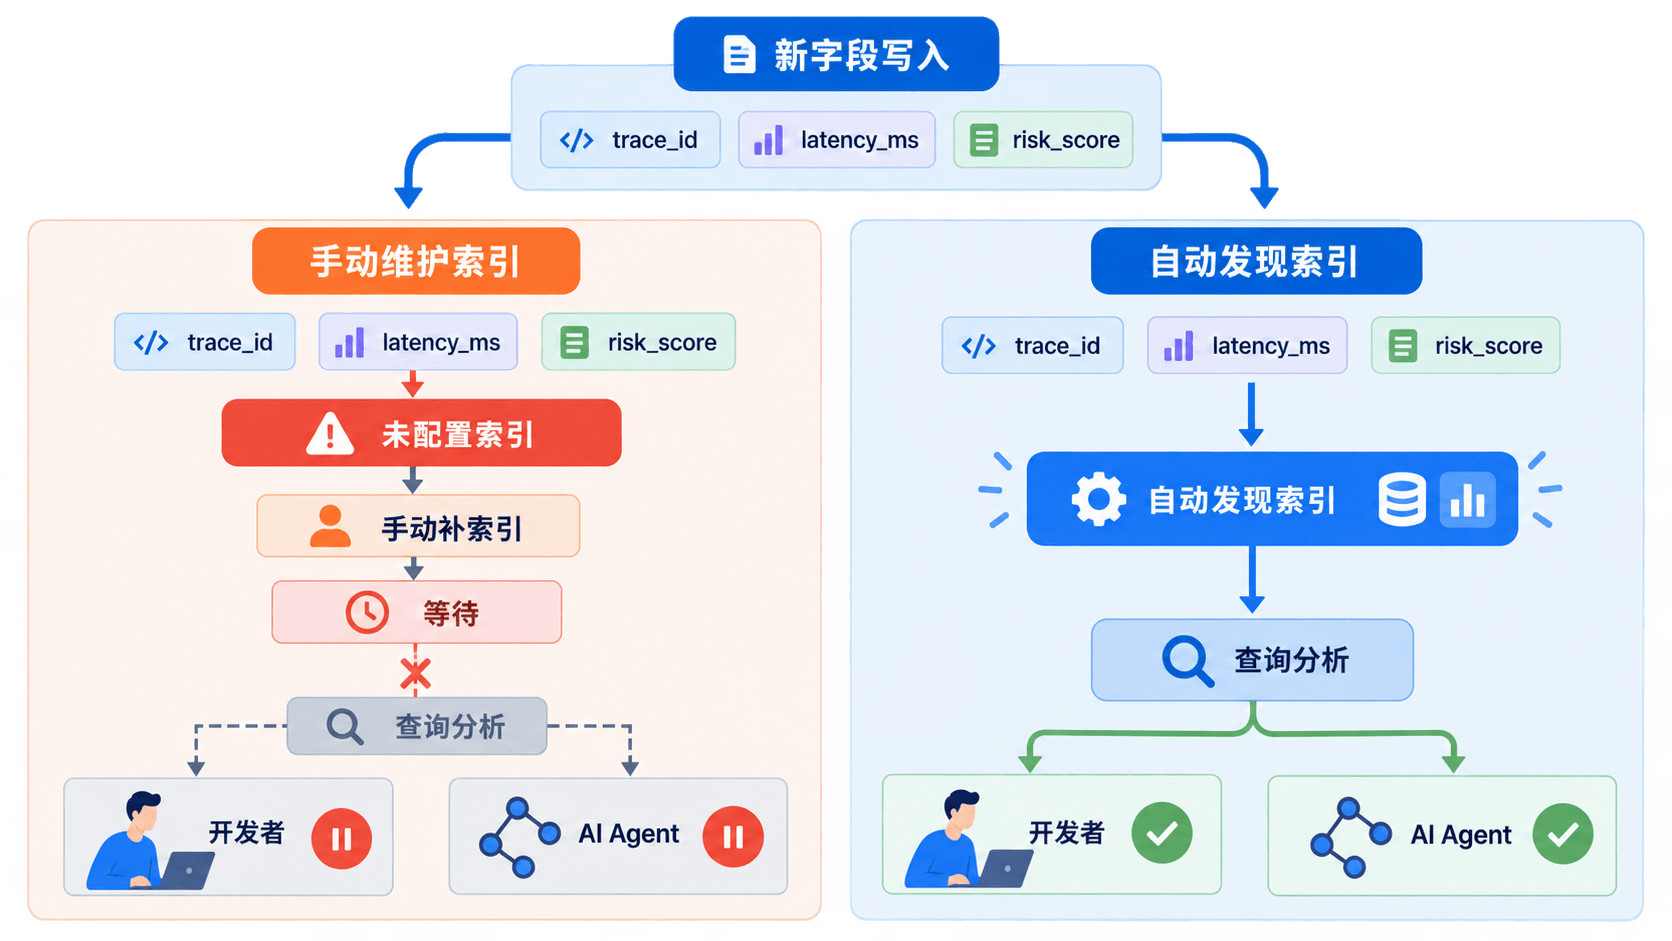
于是,维护索引也成了一项持续的工作:每次新增字段,都要考虑是否需要查询、是否用于分析,以及相应的索引是否已经配置。业务变化越快,这项工作就越难做全。
用到字段时,才发现还没有索引
字段有没有索引,往往到真正使用时才会被注意到。新的查询需要增加一个过滤条件,统计需要换一个分组维度,却发现对应字段还没有建立索引。
此时再添加索引,分析就要等待;如果还需要覆盖已经写入的历史数据,则可能需要重建索引,当历史数据量较大时,等待的时间也会被拉长。
数据已经存在,却不能马上分析。原本可以继续深入的问题,卡在了索引准备这一步。
Agent 让日志字段和查询需求更难预先确定
当日志由 Agent 生成和写入时,日志内容会随着任务、工具调用和执行结果变化。不同任务可能记录不同的字段,执行过程中也可能增加新的状态和中间结果,很难在接入之初就完整确定日志结构。
当 Agent 负责分析日志时,分析路径同样难以提前预设。分析过程中,Agent 通过多轮"推理—调用工具—观察结果"推进任务,借助字段检索缩小范围,再通过 SQL 完成聚合、排序和对比。每一轮结果又会决定下一步查询哪些字段、验证什么假设,查询需求随着推理过程动态产生。
如果分析过程中发现字段没有索引,就可能需要暂停查询,等待索引补建或重建,甚至由人工介入处理,打断原本连续推进的推理与工具调用。
二、SLS 自动发现索引:新字段自动建索引,无需逐个配置
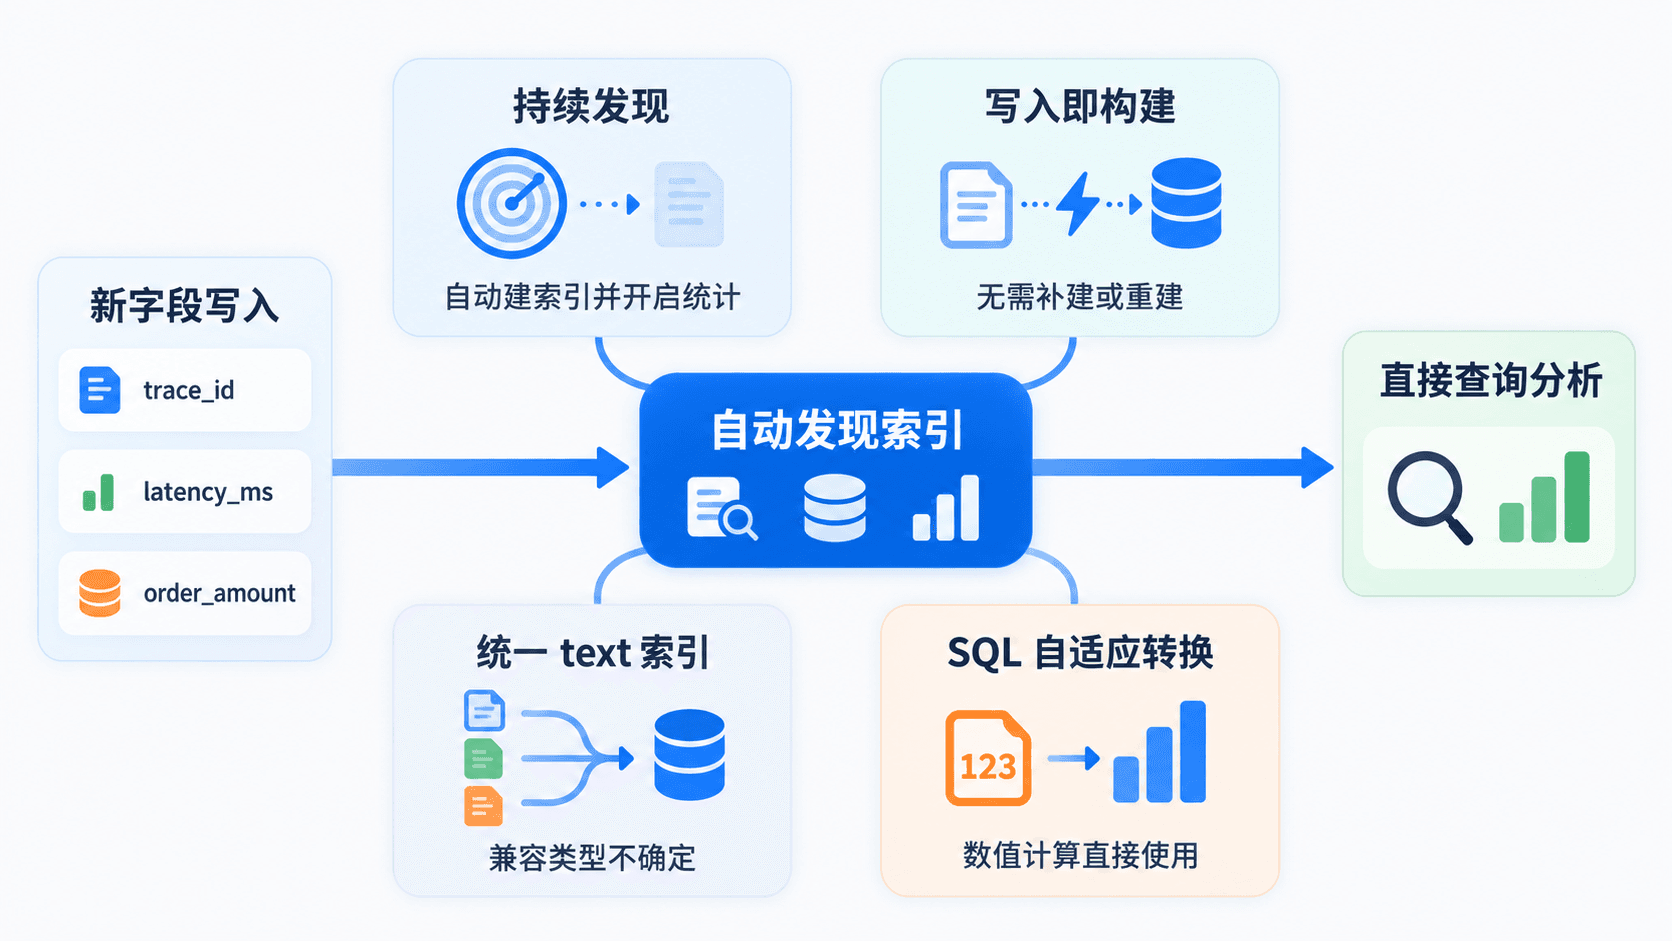
开启自动发现索引后,SLS 会在数据写入时自动识别未配置索引的新字段,为其构建索引并更新索引配置。
持续发现:自动创建索引并开启统计
自动发现索引会持续检查新写入的日志。遇到尚未配置字段索引的顶层字段时,SLS 自动为其创建字段索引并开启统计,使其能够参与字段查询和 SQL 分析。
这项能力会随着日志写入持续工作。应用后续增加的字段、不同数据源带来的字段,以及接入时尚未出现的字段,都可以在实际写入时被发现,无需每次新增字段后再手动补充配置。
对于应用开发者,新增日志字段时少了一项同步维护工作;对于数据使用者,分析时可以直接使用这些新字段,自由调整查询条件和统计维度。
写入即构建:无缝覆盖配置可见前的数据
开启自动发现索引后,SLS 会在日志写入时立即为新字段构建索引。索引构建与字段配置的生效是两个独立的过程——构建会随写入立即开始,配置可见需要一定的同步时间。
这意味着,在配置尚未可见的这段时间里写入的数据,索引同样会被构建。待配置生效后,这部分数据可以直接用于查询和分析,无需补建或重建索引。
统一按 text 建索引:兼容类型不确定的字段
在自动发现字段时,仅凭字段首次出现时的值,很难准确判断其真实的业务类型。例如,某新字段写入的第一条日志值是 123,看似是数值,但后续写入的完全可能是 abc(例如随机 ID)。如果贸然在首次探测时将索引类型固定为数值型,后续遇到非数字字符时就会面临类型冲突。
为此,SLS 对自动发现的字段统一采用 text 类型建立索引。这种高兼容性的设计能够包容各种格式的字段值,确保任何格式的新字段都能顺利写入并生成索引,避免因类型判断不准而导致的冲突与漏建。
SQL 类型自适应转换:免去类型声明
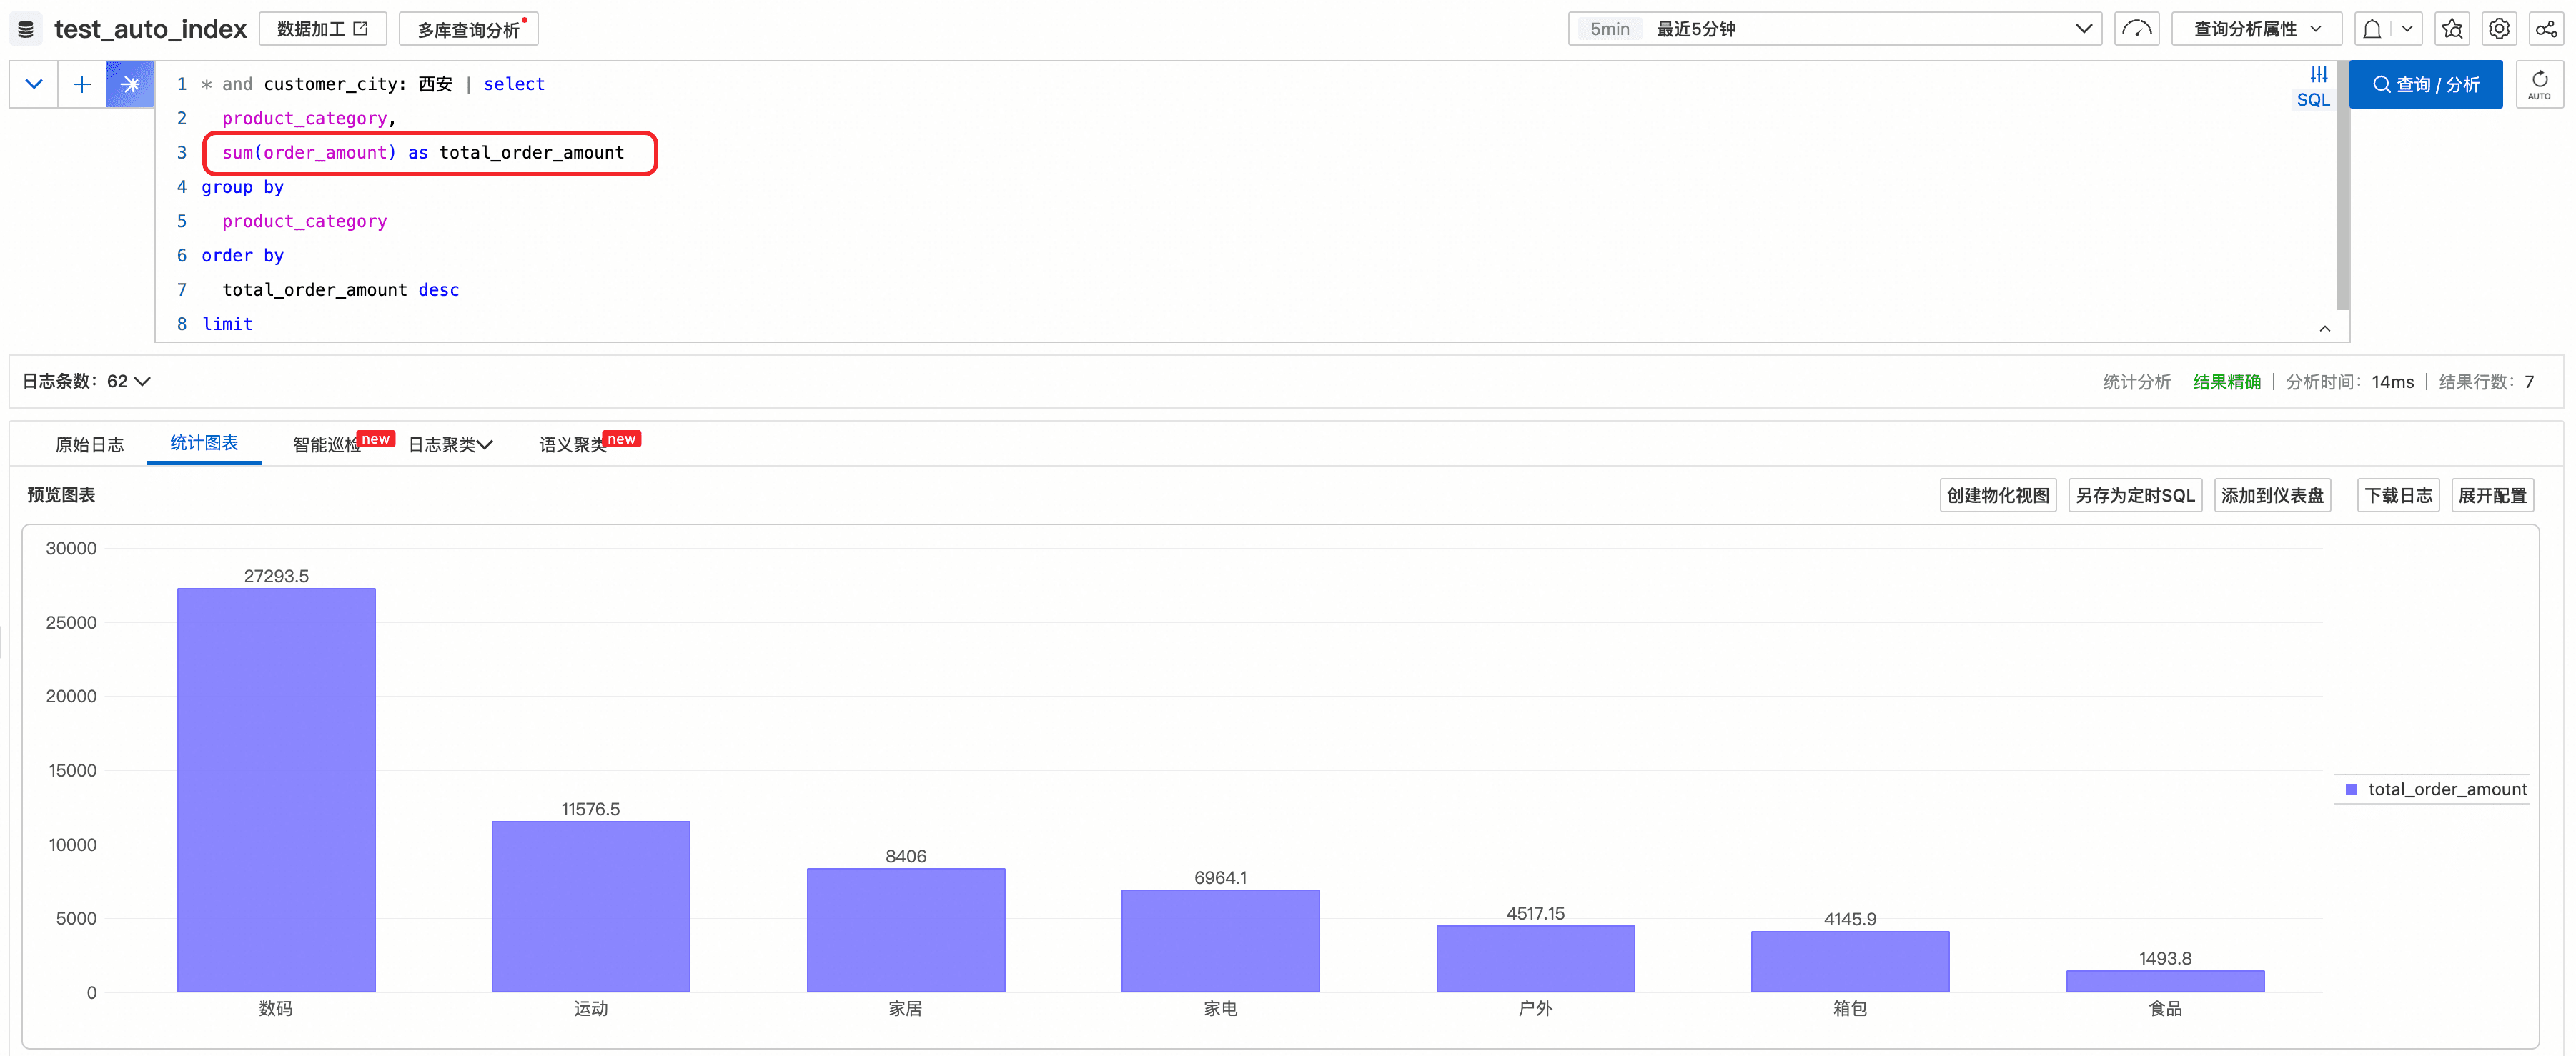
虽然底层统一以 text 类型存储,但这并不影响数值类计算的便利性。在进行 SQL 分析时,针对自动探测出来的字段,SLS 引擎在遇到数值类表达式时,会自动在运行时将字段值转换为数值类型。对于无法转换为数值的值,会自动跳过。相当于将 sum(x) 自动转换为 sum(try_cast(x as double))。
这样,通常情况下,无需专门将自动探测出的字段改为数字类型,就可以直接按照数字类型去写 SQL,使用起来更加方便。
三、如何开启和使用自动发现索引
在控制台开启自动发现索引
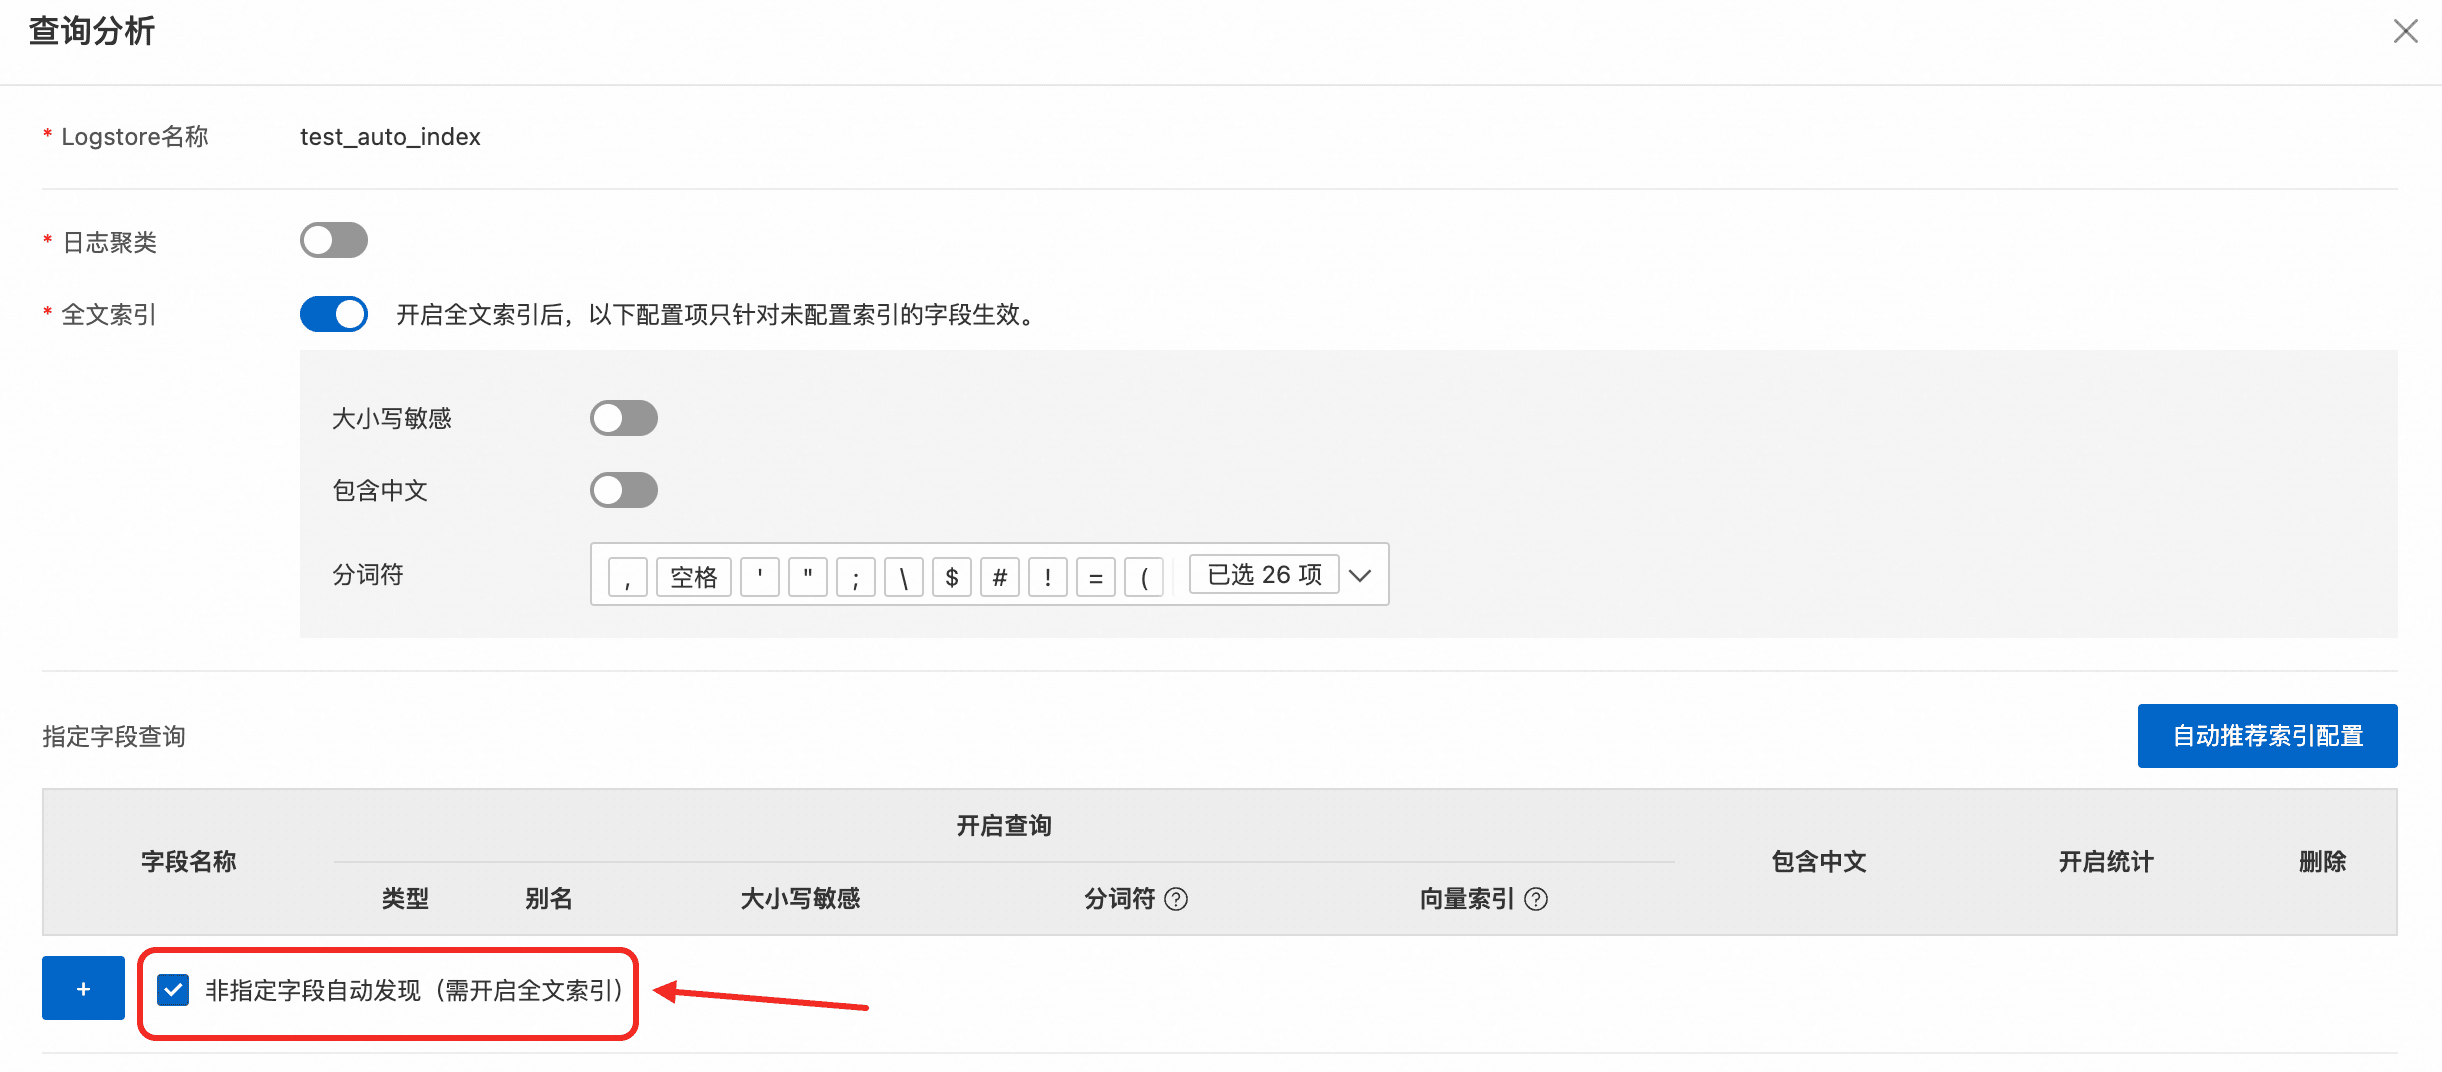
进入目标 Logstore 的索引配置页面,确认全文索引已开启,勾选“非指定字段自动发现(需开启全文索引)”并保存,即可开始持续发现新写入日志中的字段。
控制台开启入口按账号分批开放中,如果暂未被灰度到,可以提交工单联系开启白名单。
查看自动发现的字段
开启后,继续向 Logstore 写入日志。新出现的字段会自动建立索引,随后可以在索引配置页面的“自动探测字段”区域查看。
这些字段索引的类型都是 text 类型,分词符、是否大小写敏感、包含中文这些属性,和全文索引相同,并且默认开启了统计。
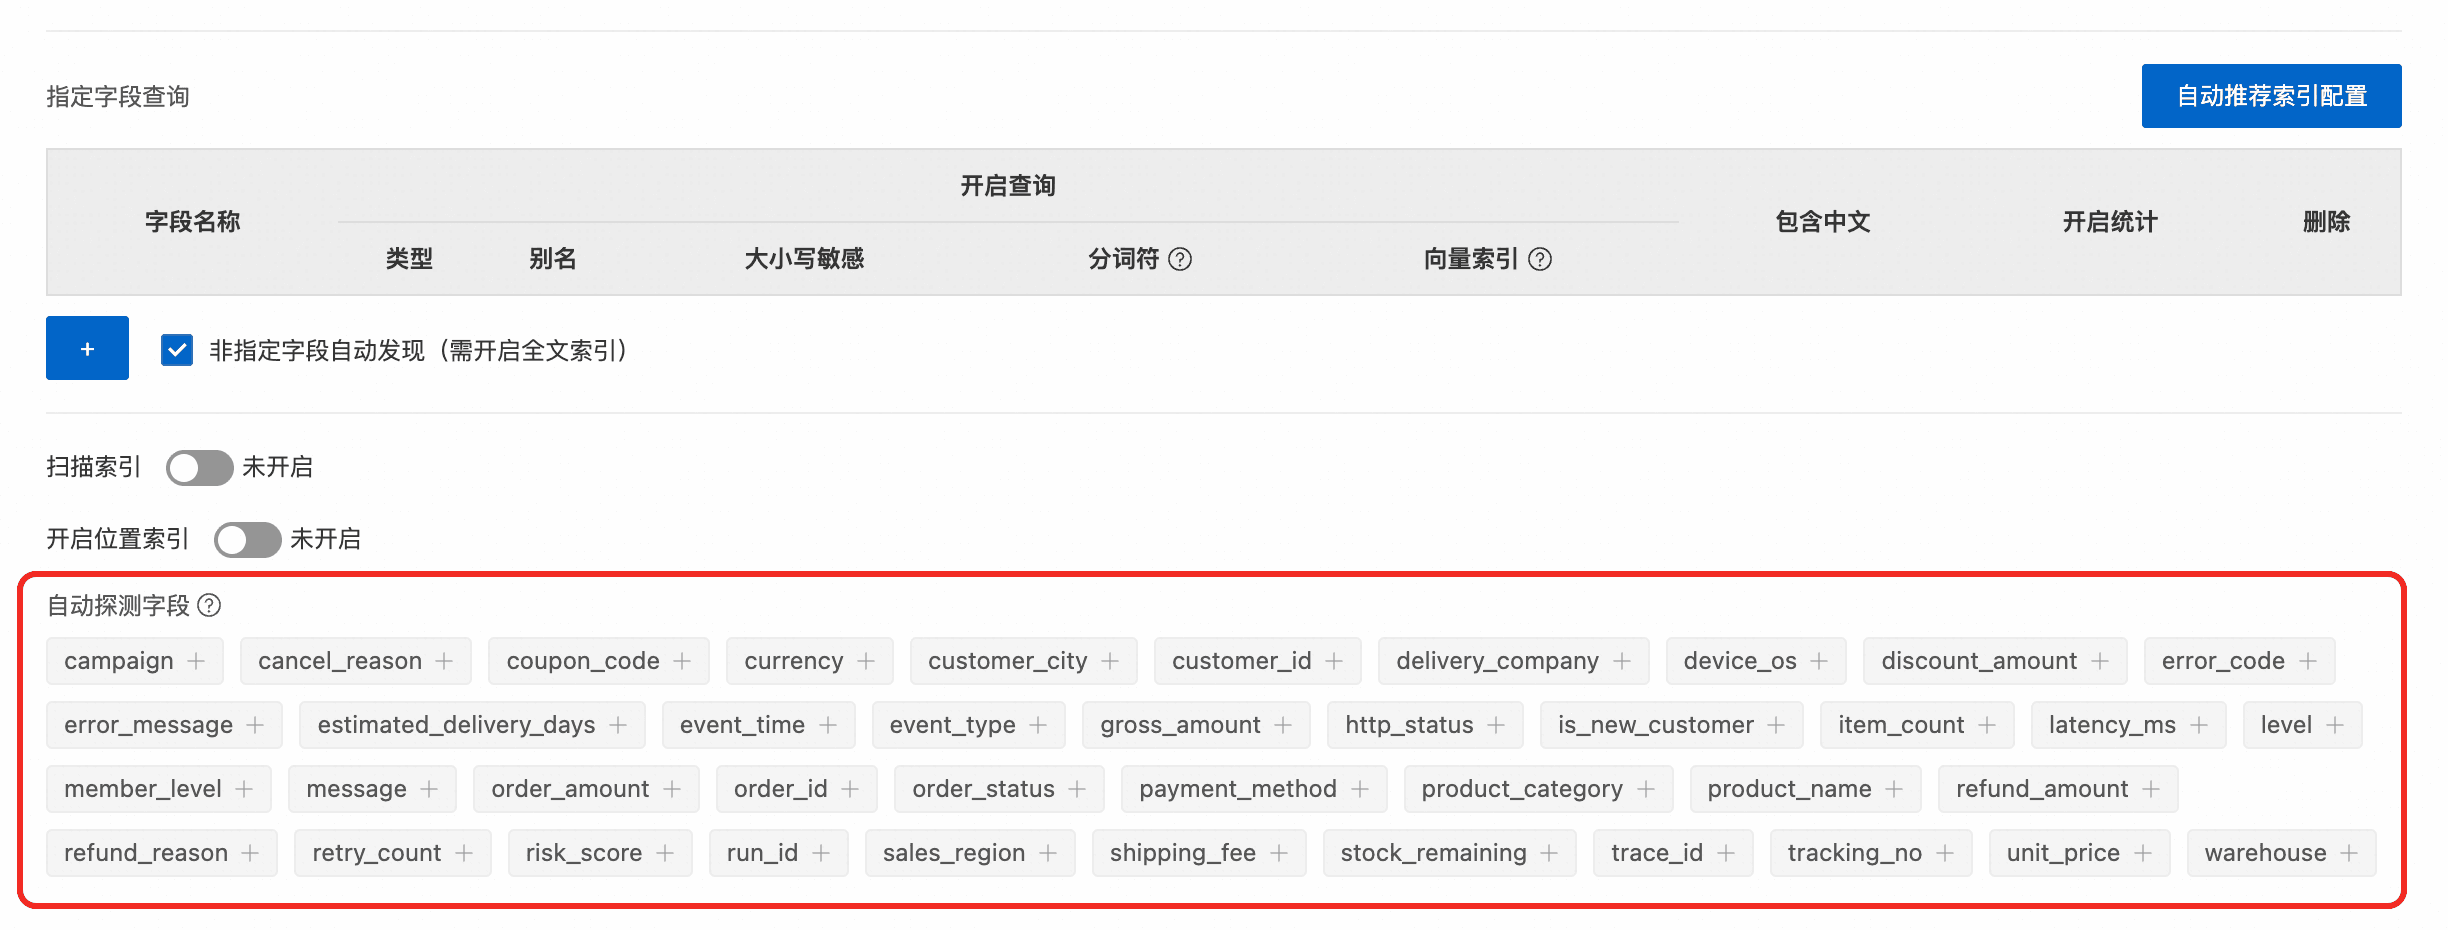
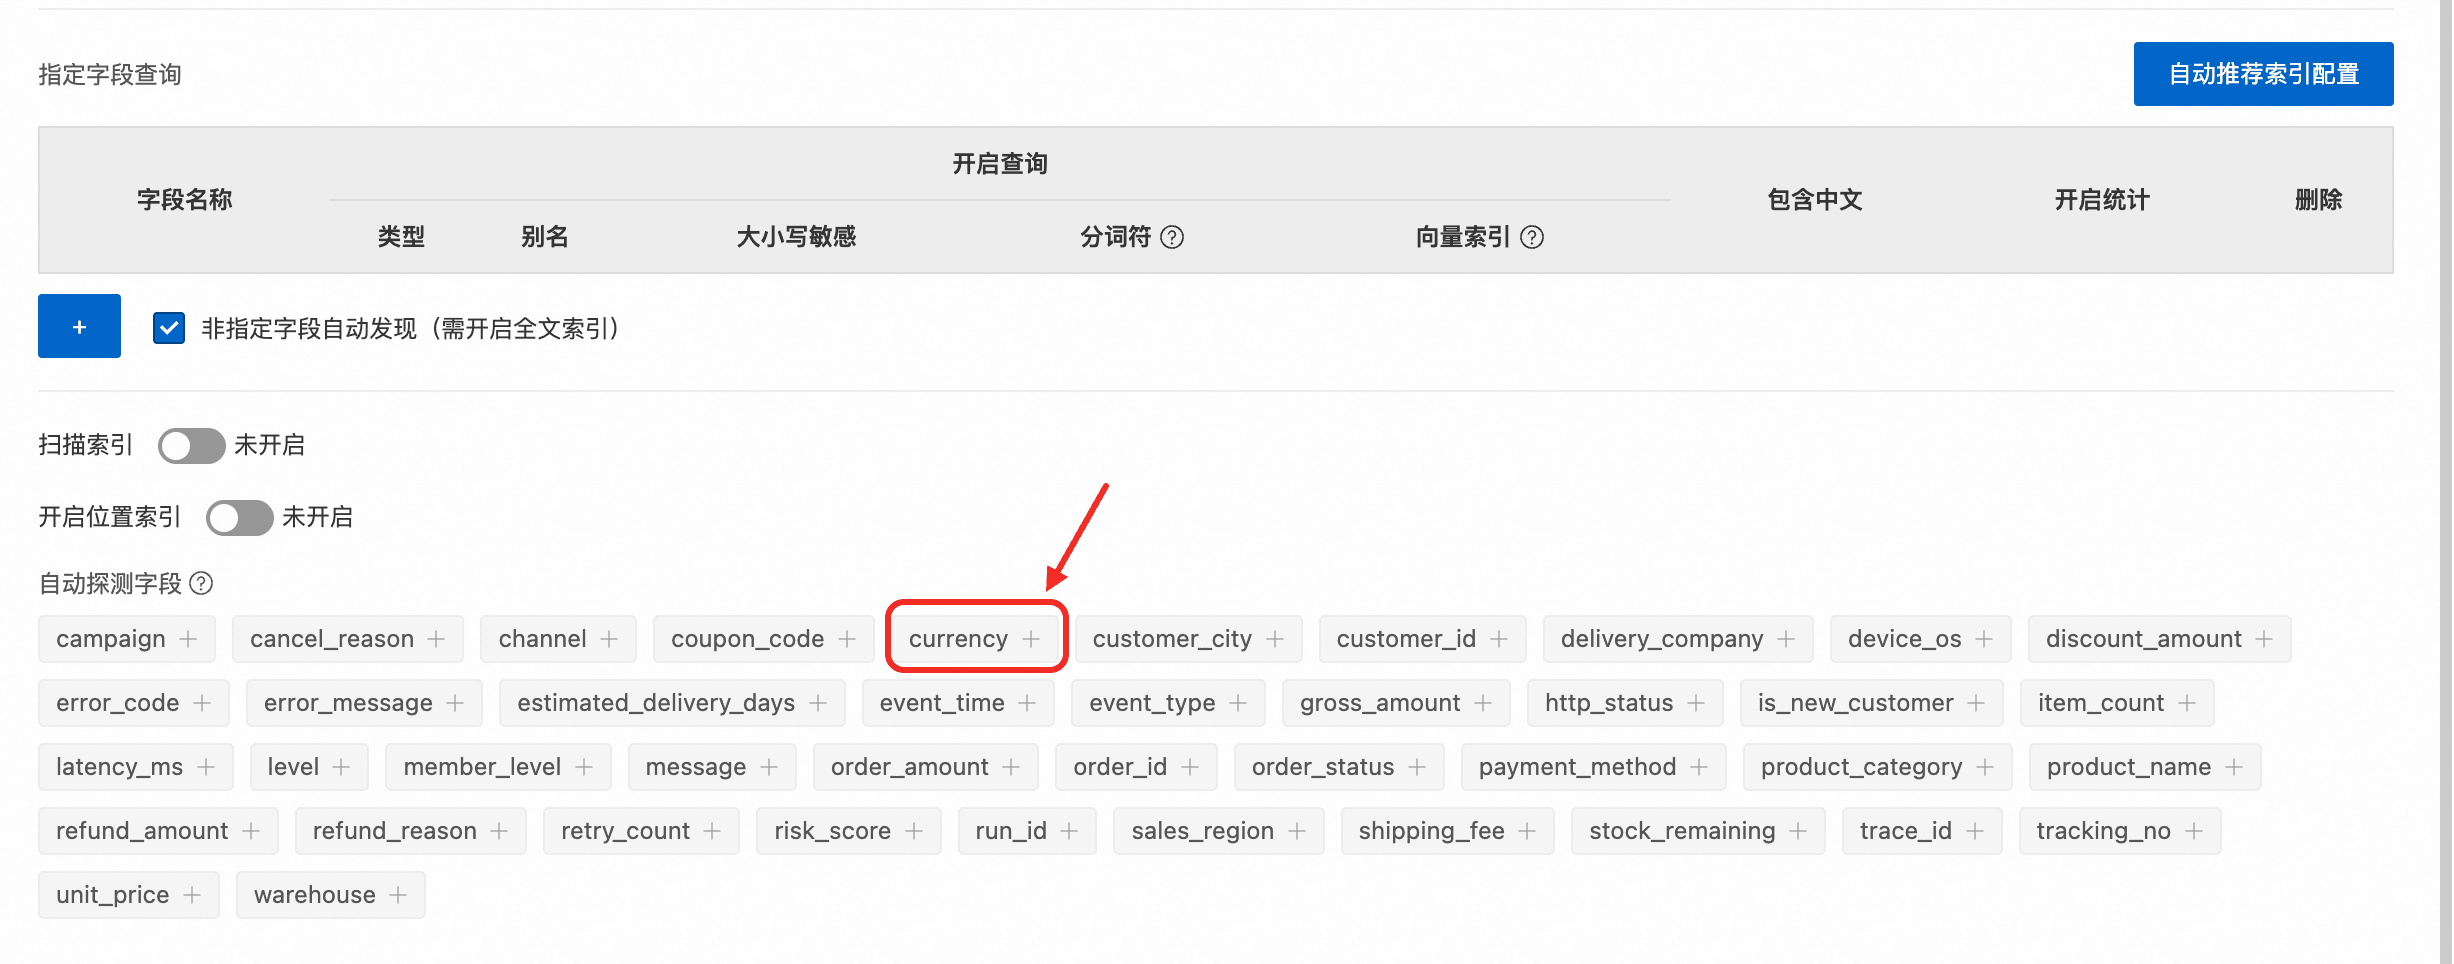
如果需要修改自动探测出的字段属性,可以点击字段上面的 + 号,提升为手动配置字段,然后再进行修改其相关属性。
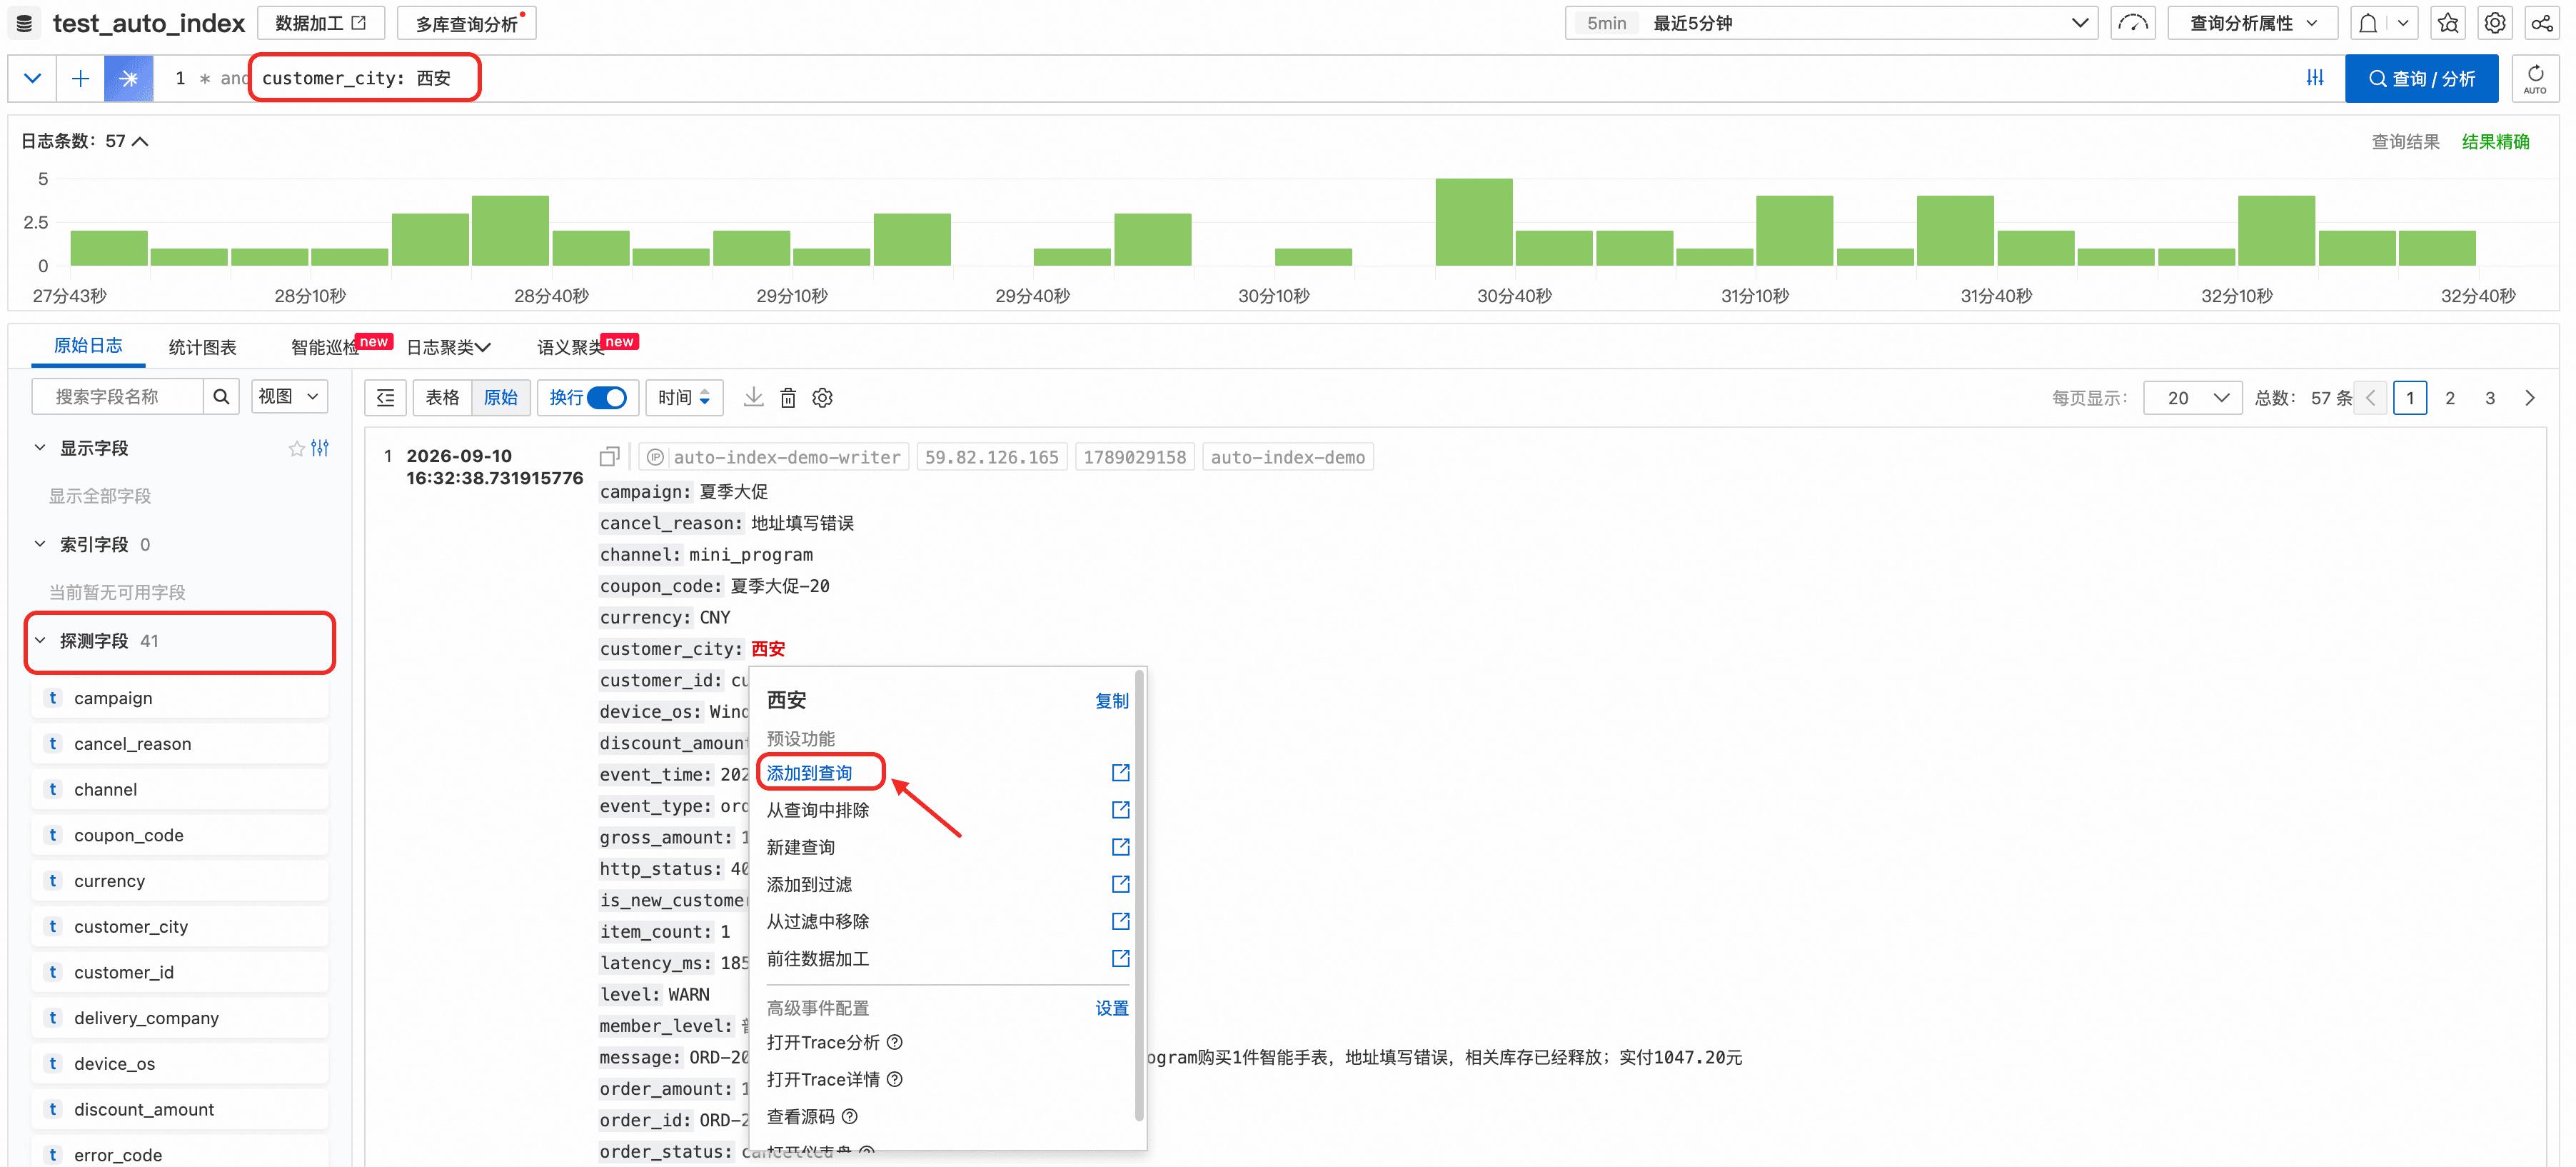
使用自动发现的字段进行查询分析
待字段配置可见后,就可以在日志查询界面使用这些自动探测字段,进行字段查询、快速分析和常规 SQL 分析,使用方式与手动创建的字段索引完全一致。
自动探测字段默认开启统计,可以进行 SQL 分析。自动探测字段在索引层面是 text 类型,但在 SQL 中也可以直接视为数字类型去使用。
通过 SDK 开启和管理自动发现的字段
SDK 方式已经全地域支持,无需添加白名单即可使用。
在索引配置的 json 中,line字段的"auto_key_detect": true 表示开启自动发现索引的能力。auto_text_keys表示自动发现出来的索引字段。
{
  "line": {
    "auto_key_detect": true,
    "auto_text_keys": ["status", "code", "latency"]
  },
  "keys": {
  }
}
SDK 也提供了相关接口来操作,以 python sdk 为例(0.9.52 版本及以上)
from aliyun.log import IndexConfig, IndexLineConfig

#开启自动发现索引
client.create_index(
    project, logstore,
    IndexConfig(line_config=IndexLineConfig(
        token_list=[" ", ",", ";", "\n", "\t"],
        auto_key_detect=True,
    ))
)

#获取自动发现索引相关配置
index = client.get_index_config(project, logstore).get_index_config()
print("是否开启自动发现:", index.line_config.auto_key_detect)
print("已发现的字段:", index.line_config.auto_text_keys)关于自动发现索引的更多配置细节、使用限制、常见问题等说明,请参考官网文档。
四、总结
随着 AI Agent 深度参与到任务规划与问题分析中,底层数据系统正迎来一次角色转变:查询需求不再能够被提前预设,而是在运行时动态产生的。
为了支撑这种高频、不确定的探索,现代数据系统不仅要利用弹性容量和高效检索,去处理大模型无法直接消化的大规模数据,更要把字段识别、索引构建等前置工作自动完成,减少分析过程中的等待与人工干预。
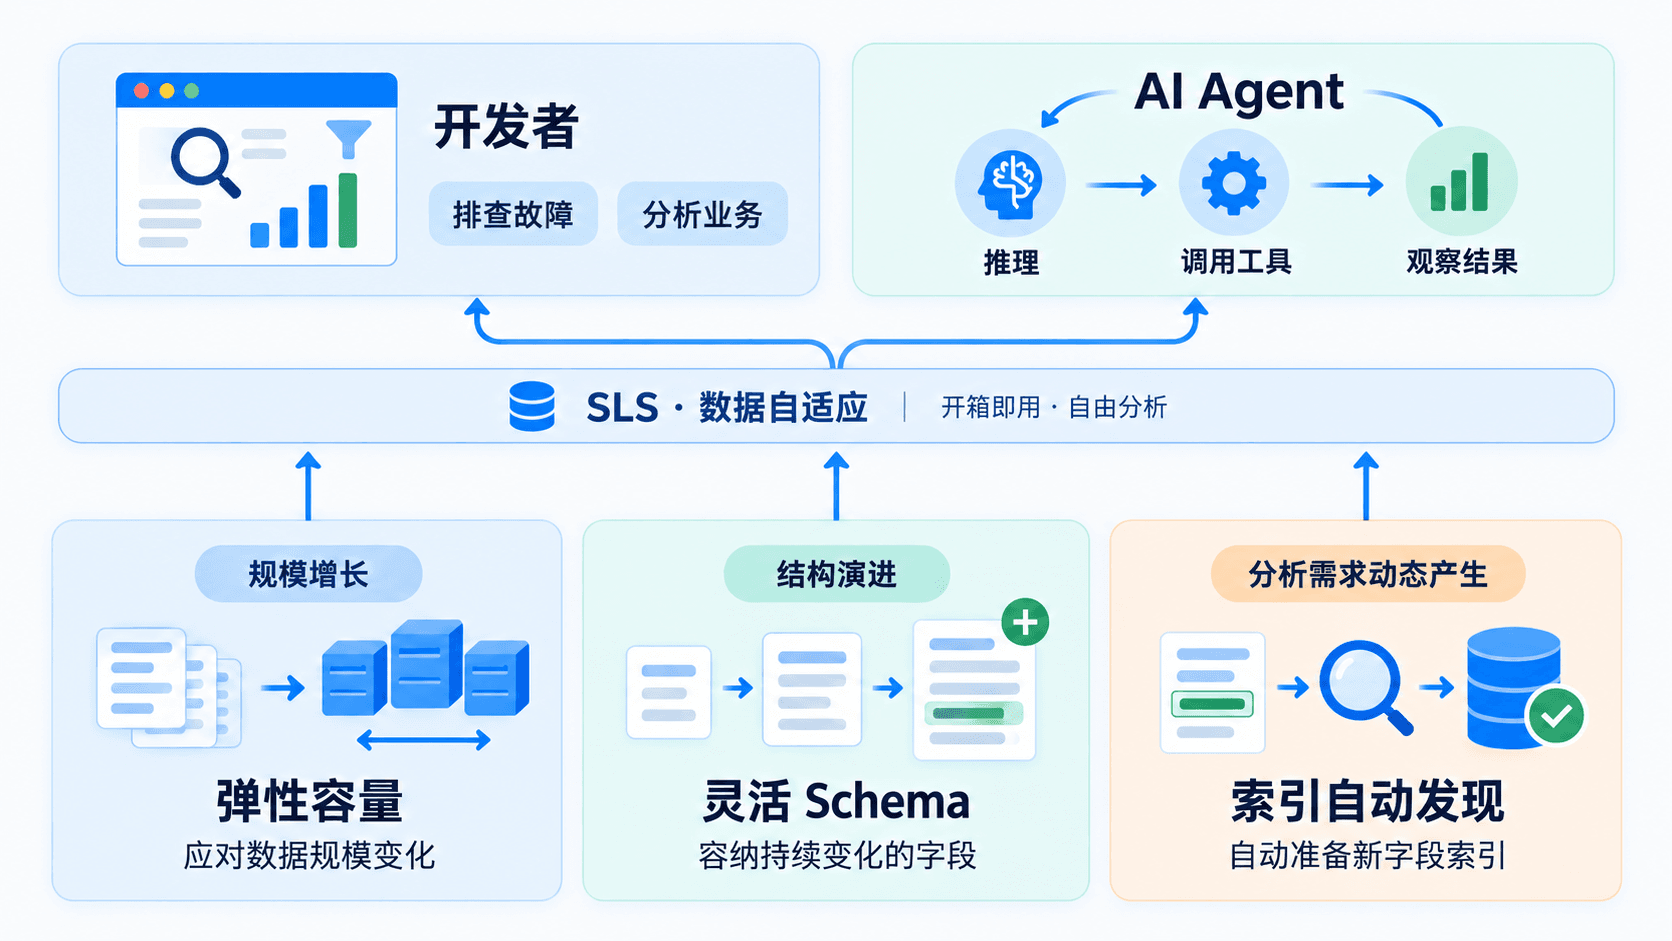
自动发现索引正 SLS 沿着“数据自适应”方向迈出的一步。弹性容量应对规模变化,灵活 Schema 允许结构演进,而索引自动发现则保证了新增字段的即时可用。
当底层配置不再成为探索的限制,无论是开发者还是 AI Agent,都能更纯粹地专注于业务问题本身,真正实现数据的开箱即用与自由分析。