周五晚上 21:47,小陈的钉钉又响了。
告警标题很短:checkout 服务 P99 延迟超过 2 秒。这是结算链路的核心服务。晚高峰一旦抖一下,客服群里很快会出现「怎么付不了款」。
小陈没有先打开五个控制台。他看了一眼屏幕上的 Cursor,那边已经接上云监控 MCP。他对 Agent 只说了一句:
「看看刚才 checkout 怎么了。把根因查清楚,监控有缺口就补上。」
二十分钟后,值班群里出现一条结论:延迟来自下游支付网关,基础设施事件没有对应异常;错误率告警已经补上。
这二十分钟里,真正发生变化的不是模型突然「懂了可观测」,而是它第一次能够按云监控的真实操作面去调查、去验证、去修改——而且不必先在这台值班电脑上把 CLI 环境齐套。
先把两样东西说清楚
大模型很会推理,也擅长把现象串成假设。它进不了云账号,看不到 Prometheus 里的曲线,改不了告警规则。缺的不是另一段更长的提示词,而是一套能被安全调用的工具。
MCP(Model Context Protocol)就是这套约定:模型负责理解目标和选择下一步,工具负责真正去执行。可以把它理解成给 Agent 发放的工牌和工具箱——没有工牌,模型只能隔着玻璃窗做分析;有了工牌,查询告警、跑 PromQL、拉调用树、补规则,才成为一次次可审计的云上操作。
阿里云此前已经发布了云监控官方 CLI:aliyun cms2。它把云监控 2.0 的查询与管控收成一棵命令树。这棵树本来就面向 Agent:命令契约稳定,输出是结构化 JSON,失败就是失败,凭证走 RAM 与阿里云配置链。终端里可以手敲,脚本和 CI 可以调用,Cursor、Claude Code 也可以在本地直接 exec:
aliyun cms2 alert history list --workspace prod-ecommerce
aliyun cms2 metric promql query-range --prometheus-id pi-xxx --query '...'本地这条路的成本不在命令本身,而在执行环境。调用方要自行准备:二进制已安装且版本匹配、身份已写入 aliyun configure 或环境变量、进程有权限拉起子进程、网络能达到云监控 OpenAPI。值班本人的笔记本上往往齐套;换一台没装 aliyun cms2 的机器、或 Agent 跑在不带云凭证的沙箱里,会话就会断在「找不到命令」或「没有配置」。
云监控 MCP 不是另做一套「给 AI 用的 API」。它把同一棵命令树里的叶子命令,一一投影成 MCP Tool。alert rule list 对应 alert_rule_list,metric promql query-range 对应 metric_promql_query_range。权限模型、失败语义、审计对象与 CLI 相同。差别不在「谁可以使用」,而在执行发生在哪里:CLI 在 Agent 本地(或调用方自备的运行环境)里执行;MCP 把同一棵树挂到远程端点上,Client 连上即可 tools/list / tools/call,工具自带 schema,不必在每台 Agent 宿主机上安装 CLI。
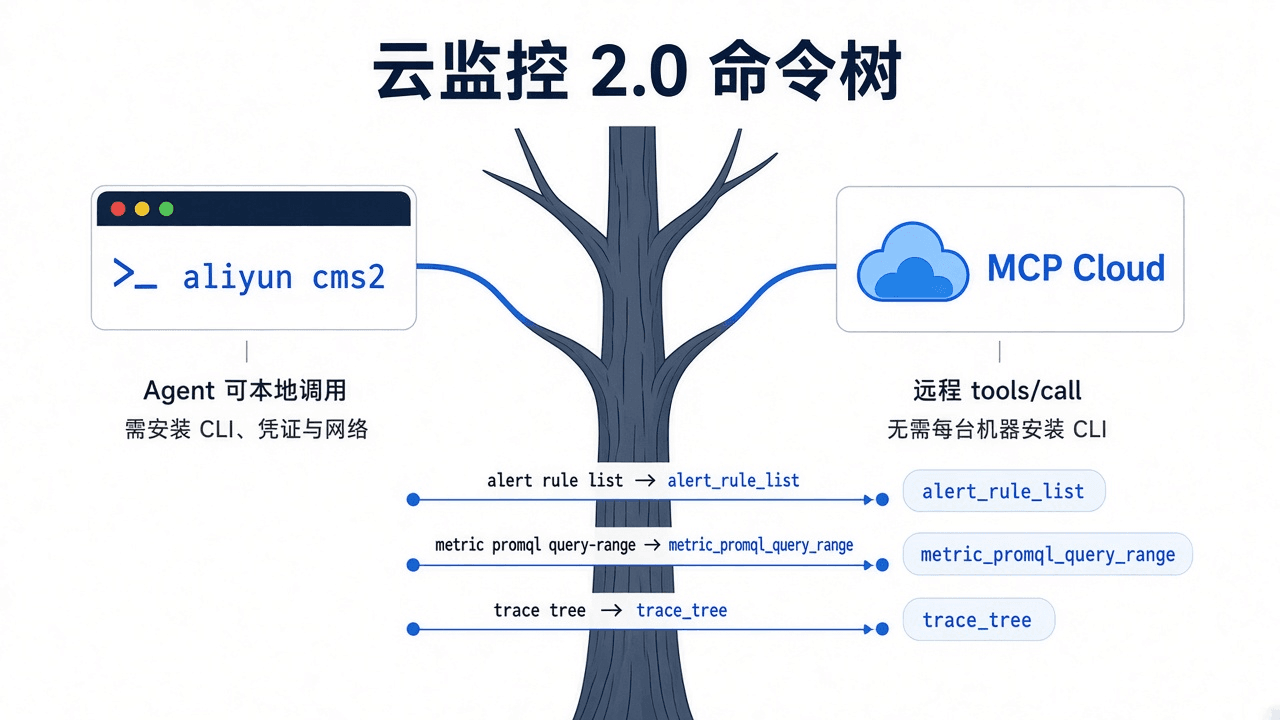
小陈上个月试过让 Agent 调本地 aliyun cms2。自己电脑上能跑通;结对值班的同事没装插件,profile 也不一样,只好退回控制台。今晚 Cursor 里接的是 MCP 远程端点,环境收敛在服务端,值班换机器不再先排一轮安装问题。
21:47,checkout 抖了一下
工作空间叫 prod-ecommerce。小陈值班多年,对这条告警并不陌生。控制台时代,路径是翻告警、切 Prometheus、搜链路、回规则页。CLI 把这些动作收成命令之后,准确、可重复;Agent 在环境齐套时同样能一条条调用。真正耗时的是探索本身——看完这一步,才知道下一步该调哪一类工具——以及执行环境是否还在。
今晚环境已经不是问题。他把目标和权限交给 Agent,让工具顺着证据往下走。
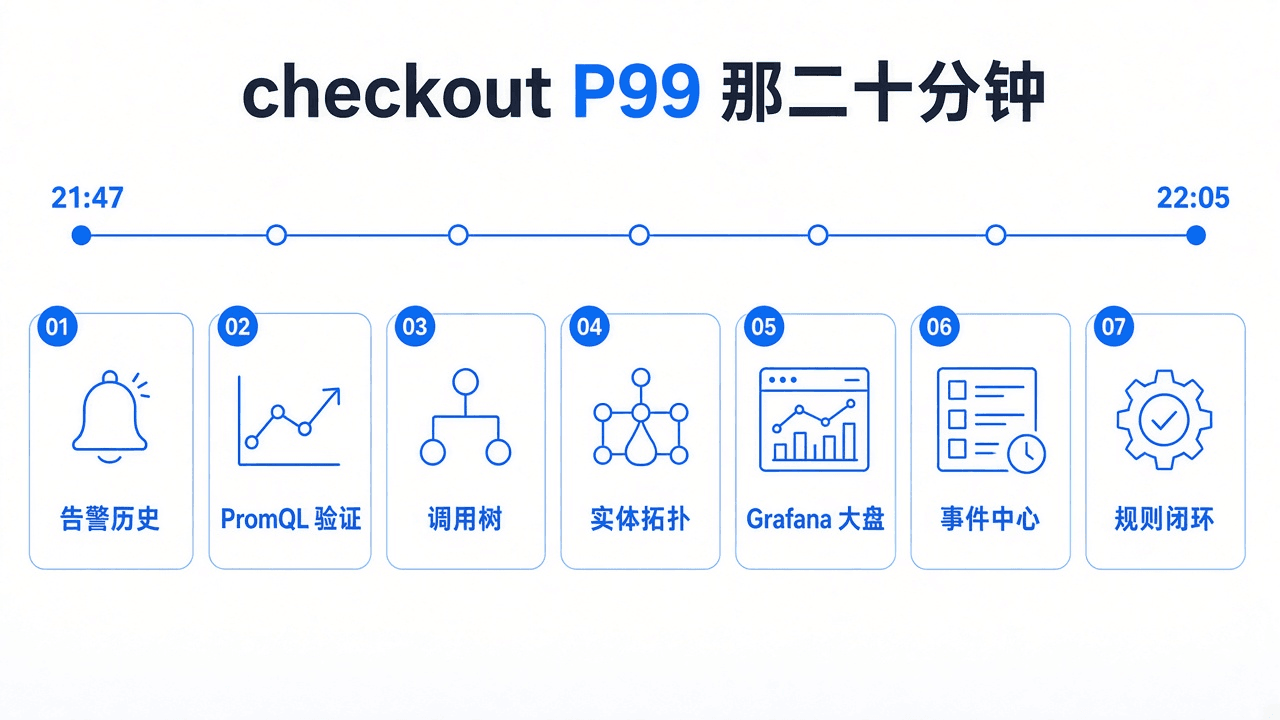
先确认响的是谁。 Agent 调用 alert_history_list,按工作空间、严重级别和时间过滤,定位到规则 checkout-p99-latency。接着 alert_rule_get 把规则全文拿出来:监控的是 checkout 接口 P99,连续 2 分钟大于 2 秒,通知打到值班群。到这里,现场不再是一句「又超时了」,而是一条可核对的定义。
再看曲线,避免被标题带着跑。 Agent 确认 Prometheus 实例后,调用 metric_promql_query_range,拉近 1 小时的 P99 和 5xx 错误率。延迟从 21:40 抬升,错误率几乎没动。问题形态是「变慢」,不是「开始大面积失败」。小陈在群里见过太多先改代码、后发现只是依赖抖动的夜晚,这一步把方向扳了回来。
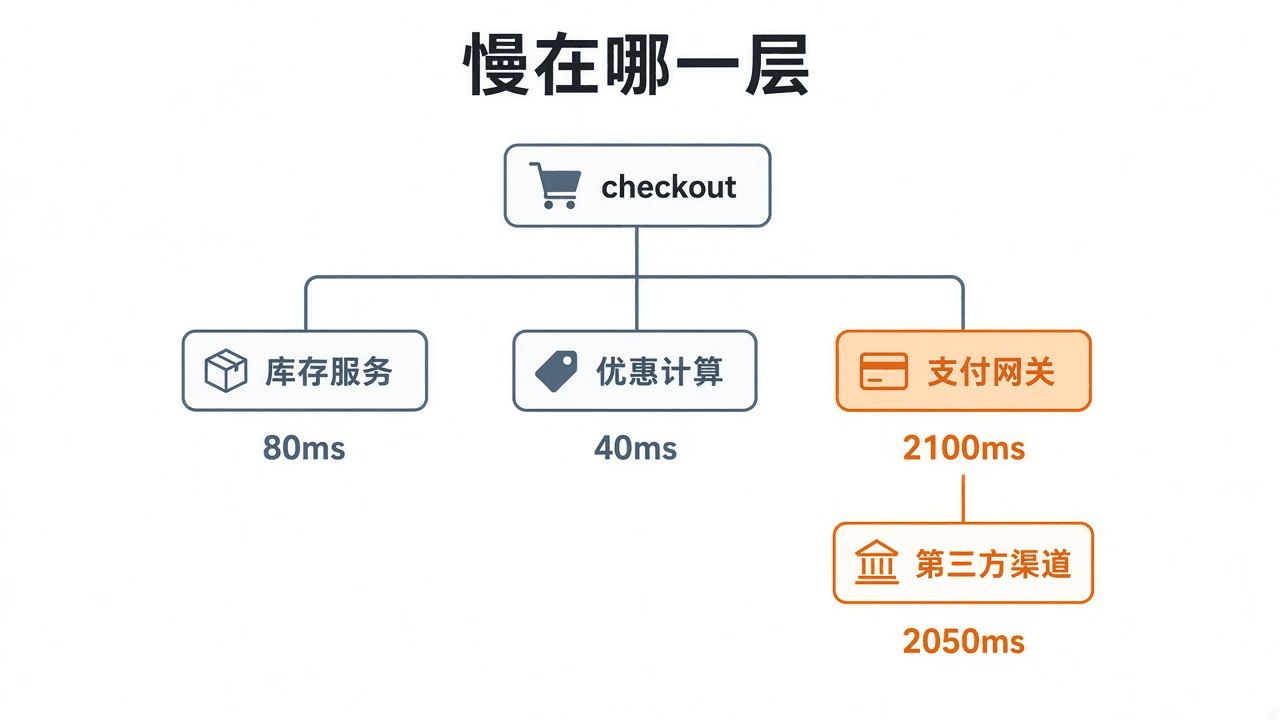
然后去链路里抓一只慢乌龟。 trace_search 按时间窗和服务名找出耗时超过 2 秒的 Span;再拿一条 Trace ID 调用 trace_tree。调用树比曲线更「说话」:
checkout
 ├─ 库存服务     80ms
 ├─ 优惠计算     40ms
 └─ 支付网关    2100ms
      └─ 第三方渠道  2050ms
根因候选一下子收窄:不是 checkout 自己算得慢,是下游支付把整个结算拖住了。
再用实体和大盘做两道交叉验证。 entity_query 核对 checkout 在生产环境里的依赖,避免看错服务名、看错环境。grafana_dashboard_search 找到 checkout-overview,grafana_dashboard_panel_queries 抽出 Panel 查询,和刚才的 PromQL 对上。为了排除「整台机器、整片网络在抖」,event_hub_list 查了同一时间窗的云产品事件,没有对应的 ECS / SLB / RDS 异常。
到这里,证据已经够写进值班群。小陈多问了一句:
「只有延迟告警不够。补一条 checkout 5xx 错误率连续 2 分钟大于 1% 的规则,通知还是值班群。」
Agent 调用 alert_rule_create。若只是把原规则阈值从 2 秒调到 1.5 秒,则走 alert_rule_patch,未指定的字段保持服务端原值。需要再核对值班群机器人时,再去拉通知渠道列表。
22:05,结论发出去了。没有十张截图,也没有再切回控制台确认一遍。
真正要说明的事
云监控 MCP 的核心价值,不是让模型更会写 PromQL,而是把可观测里最耗时的那截——在告警、指标、链路、实体、大盘、事件之间来回取证,并把结果收成一次处置——收进同一段会话,同时把执行从「每台 Agent 机器自备 CLI 环境」里解放出来。
aliyun cms2 已经解决了操作契约:同一条命令,人可以敲,Agent 也可以敲,脚本和流水线也可以敲。本地 Agent 走 CLI 时,安装、凭证、网络、版本是调用方的责任。MCP 不改这棵树,只改交付:远程可发现、按产品域裁剪、schema 跟着工具走。排障不是预先写好的十条命令。看见错误率没动,才会去拉 Trace;看见调用树指向支付网关,才会去对实体、对大盘、去事件中心里做排除。工具和 CLI 同源,才保证这段探索的结果可以和终端里的命令对上。
这也是为什么 MCP 仍要受 RAM 约束。只读调查可以用 AliyunCloudMonitorReadOnlyAccess;改规则、改接入必须有写权限。值班身份可以只读;变更走另一套策略。Agent 再能干,也不该拥有操作者自己都不会点的按钮。
小陈没有丢掉 CLI,也没有要求每位同事的电脑都先装好同一套插件。他只是不再把最贵的那二十分钟,花在选择打开哪一个控制台,或先排除一遍本地环境。
核心工具集
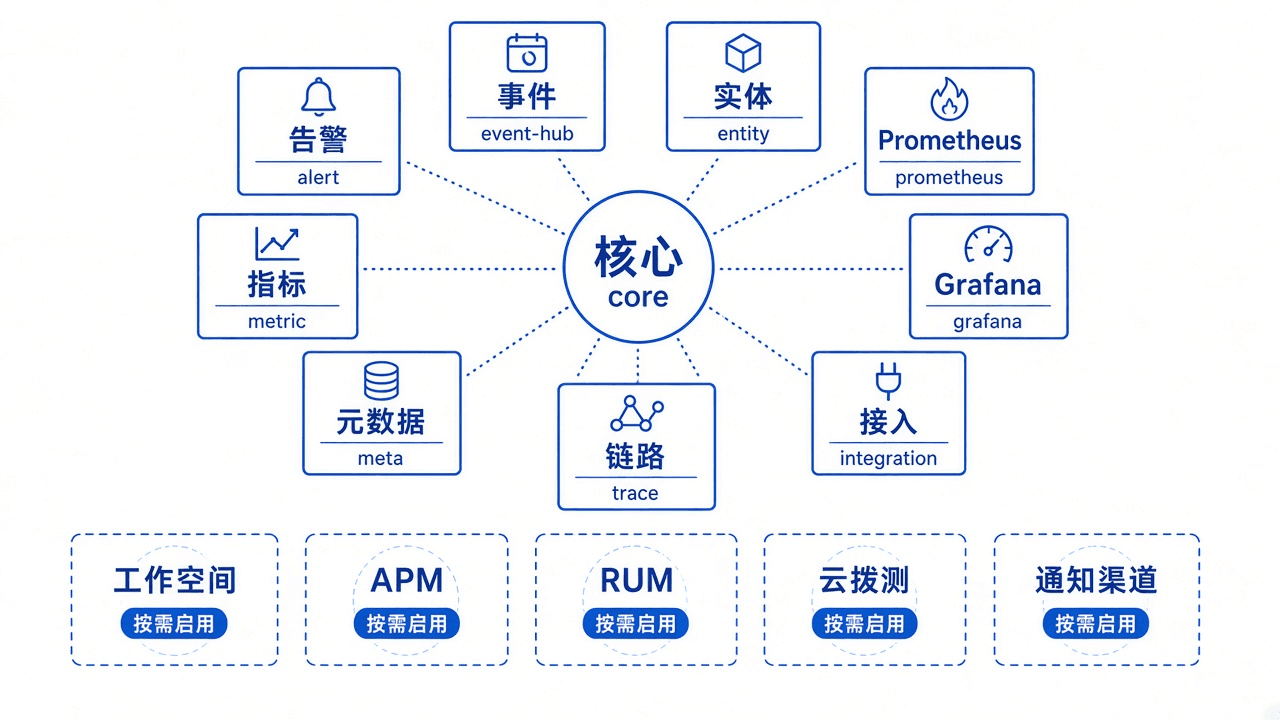
MCP 把叶子命令投影成 Tool 之后,立刻会碰到另一个问题:全量大约 191 个工具。一次性交给模型,上下文会被工具描述占满,Client 也常有工具数量上限;更关键的是,一次排障并不需要「删除工作空间」或「创建拨测任务」这类能力出现在可选列表里。
ToolSet 的核心作用,是按产品域裁剪 Agent 在本次连接里能看见、能调用的工具面。 它不是文档目录,而是连接参数上的闸门:调查默认只打开别名 core,建设与高风险操作按需加进 toolsets,也可用 omit_tools 剔除某几个删除类工具。权限仍由 RAM 决定;ToolSet 决定的是模型眼前的菜单有多宽。小陈当晚从告警走到补规则,用的是调查面;若把全量工具一股脑塞进去,既挤占推理空间,也扩大误调用面。
连接参数缺省为 core,包含:metric、meta、trace、alert、event-hub、integration、entity、prometheus、grafana。拨测、APM、工作空间创建等不在默认集合里。小陈从告警走到补规则,对应的就是这张调查面。
| ToolSet | 调查时做什么 | 当晚用到的典型 Tool |
| alert | 查告警历史与规则,创建、补丁更新、启停规则 | alert_history_list、alert_rule_get、alert_rule_create、alert_rule_patch |
| metric | PromQL 即时 / 区间查询;ECS 等云产品基础监控 | metric_promql_query_range |
| meta | 指标名、单位、维度、Namespace、可用地域 | meta_metrics、meta_namespaces |
| trace | 搜 Span、聚合查询、按 Trace ID 组装调用树 | trace_search、trace_tree |
| event-hub | 查云产品事件,定位事件 Logstore | event_hub_list |
| entity | 查服务、实例与依赖,实体健康巡检 | entity_query |
| prometheus | Prometheus 实例、聚合视图、预聚合规则 | prometheus_instance_get |
| grafana | 工作空间、数据源、大盘检索与 Panel 查询提取 | grafana_dashboard_search、grafana_dashboard_panel_queries |
| integration | 集成策略、Addon、采集器与抓取预检 | (当晚未用;接入排障时才会走到) |
core 之外的 ToolSet 面向建设与扩展,而不是每一次排障都要打开:
- workspace / datasource / umodel:工作空间、数据源纳管、实体模型
- apm / rum:应用与前端可观测、探针配置、符号文件
- synthetics:站点监控与探测点
- notification-channel:联系人、钉钉 / 飞书 / 企业微信机器人、Webhook
- resource-watermark:资源水位报表
- aliyun-service / tag / resource-group:开通状态、标签、资源组
列出值班群机器人属于 notification-channel,不在默认 core 中。只开 core 时,创建规则仍可复用原规则上的通知对象;要把机器人名再确认一遍,连接参数写成 toolsets=core,notification-channel。从零创建工作空间、纳管数据源、安装 Addon、配置 APM、创建云拨测,同样是打开对应 ToolSet,不必再换一套协议。
故事之外,入口很短
云监控 MCP 对所有用户使用同一组固定端点,按所在区域选国内或国际即可。推荐 Streamable HTTP(路径以 /mcp 结尾);仅当客户端只支持旧版 SSE 时,改用 /sse。
国内
- Streamable HTTP:https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp
- SSE:https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/sse
国际
- Streamable HTTP:https://openapi-mcp.ap-southeast-1.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp
- SSE:https://openapi-mcp.ap-southeast-1.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/sse
默认调查面可在 URL 后加 ?toolsets=core。需要核对值班机器人时写成 ?toolsets=core,notification-channel。认证走客户端 OAuth 或已有的阿里云身份,不要把 AccessKey 写进会进 Git 的配置文件。
复制给 Agent 的配置指令
把下面整段发给 Cursor、Claude Code、通义灵码等 Agent,即可完成接入。
请把阿里云云监控 MCP 加到当前 MCP Client,不要把 AccessKey 写入配置文件。

这是对所有用户固定的官方端点,按网络选一个:
- 国内 Streamable HTTP(推荐):https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp
- 国内 SSE:https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/sse
- 国际 Streamable HTTP(推荐):https://openapi-mcp.ap-southeast-1.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp
- 国际 SSE:https://openapi-mcp.ap-southeast-1.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/sse

要求:
1. 优先 Streamable HTTP(/mcp);只有客户端不支持时才用 SSE(/sse)。
2. 服务名用 cms 或 aliyun-cms。
3. 默认在 URL 追加 ?toolsets=core;若要列告警机器人,用 ?toolsets=core,notification-channel。
4. 认证用 OAuth 或本机已有的阿里云登录态,禁止把 AccessKey / Secret 写进 mcp.json。
5. 配好后先调用只读工具:列出工作空间,或查询最近的 Critical 告警历史,确认连通。

Cursor 写入 ~/.cursor/mcp.json(国内示例):
{
  "mcpServers": {
    "aliyun-cms": {
      "url": "https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp?toolsets=core"
    }
  }
}

Claude Code:
claude mcp add --transport http aliyun-cms "https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp?toolsets=core"
手动配置(Cursor)
将下列 JSON 写入 ~/.cursor/mcp.json 或项目 .cursor/mcp.json。国际站把 host 换成 openapi-mcp.ap-southeast-1.aliyuncs.com。
{
  "mcpServers": {
    "aliyun-cms": {
      "url": "https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp?toolsets=core"
    }
  }
}
手动配置(Claude Code)
claude mcp add --transport http aliyun-cms \
  "https://openapi-mcp.cn-hangzhou.aliyuncs.com/s/Cms/cms/9fe79ff0bf5748e6923530c5097ec359/mcp?toolsets=core"
不想自建 Agent:云监控 StarOps
MCP 适合已经有 Cursor、Claude Code、通义灵码,或准备把云监控接进自有 Agent 的团队。还有一类需求更直接:不要装客户端、不要写 mcp.json、不要维护本地 CLI 环境,打开控制台就能调查、巡检、出结论。
云监控 StarOps(STAROps)面向这一类用户,提供托管的数字员工,而不是再发一套要自己接线的工具箱。入口在云监控 2.0 控制台:选中工作空间后打开智能运维助手。会话、技能、权限和执行环境都在云上,CLI 以沙箱形态跑在控制台侧,值班换机器不必先排一轮安装。
开箱即可用的能力主要有三类。
- 故障调查。 从一条告警或一句自然语言出发,数字员工关联指标、链路、日志、事件和 UModel 拓扑,做快速调查或深度调查。输入 @ 可引用工作空间里的告警、主机、应用、Pod 等实体,分析从该实体铺开,不必先自己选 Tool、写 PromQL。小陈当晚那句「看看 checkout 怎么了」,在 StarOps 里同样成立,只是对话发生在控制台,而不是自建 Agent。
- 巡检诊断。 长期任务(Mission)支持定时巡检,例如集群每日健康检查、核心服务巡检、运维报表。结果是结构化报告,可对比历史差异,而不是一次性聊天记录。适合「每天都要看一眼、但不想每天自己编排工具」的场景。
- 人在回路。 数字员工使用独立 RAM 角色,和操作者权限分开。「人能点什么」与「Agent 能调什么」可以拆开授权。高危写操作可配人工确认;对话、工具调用与命令行可审计。这和 MCP 侧「只读调查、写操作另授」是同一套云上约束,只是执行托管在 StarOps,而不是客户自己的 Client。
三条路径可以同时存在,按场景选用:终端和流水线继续用 aliyun cms2;自建 Agent 接云监控 MCP;不想自建时,用云监控 StarOps 的托管数字员工做故障调查与巡检诊断。操作面仍是云监控 2.0,变的是谁来持有 Agent。
故事最后
小陈把结论发到群里之后,支付同事拿着诊断报告,去查渠道延迟,新增监控规则在下一分钟开始生效。这就是云监控 MCP 想接住的东西:不是替代 SRE,也不是替代 CLI,而是让 SRE 的判断,能够立刻落在云监控真正的操作面上。数据采集、大盘设计、告警配置、调查优化、巡检报告,你日常的 SRE 工作让云监控 MCP 做得更好。