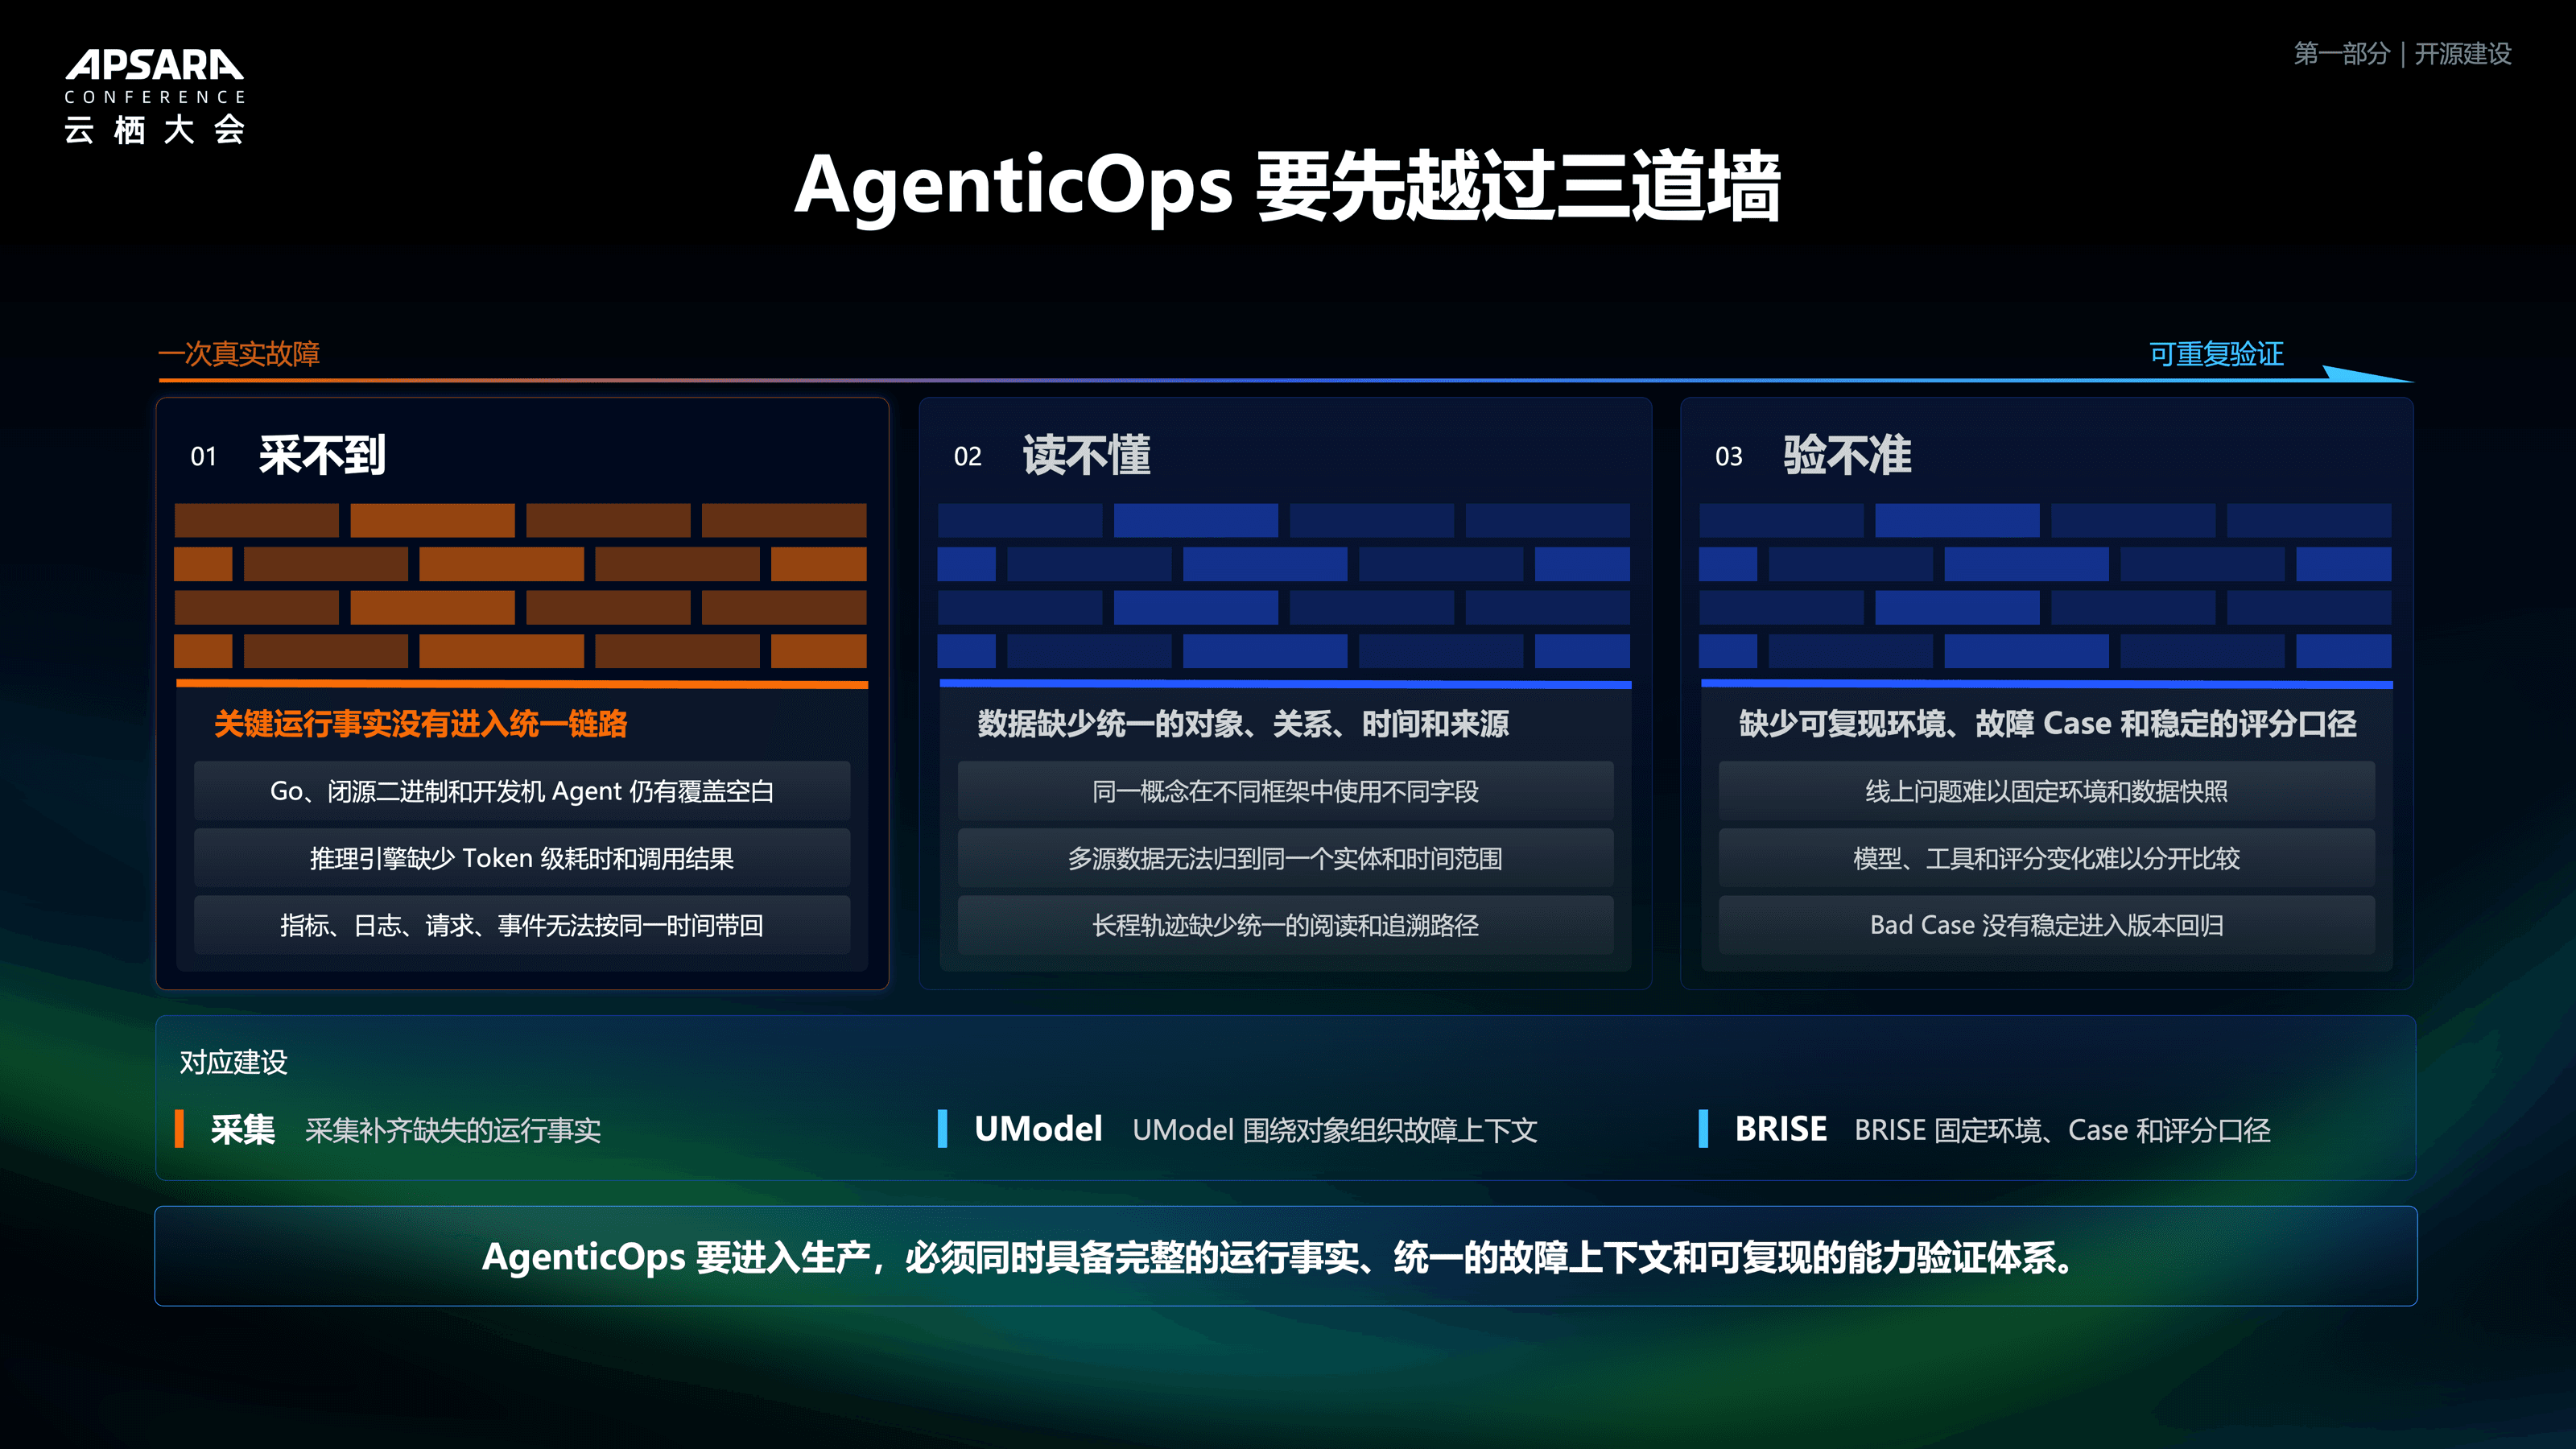
随着大模型的飞速发展,Agent 进入越来越多的领域。但当 AgenticOps 要真正走进生产环境,靠的不是一个更强的模型,而是一整套可持续建设的工程底座。要进入生产,必须同时具备完整的运行事实、统一的故障上下文和可复现的能力验证体系。这对应三个层层递进的挑战,也对应三项开源建设。一次真实故障,要能被稳定采集、被正确理解、被重复验证——跨越这三道墙,缺一不可。而今天,我们以这三道墙为主线,为大家分享阿里云可观测团队在 AgenticOps 的开源建设过程中的实践与思考。
开源建设:把运行事实可靠地带回来
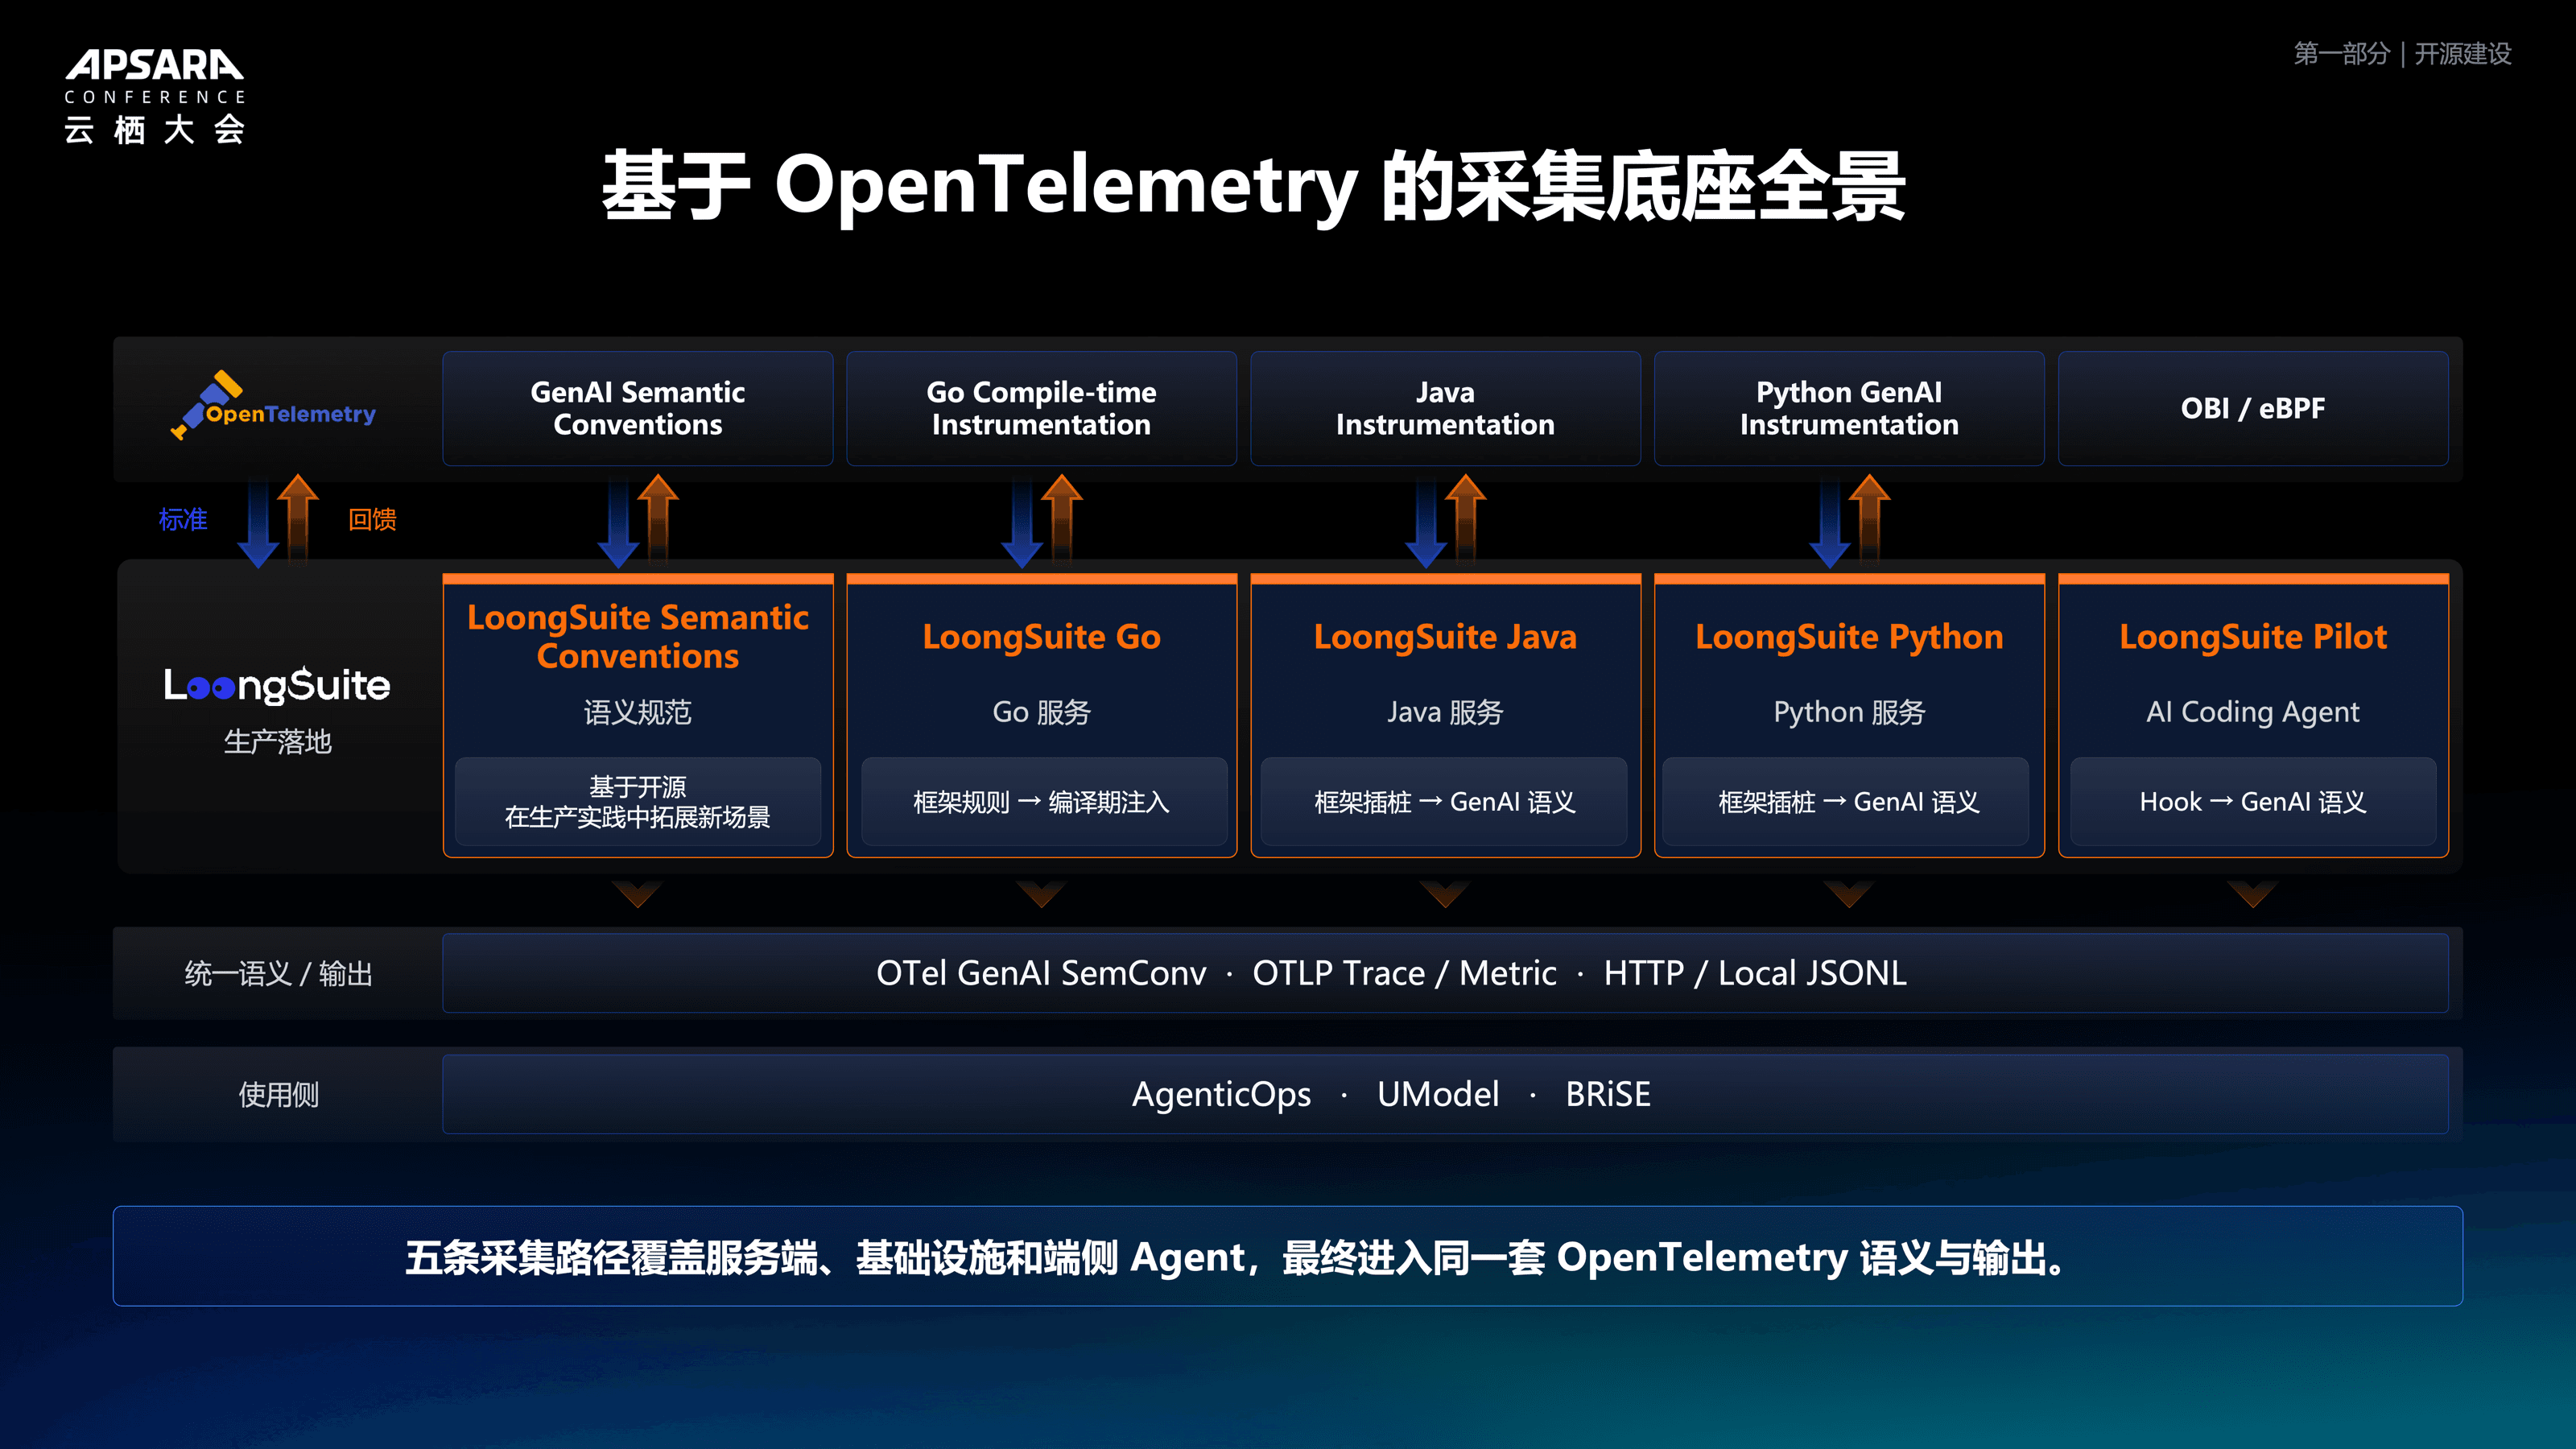
在数据采集方面,我们完全基于开源、拥抱开源,长期投入 OpenTelemetry 社区项目。主要贡献集中在三个方面:语义规范层面、各语言项目(Go、Java、Python),以及面向 Coding 场景与 Agent 的采集工作。我们也发布了开源项目 LoongSuite,它基于 OpenTelemetry 标准做了扩展。在阿里和客户的实践中,我们往往比社区走得更靠前一些,把实践先落地在这里,再把成熟的能力不断回馈给 OpenTelemetry 社区。所有产生的数据都是标准化的、符合 OpenTelemetry 规范的,并以 OTLP 协议格式发送到任意支持的后端——不只是阿里云,可以是任意支持 OTLP 协议的服务商。有了这些数据,就能用 UModel 做数据关联,通过 BRiSE 做评估和实验。
整个采集底座由五条路径构成,覆盖服务端、基础设施和端侧 Agent,最终进入同一套 OpenTelemetry 语义与输出:
| 采集路径 | 适用对象 | 方式 |
| Go Compile-time Instrumentation | Go 服务 | 框架规则 → 编译期注入 |
| Java Instrumentation | Java 服务 | 框架插桩 → GenAI 语义 |
| Python GenAI Instrumentation | Python 服务 | 框架插桩 → GenAI 语义 |
| OBI / eBPF | 不能重编译的存量系统 | 内核采集 → GenAI 语义 |
| LoongSuite Pilot | AI Coding Agent | Hook → GenAI 语义 |
三条主线的适用条件各不相同:编译时插桩适合可以重新构建的应用;eBPF 覆盖不能重编译的存量系统;运行时插桩适合框架丰富、需要应用内语义的环境。具体组合取决于应用条件、语义深度和运行权限。
(一)OBI:让"不能改代码"的应用变成标准化 OpenTelemetry 信号
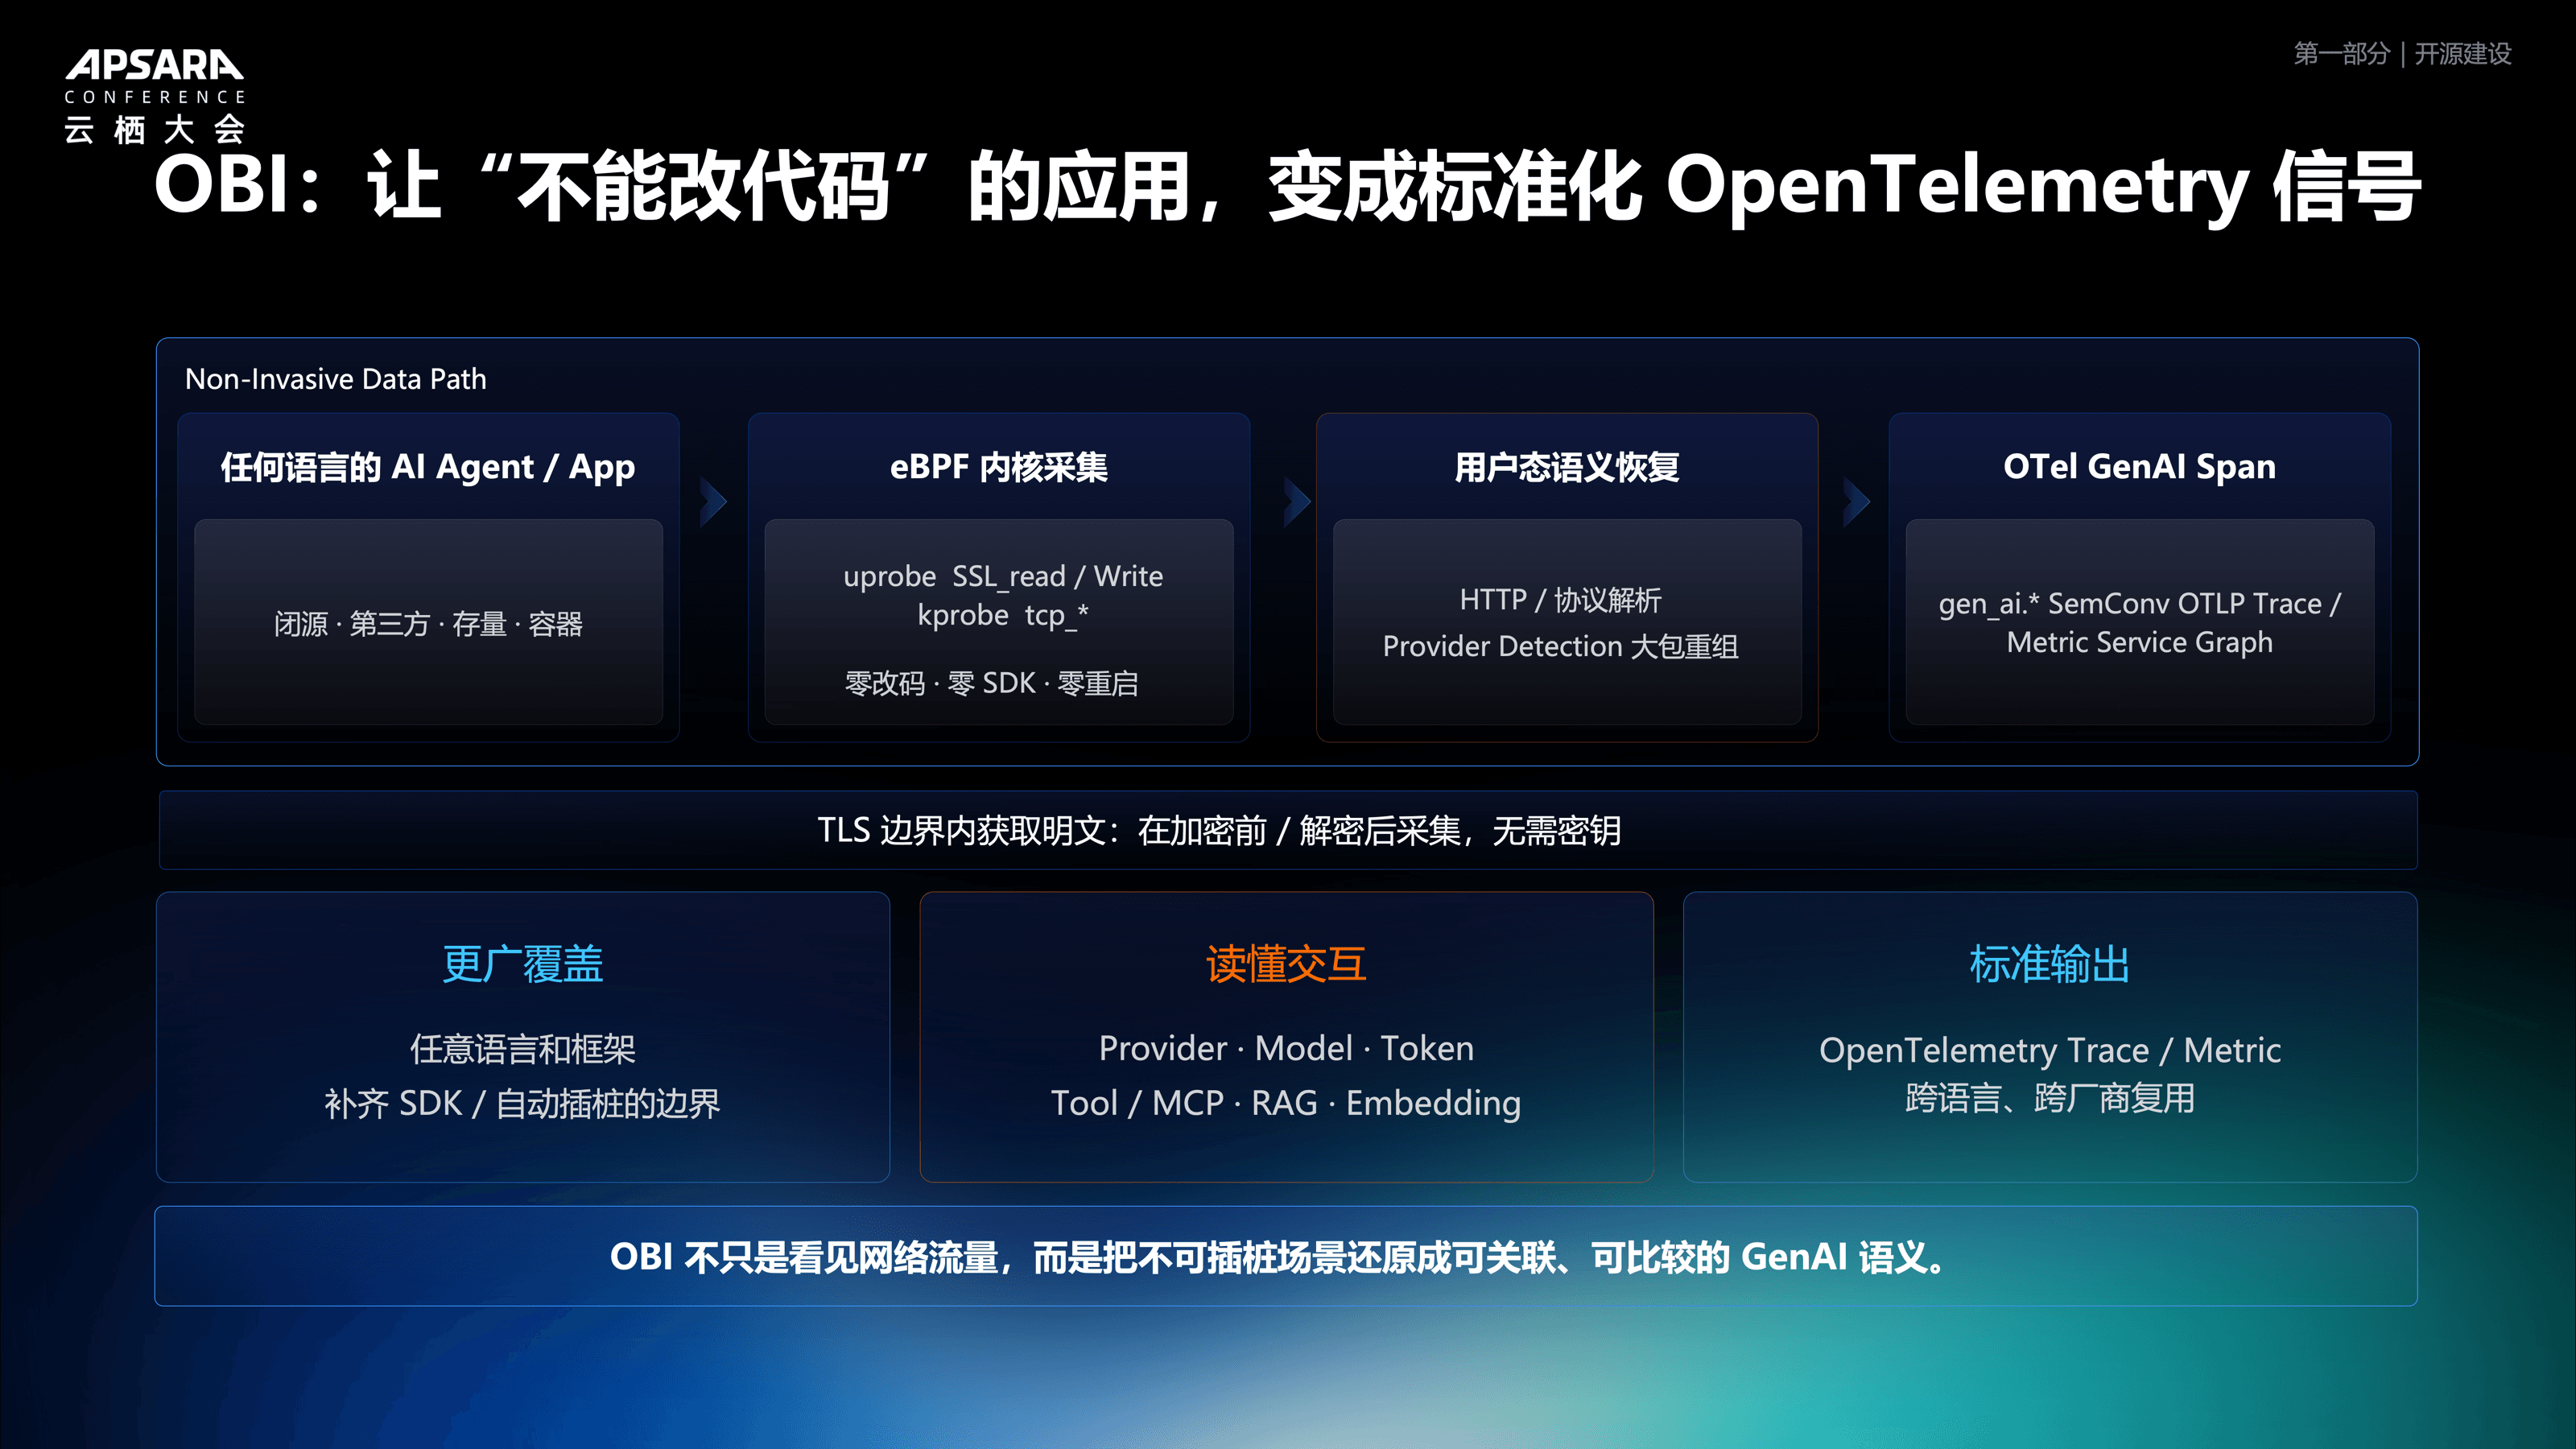
第一个是 OBI(OpenTelemetry eBPF Instrumentation)。它基于 eBPF 技术,主要面向那些无法修改代码的系统——我们无法触及、无法对它做埋点和采集。这时可以通过 eBPF 这种无侵入技术,在任意语言、任意环境下(包括 x86、ARM,任意 K8s、ECS,Sidecar/DaemonSet 部署)自动捕捉信号,做到零改码、零 SDK、零重启。
我们通过 eBPF 的 kprobe/uprobe 拦截应用发送网络请求时的关键信息,在 TLS 边界内获取明文(在加密前、解密后采集,无需密钥),再经用户态语义恢复(HTTP/协议解析、Provider 检测、大包重组),最终输出标准的 OTel GenAI Span。在 Agent 场景下,OBI 能自动识别调用大模型的协议——OpenAI、Anthropic、Gemini、千问等——并把输入输出、工具调用、MCP 调用、RAG、Embedding 等信息完整采集出来,产生的都是符合 OpenTelemetry 规范的标准数据。
这里有一个特别好的应用场景就是 Agent Sandbox。Sandbox 相当于一个虚拟隔离化的容器,在里面很难做侵入式埋点,所以我们在云监控上线的基于 Sandbox 的可观测能力,正是基于 OBI 实现的。OBI 不只是看见网络流量,而是把不可插桩的场景,还原成可关联、可比较的 GenAI 语义。
(二)国产框架贡献进入 OpenTelemetry 之路
除了 eBPF,我们在 Java 和其他语言上也向社区贡献了大量框架支持。以 RPC 框架 Apache Dubbo 为例,这个项目我们花了很多时间跟社区一起共建,走出了一条清晰的贡献路径:首先在生产中发现采集问题,把 bug 反馈给社区,不断修复、逐步补齐能力、替换废弃 API;接着跟社区一起商讨 RPC 框架到底应该怎么采集,共同制定语义规范——为 Dubbo 这类 RPC 框架单独定义语义规范,并新增 Dubbo RPC 指标,从 Trace 扩展到 Metric,建立独立的 SemConv 页面;然后按规范重构插桩、固定字段语义、实现与规范对齐;打磨稳定后进入 stable 支持。整个过程前前后后花了一年多到两年。
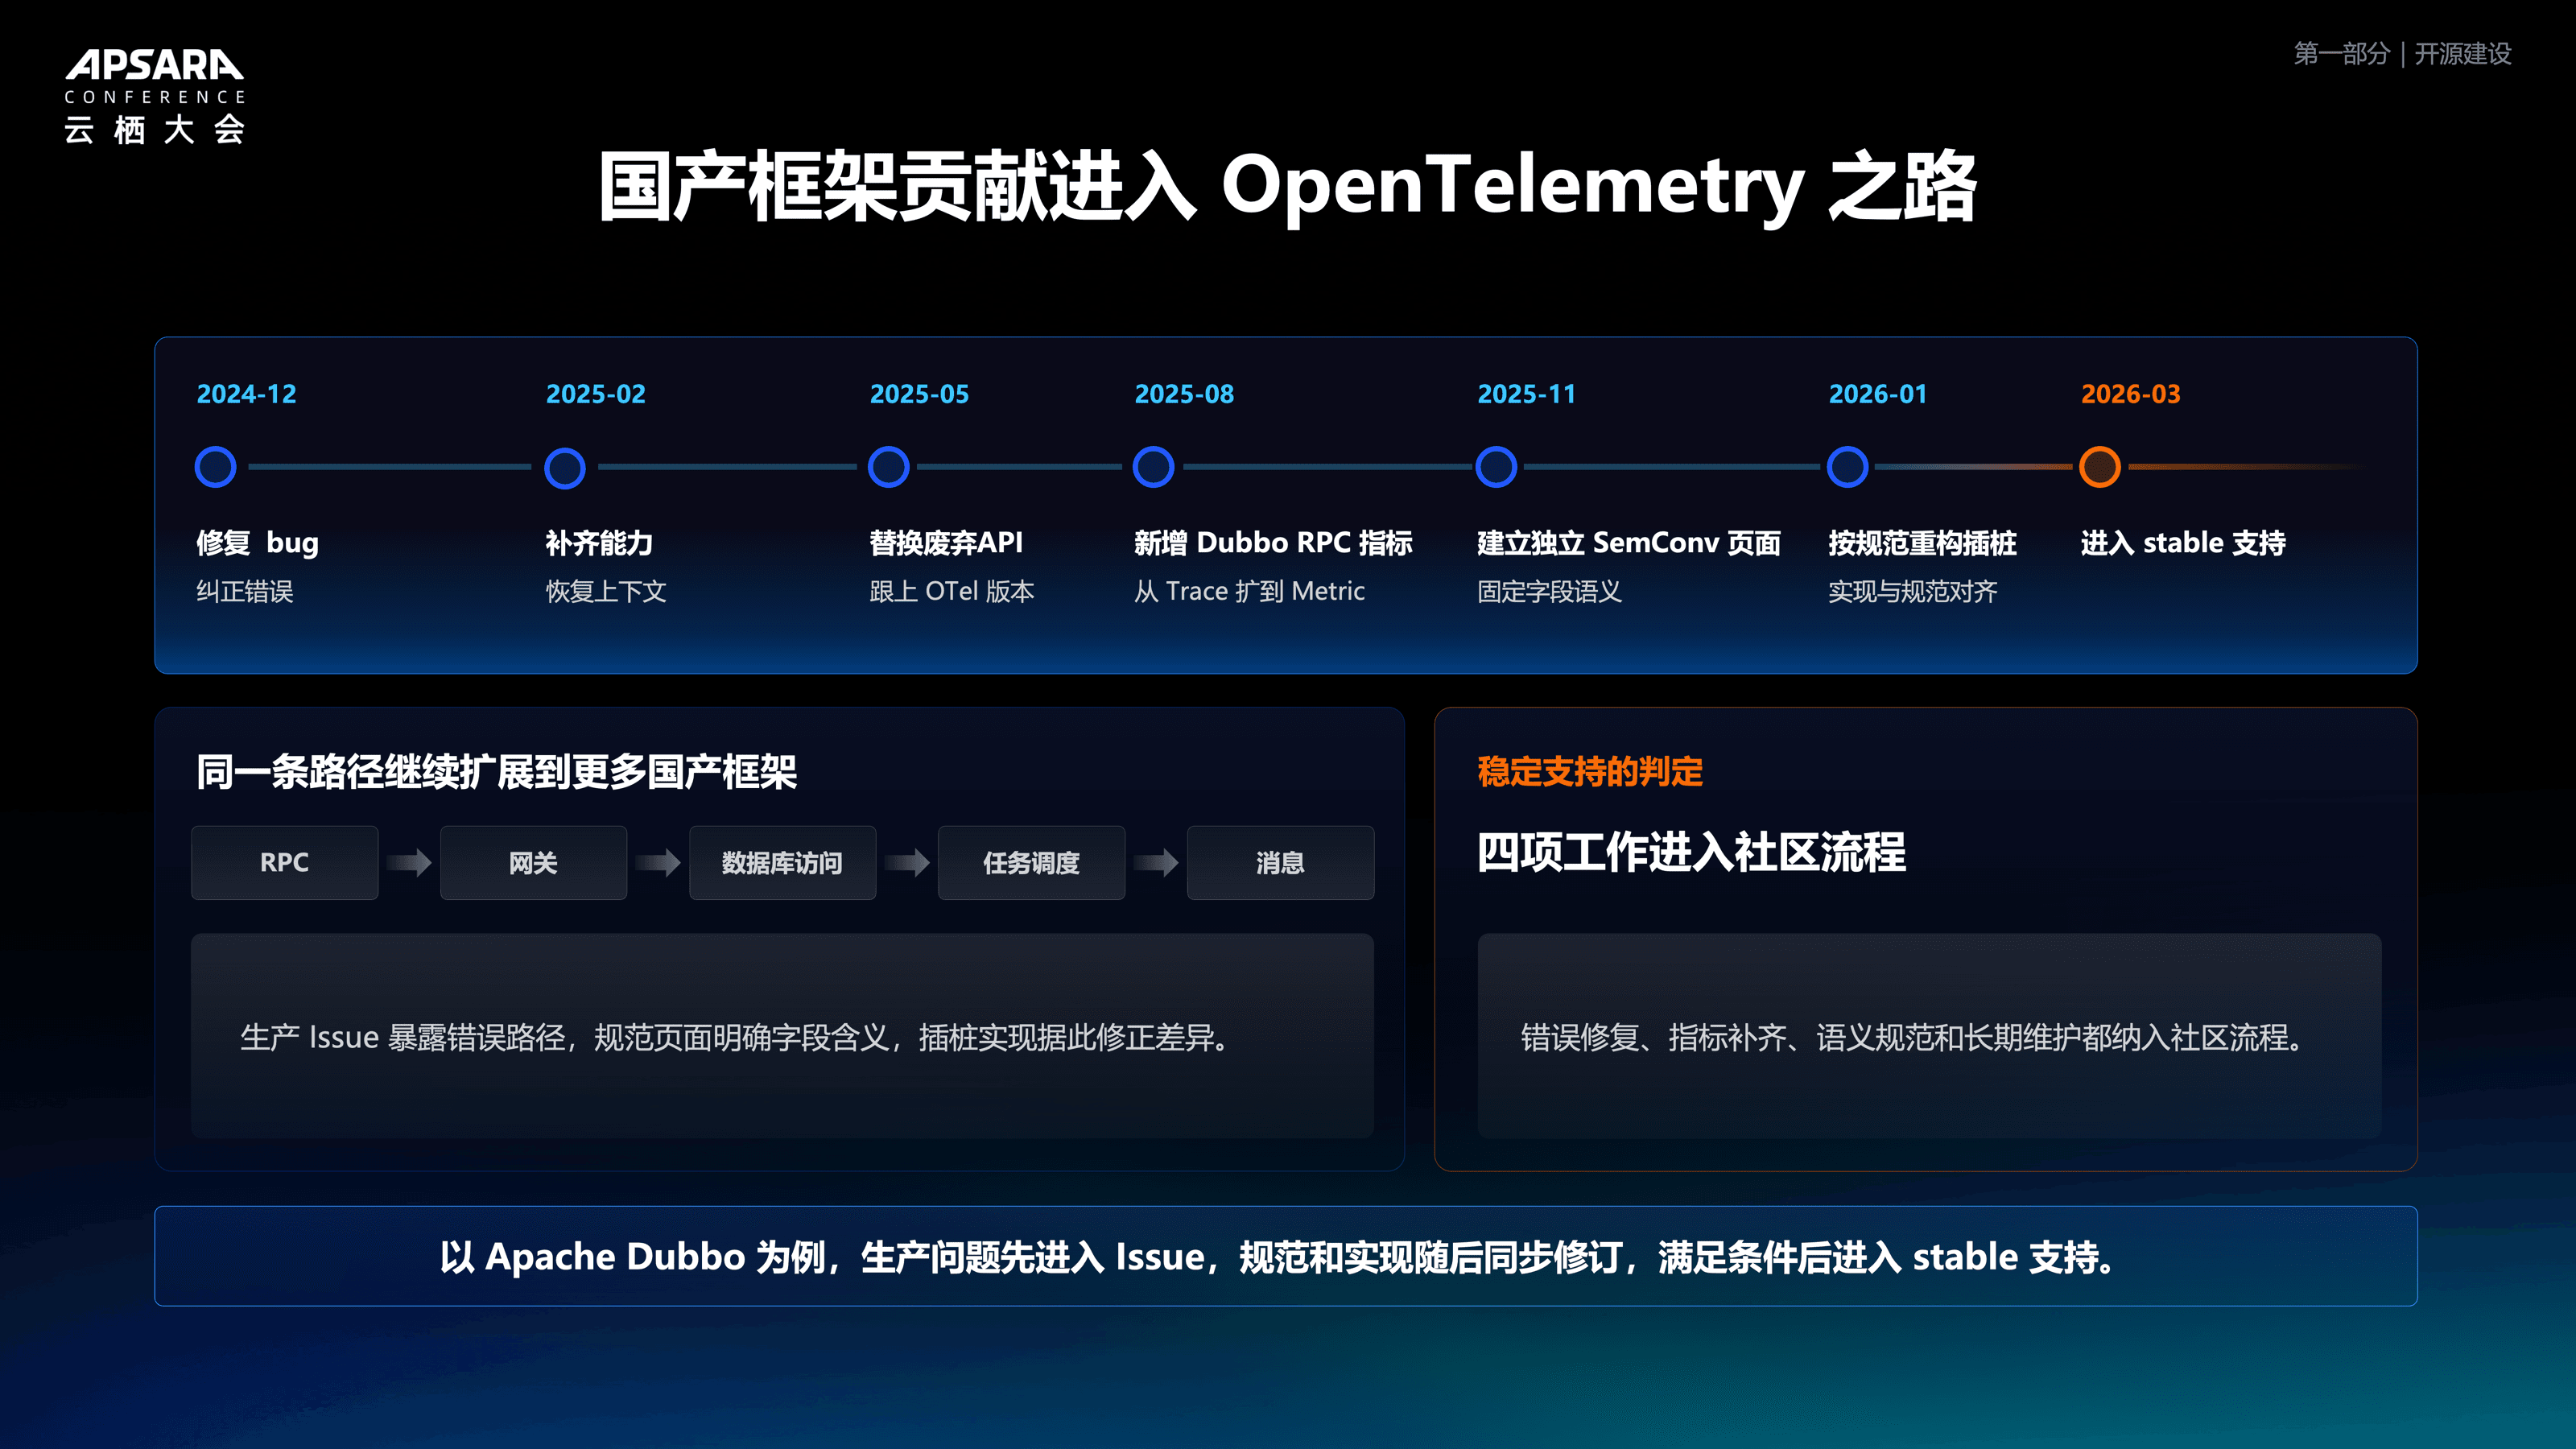
有了这样一个范式,就可以把它拓展到更多场景——RPC、网关、数据库访问、任务调度、消息等等,我们把很多插件和框架的支持都贡献给了社区,形成了一套比较完善的规范,跟社区一起共建。
(三)Semantic Convention 语义规范:双轨协作
语义规范是 OpenTelemetry 社区里非常核心的一个项目。它规定的是在可观测领域到底应该采集什么数据、叫什么名字、要什么单位、怎么采集。OpenTelemetry 社区有几十家厂商,包括国内外各种云厂商和可观测领域的头部企业,共同投入大量研发协商出这套规范。一旦满足规范,任意实现都能被观测领域的各家厂商很好地适配。
一开始我们跟社区一起共建 GenAI(Agent 领域)的语义规范,但社区希望我们先有真实场景的验证。于是我们走了一条双轨协作的路径:
- OTel 上游社区轨道:OpenTelemetry 启动 GenAI SemConv 讨论 → 社区 maintainer 建议先完成真实场景验证 → 逐项回馈字段、工具与 Agent 插桩。
- LoongSuite 验证轨道:整理内部模型调用与工具执行语义 → 阿里云、阿里控股与蚂蚁开展大规模验证 → 开源 LoongSuite GenAI SemConv。
两条轨道的分工很明确:LoongSuite 先在真实场景中快速验证字段和实现,成熟后再提交 OpenTelemetry,供不同厂商长期使用。一条承担快速试验,一条承担跨厂商长期维护。
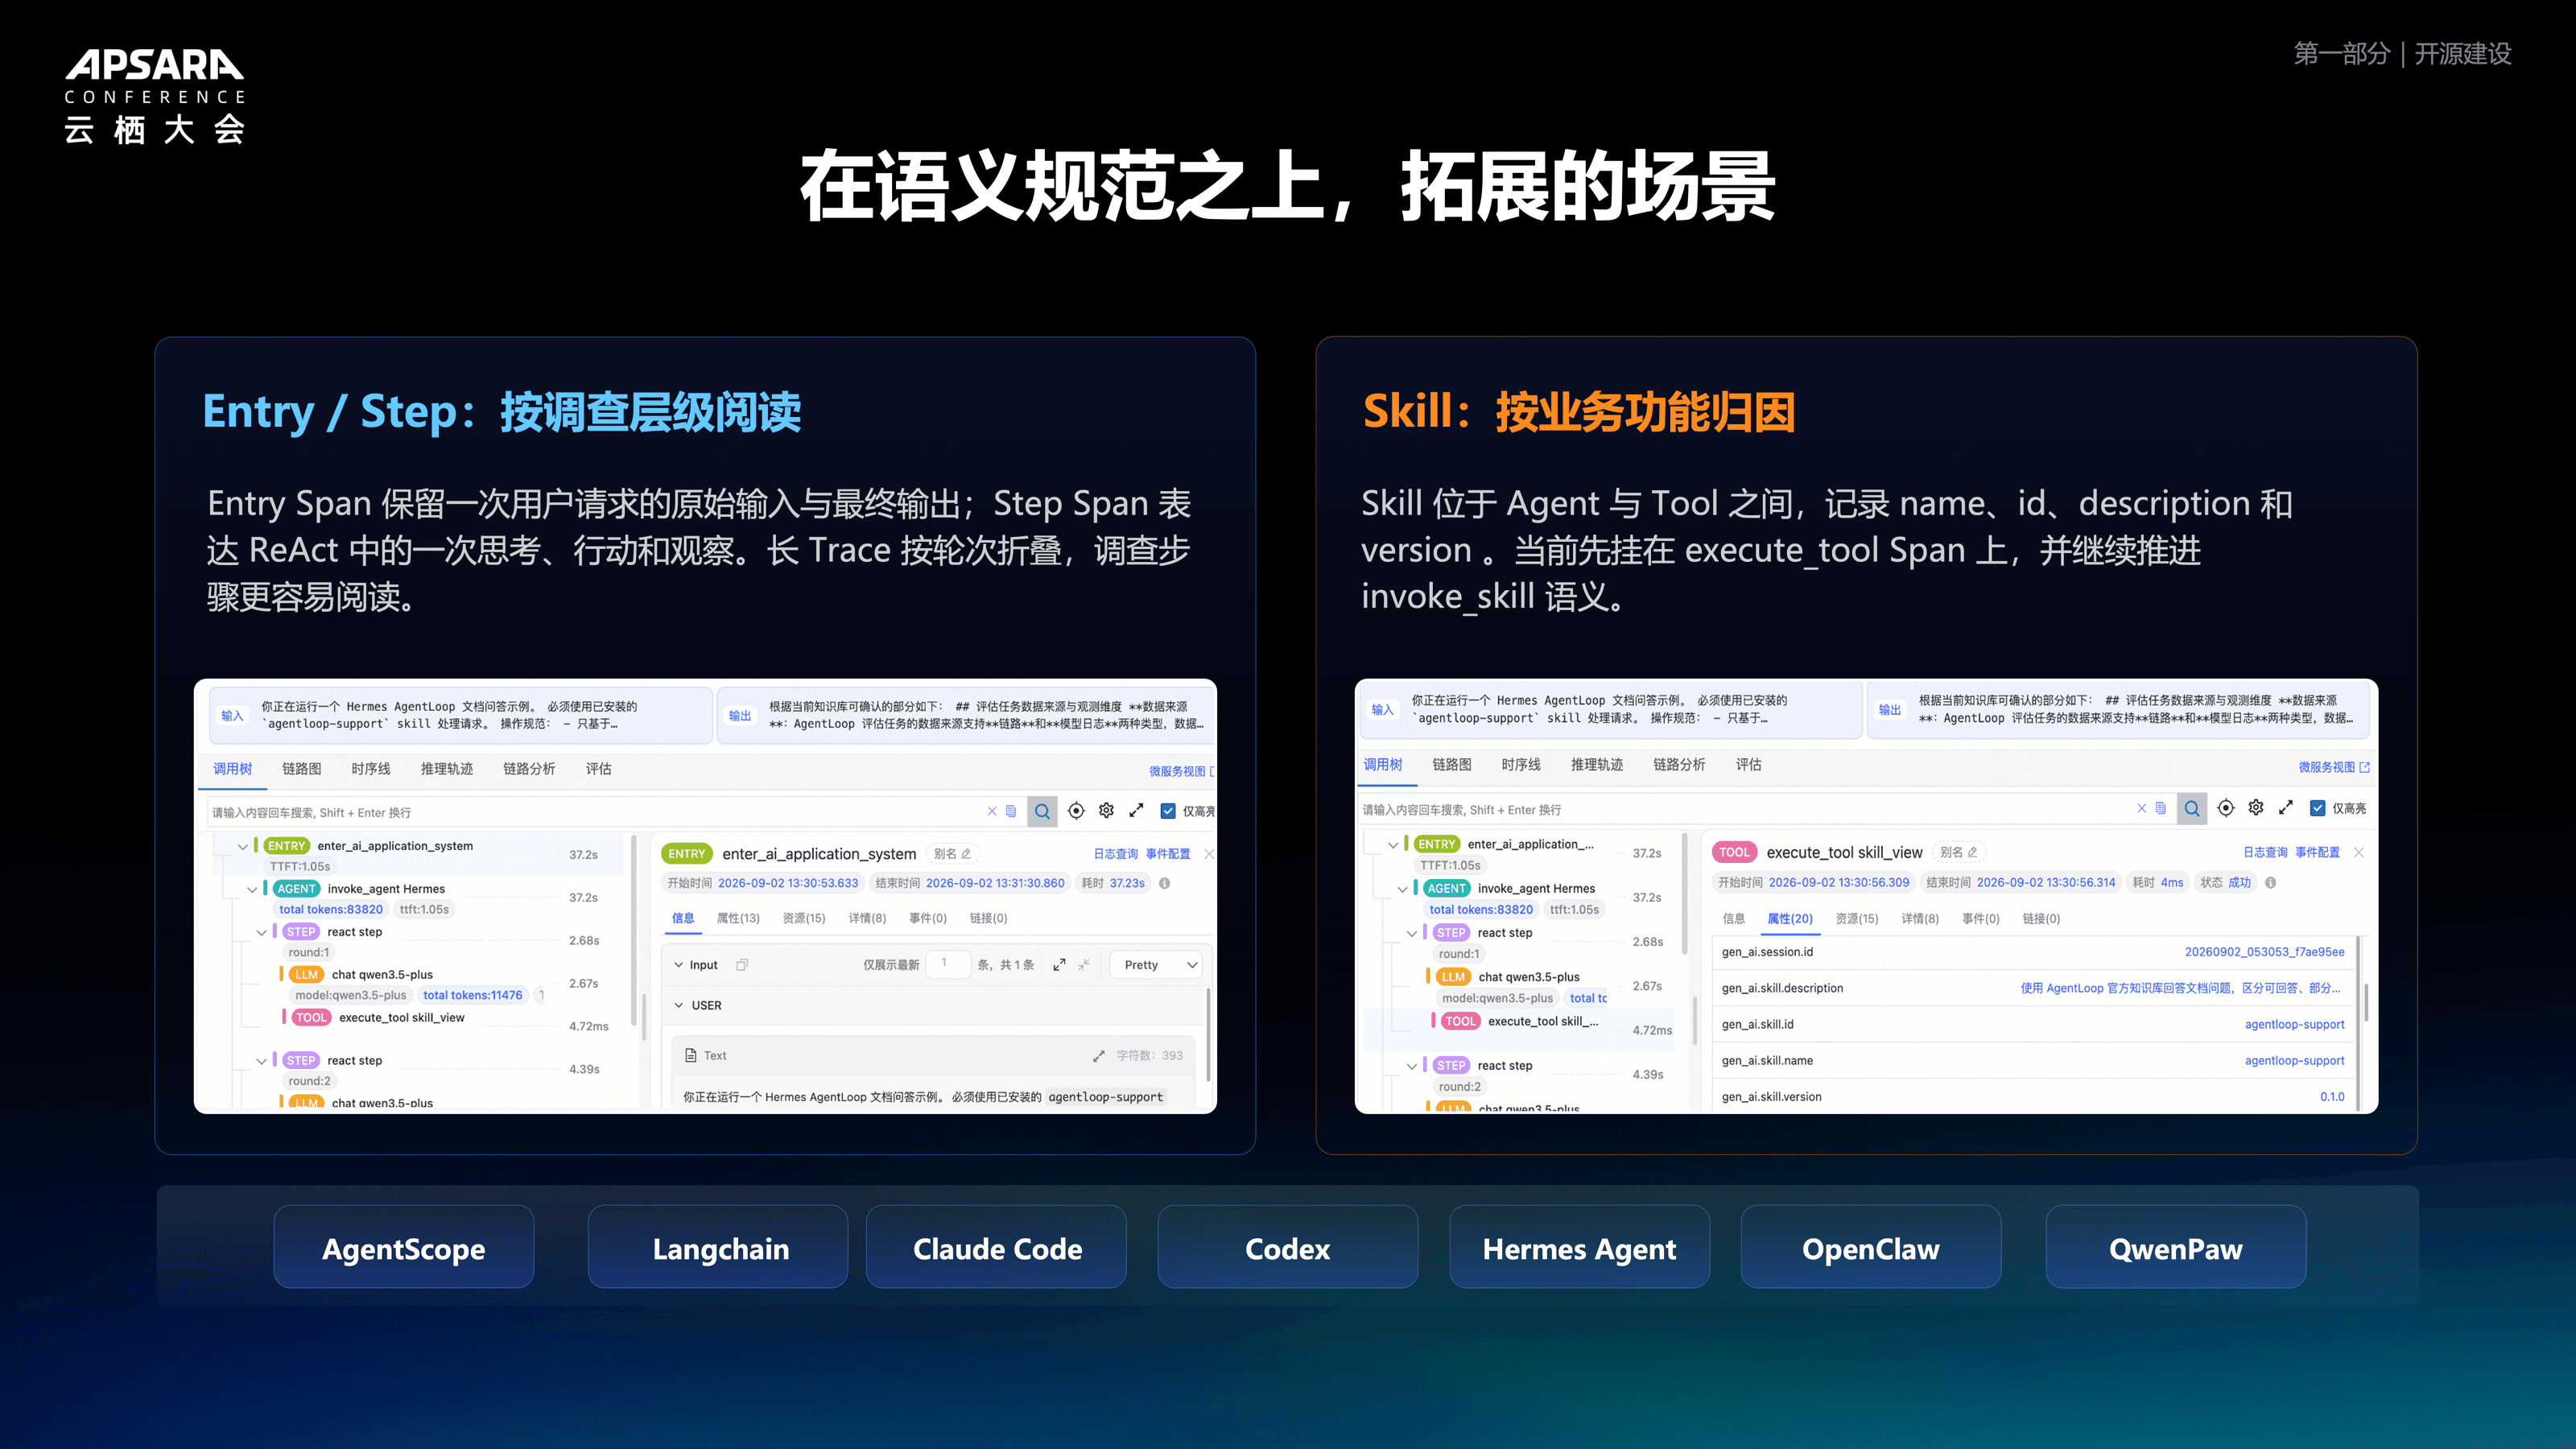
在语义规范之上,我们拓展了几个关键场景:
- Entry / Step:按调查层级阅读。 Entry Span 保留一次用户请求的原始输入与最终输出——之所以要单独记录,是因为有些框架会篡改用户的原始输入,导致我们采集到的东西并非本意。Step Span 表达 ReAct 中的一次思考、行动和观察,一次复杂任务可能执行几十轮甚至上百轮,长 Trace 按轮次折叠后,调查步骤更容易阅读。
- Skill:按业务功能归因。 Skill 是生产中特别重要的资产,位于 Agent 与 Tool 之间,记录 name、id、description 和 version。有了这些规范,就能基于 Skill 做后续的分析和评估——前面嘉宾分享到的 Skill 调优实践,正是来源于这样的规范采集。
这些实现能在不同框架中完成,包括 AgentScope、LangChain 这样的框架,以及 Claude Code、Codex、Hermes Agent、OpenClaw、QwenPaw 等 Coding Agent,都能完整覆盖。
(四)为推理引擎建立请求级 OpenTelemetry 追踪
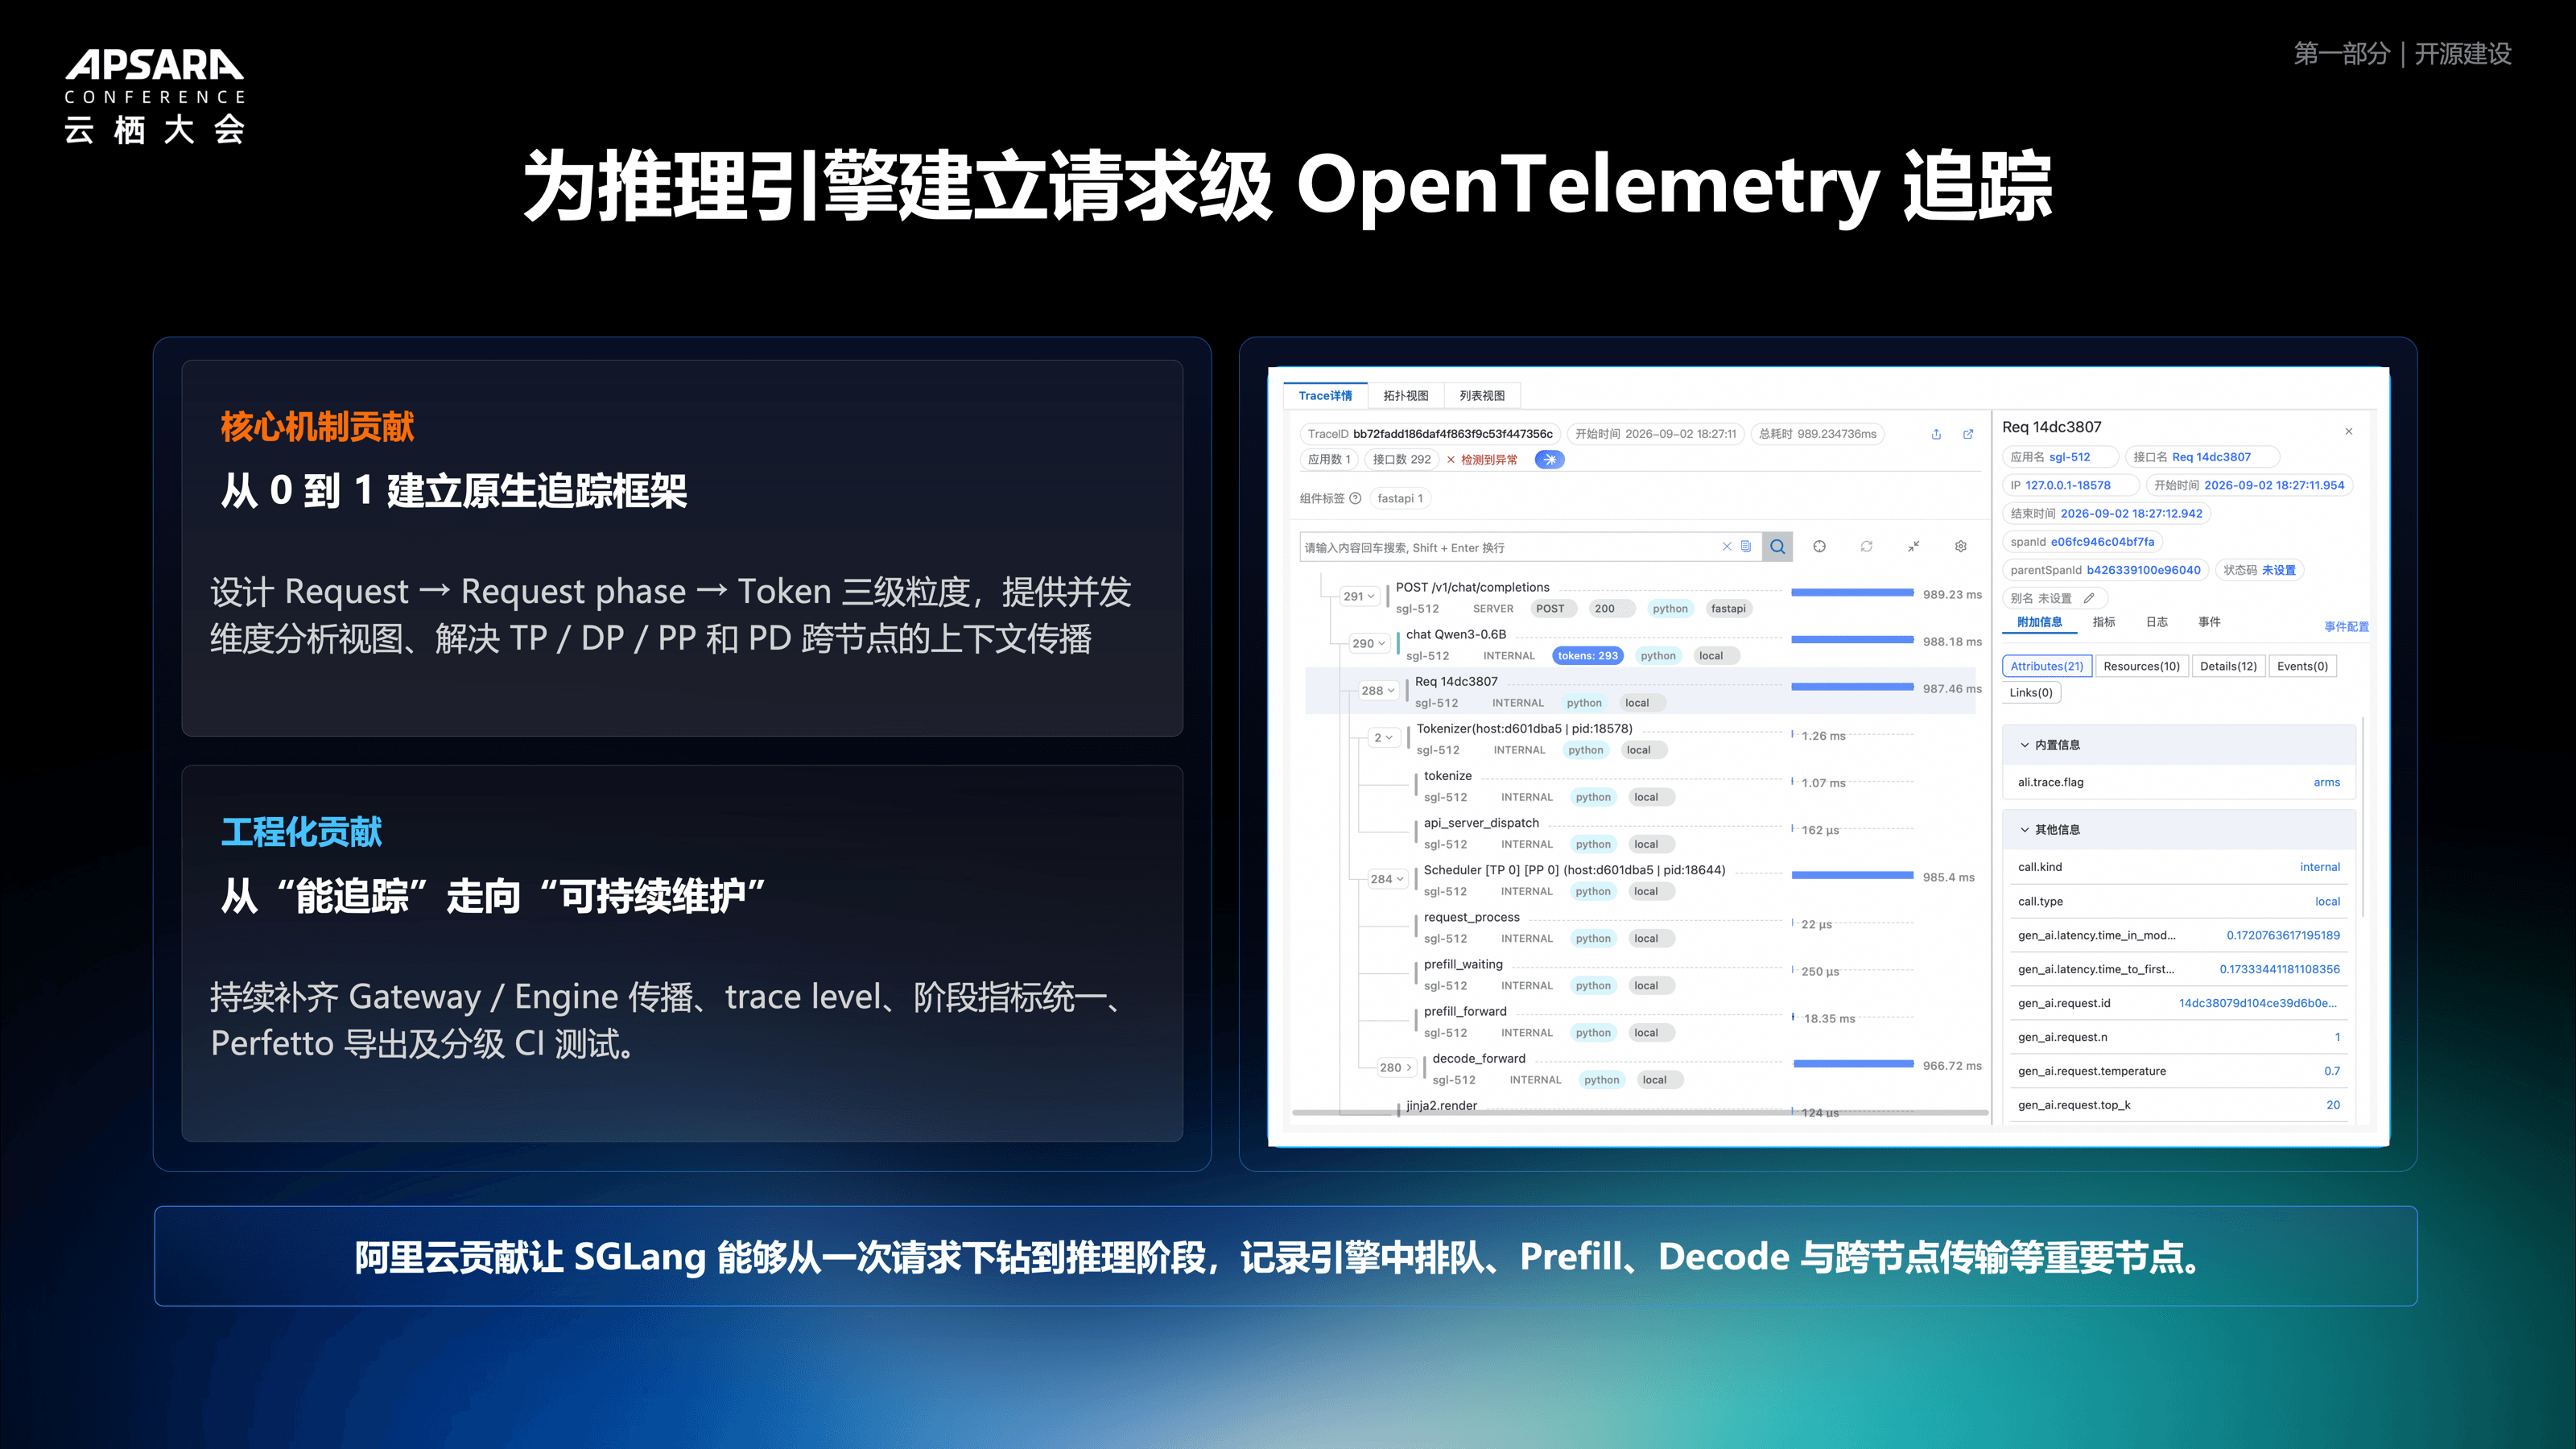
除了在 Agent 层面,我们还在推理引擎侧做了观测实践。我们希望把 Agent 的请求一路透传到推理引擎,完整看到这条链路到底慢在哪里、卡在哪里。以社区框架 SGLang 为例,阿里云的贡献让它能从一次请求下钻到推理阶段,记录引擎中排队、Prefill、Decode 与跨节点传输等重要节点:
- 核心机制贡献(从 0 到 1 建立原生追踪框架):设计 Request → Request Phase → Token 三级粒度,提供并发维度分析视图,解决 TP/DP/PP 和 PD 跨节点的上下文传播。
- 工程化贡献(从"能追踪"走向"可持续维护"):持续补齐 Gateway/Engine 传播、trace level、阶段指标统一、Perfetto 导出及分级 CI 测试。
这样就能分级采集到每一次 Token 预测的概率层面,更细腻地观测每个请求的实际执行情况。这部分能力也一并向社区捐献、合并了进去。请求级 Trace 能告诉我们一次调用慢了或答错了,Token 级观测则能进一步定位到具体 Token、生成阶段和跨租户资源干扰。
(五)LoongSuite Pilot:面向 Coding Agent 场景的标准化采集
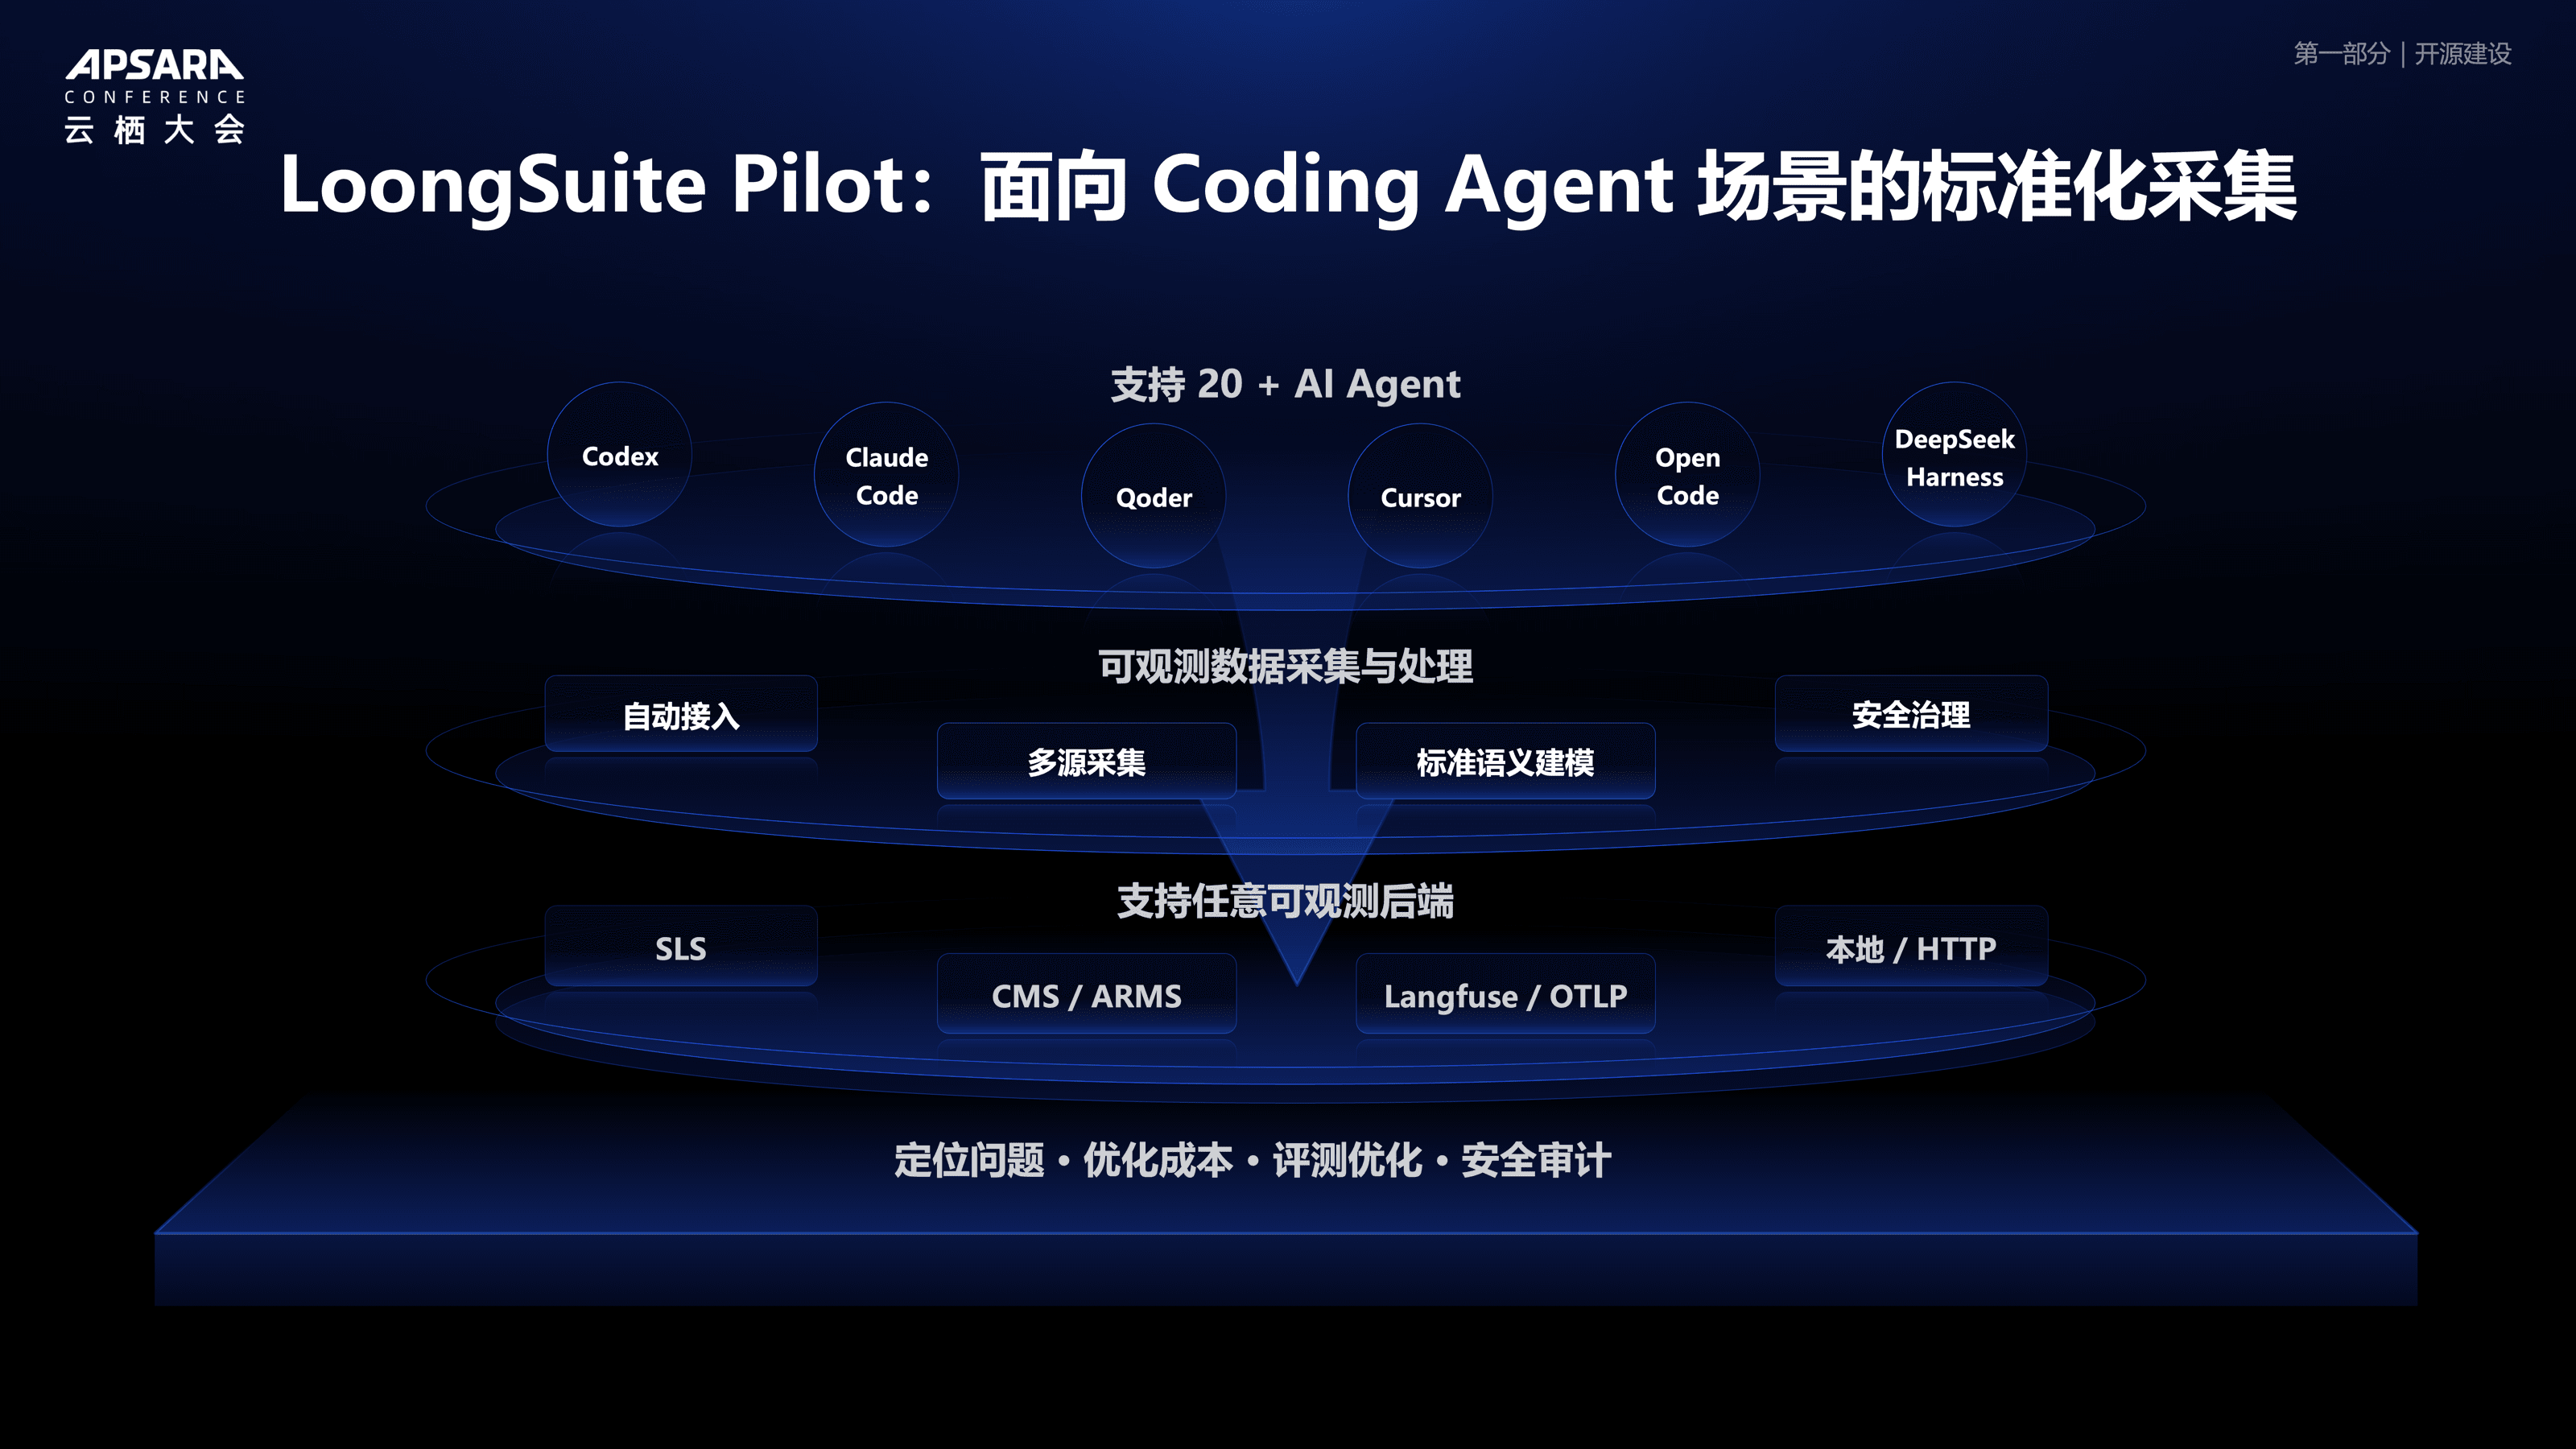
LoongSuite Pilot 是我们面向 Coding Agent 场景推出的标准化采集能力。它解决的问题是:我们有非常多的 Coding Agent,无论在个人办公场景还是生产中都会大量使用,比如 Claude Code、Codex 等,它们在完成复杂任务时也需要把执行轨迹记录下来。
通过 LoongSuite Pilot,可以一站式完整采集各种 Coding Agent(支持 20+ AI Agent,覆盖 Codex、Claude Code、Qoder、Cursor、OpenCode、DeepSeek、Harness 等),把观测对象从服务进程扩展到闭源 Agent、开发机和 CI,统一映射到 GenAI SemConv,再发送到任意可观测后端(SLS、CMS/ARMS、Langfuse/OTLP、本地/HTTP)。基于这份数据,就能定位问题、发现 Token 消耗、做评测优化、优化 Skill、调优 Agent,甚至做安全审计——比如知道它访问了什么不该访问的数据、执行了什么不该执行的命令。
(六)社区贡献:让生产经验持续进入 OpenTelemetry
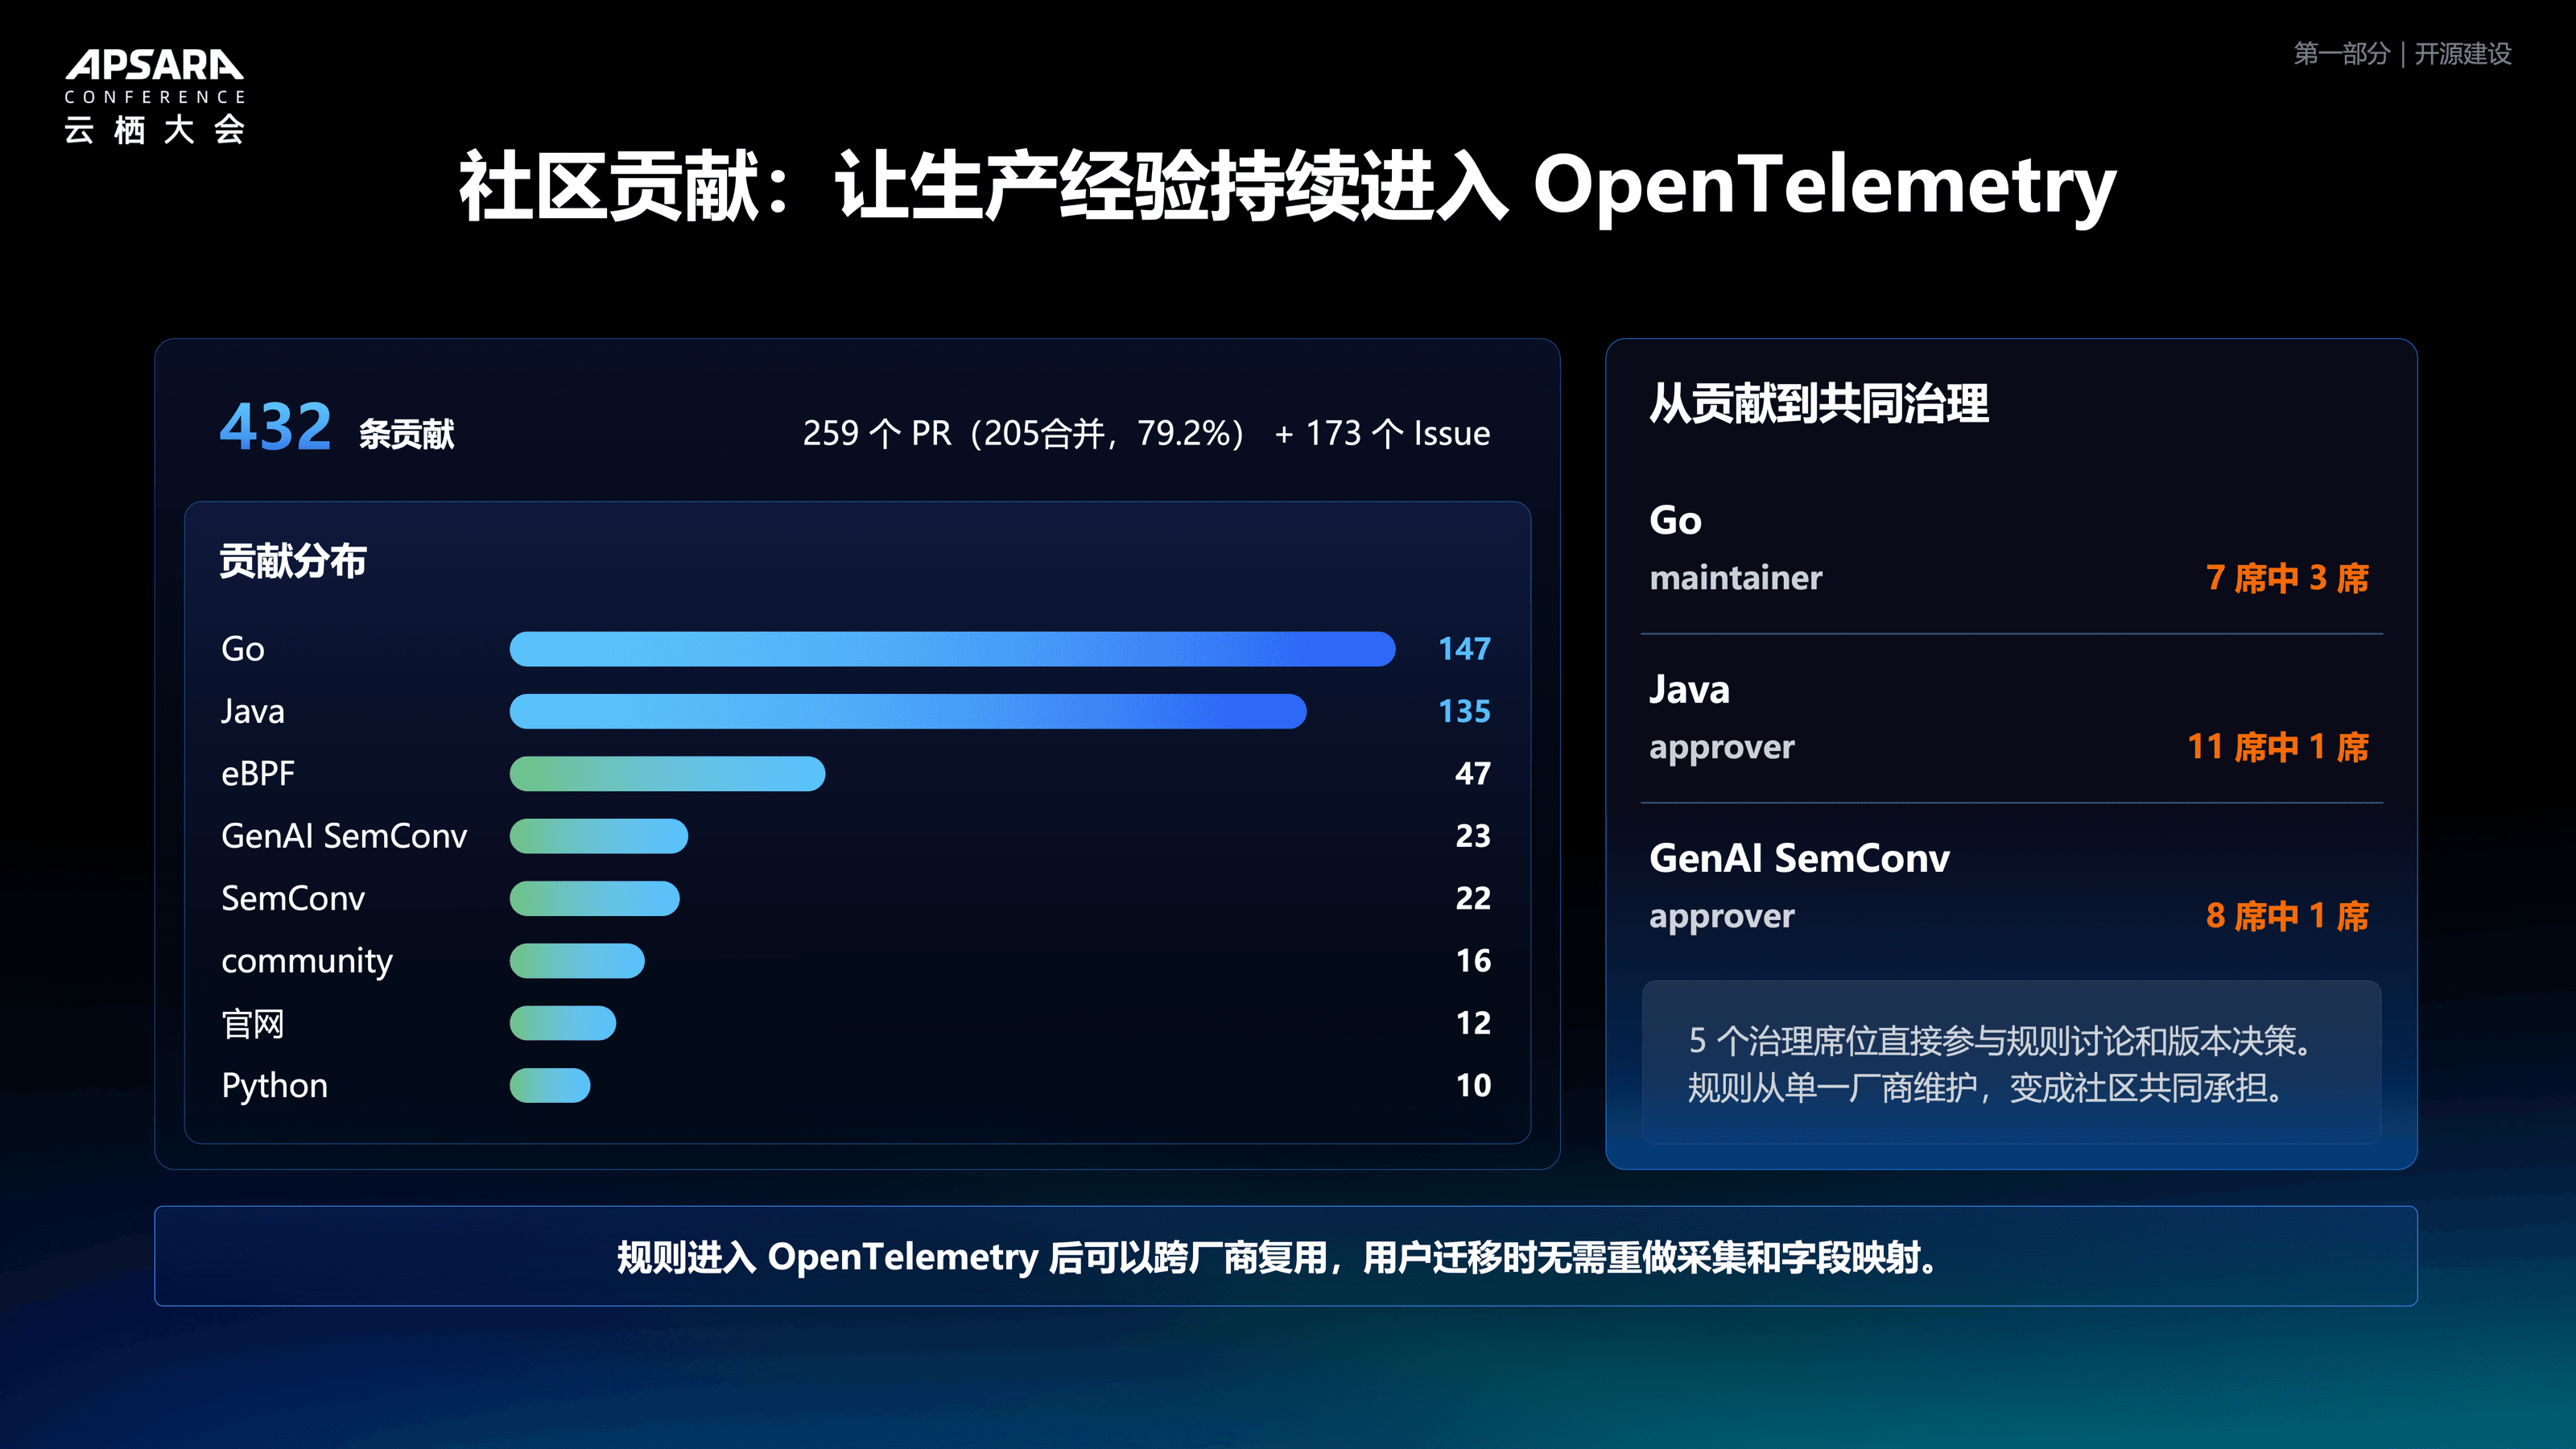
过去几年持续贡献,我们向社区提供了大量 PR 和 Issue,也实际拿到了很多 maintainer 和 approver 席位,参与到 OpenTelemetry 社区的治理规范中:
- 贡献分布:三年内共 432 条贡献,259 个 PR(205 已合并,79.2%)+ 173 个 Issue;其中 Java 135、Go 147、eBPF 47、Python 10、SemConv 23、GenAI SemConv 12、community 22、官网 16。
- 治理席位:Go maintainer(7 席中 3 席)、Java approver(11 席中 1 席)、GenAI SemConv approver(8 席中 1 席),共 5 个治理席位直接参与规则讨论和版本决策。
规则进入 OpenTelemetry 后可以跨厂商复用,用户迁移时无需重做采集和字段映射。规则从单一厂商维护,变成社区共同承担。就在最近,OBI 项目又有团队成员新晋升为 approver,再添一个新席位。
UModel 语义运行时:围绕对象组织故障上下文
数据辛辛苦苦采集进来,Agent 就能把故障看明白吗?这就是第二道墙——上下文读不懂。LLM 刚出来时,我们欣喜地看到它能读懂错误日志,但随着真正的业务落地,我们发现真正关键的是让模型理解背后的数据、对象、关系,理解对象之间的关系和时间,以及这些数据的来源。如果没有这些东西的对齐,Agent 在每一次调查里都可能一本正经地胡说八道,这样的结果让 SRE 同事难以信赖。UModel 要做的,就是围绕当前故障对象,把分散在各个监控系统的指标、日志、链路、事件统一组织起来,形成一个可查询、可追溯、可继续补充证据的调查上下文。
(一)真实案例:Checkout Service 成功率下降
以 OTel Demo 中的 Checkout Service 为例。业务侧最先感知到的现象很直接:Checkout Service 支付成功率在 3 分钟内从 99.6% 降至 92.1%,下降了 7.5 个百分点。用户其实不会关心这是数据库、容器还是下游的问题,他会投诉支付不顺畅、结算不顺畅。而对 AgenticOps 的 Agent 来说,任务就是从业务现象出发去调查排查。Agent 可访问的数据看起来已经非常齐全:
| 数据类型 | 内容 |
| Metrics | Checkout 成功率 / SLO |
| Logs | checkout / MySQL 日志 |
| 请求 | checkout → payment |
| Events | release V2.4 |
| CMDB | Deployment / Pod / MySQL |
| Runbook | 发布、数据库、下游验证 |
再看时间线:09:58 起,10:01 发布 V2.4,10:04 数据库连接数上升,10:06 payment 超时。SRE 的第一反应往往是"是不是这个发布引起的故障"——这是有经验的人的合理直觉。但时间相近的三条线索还不能证明因果关系,发布仍只是一个待验证的假设。
Agent 真正需要确认的是:这次发布影响了哪些实例?连接数变化对应哪个 MySQL 对象?发生超时的 payment 调用和成功率下降的 Checkout Service 是否在同一个依赖路径上?要把所有事实放到同一个空间、同一个时间窗口内,才能判断它们如何关联。于是有了四个关键判断:哪个对象先变化?哪条证据支持原因?异常怎样传播?下一步验证什么?
(二)UModel 的三层结构:聚合对象、关系、状态和证据,形成 Agent 可继续执行的调查上下文
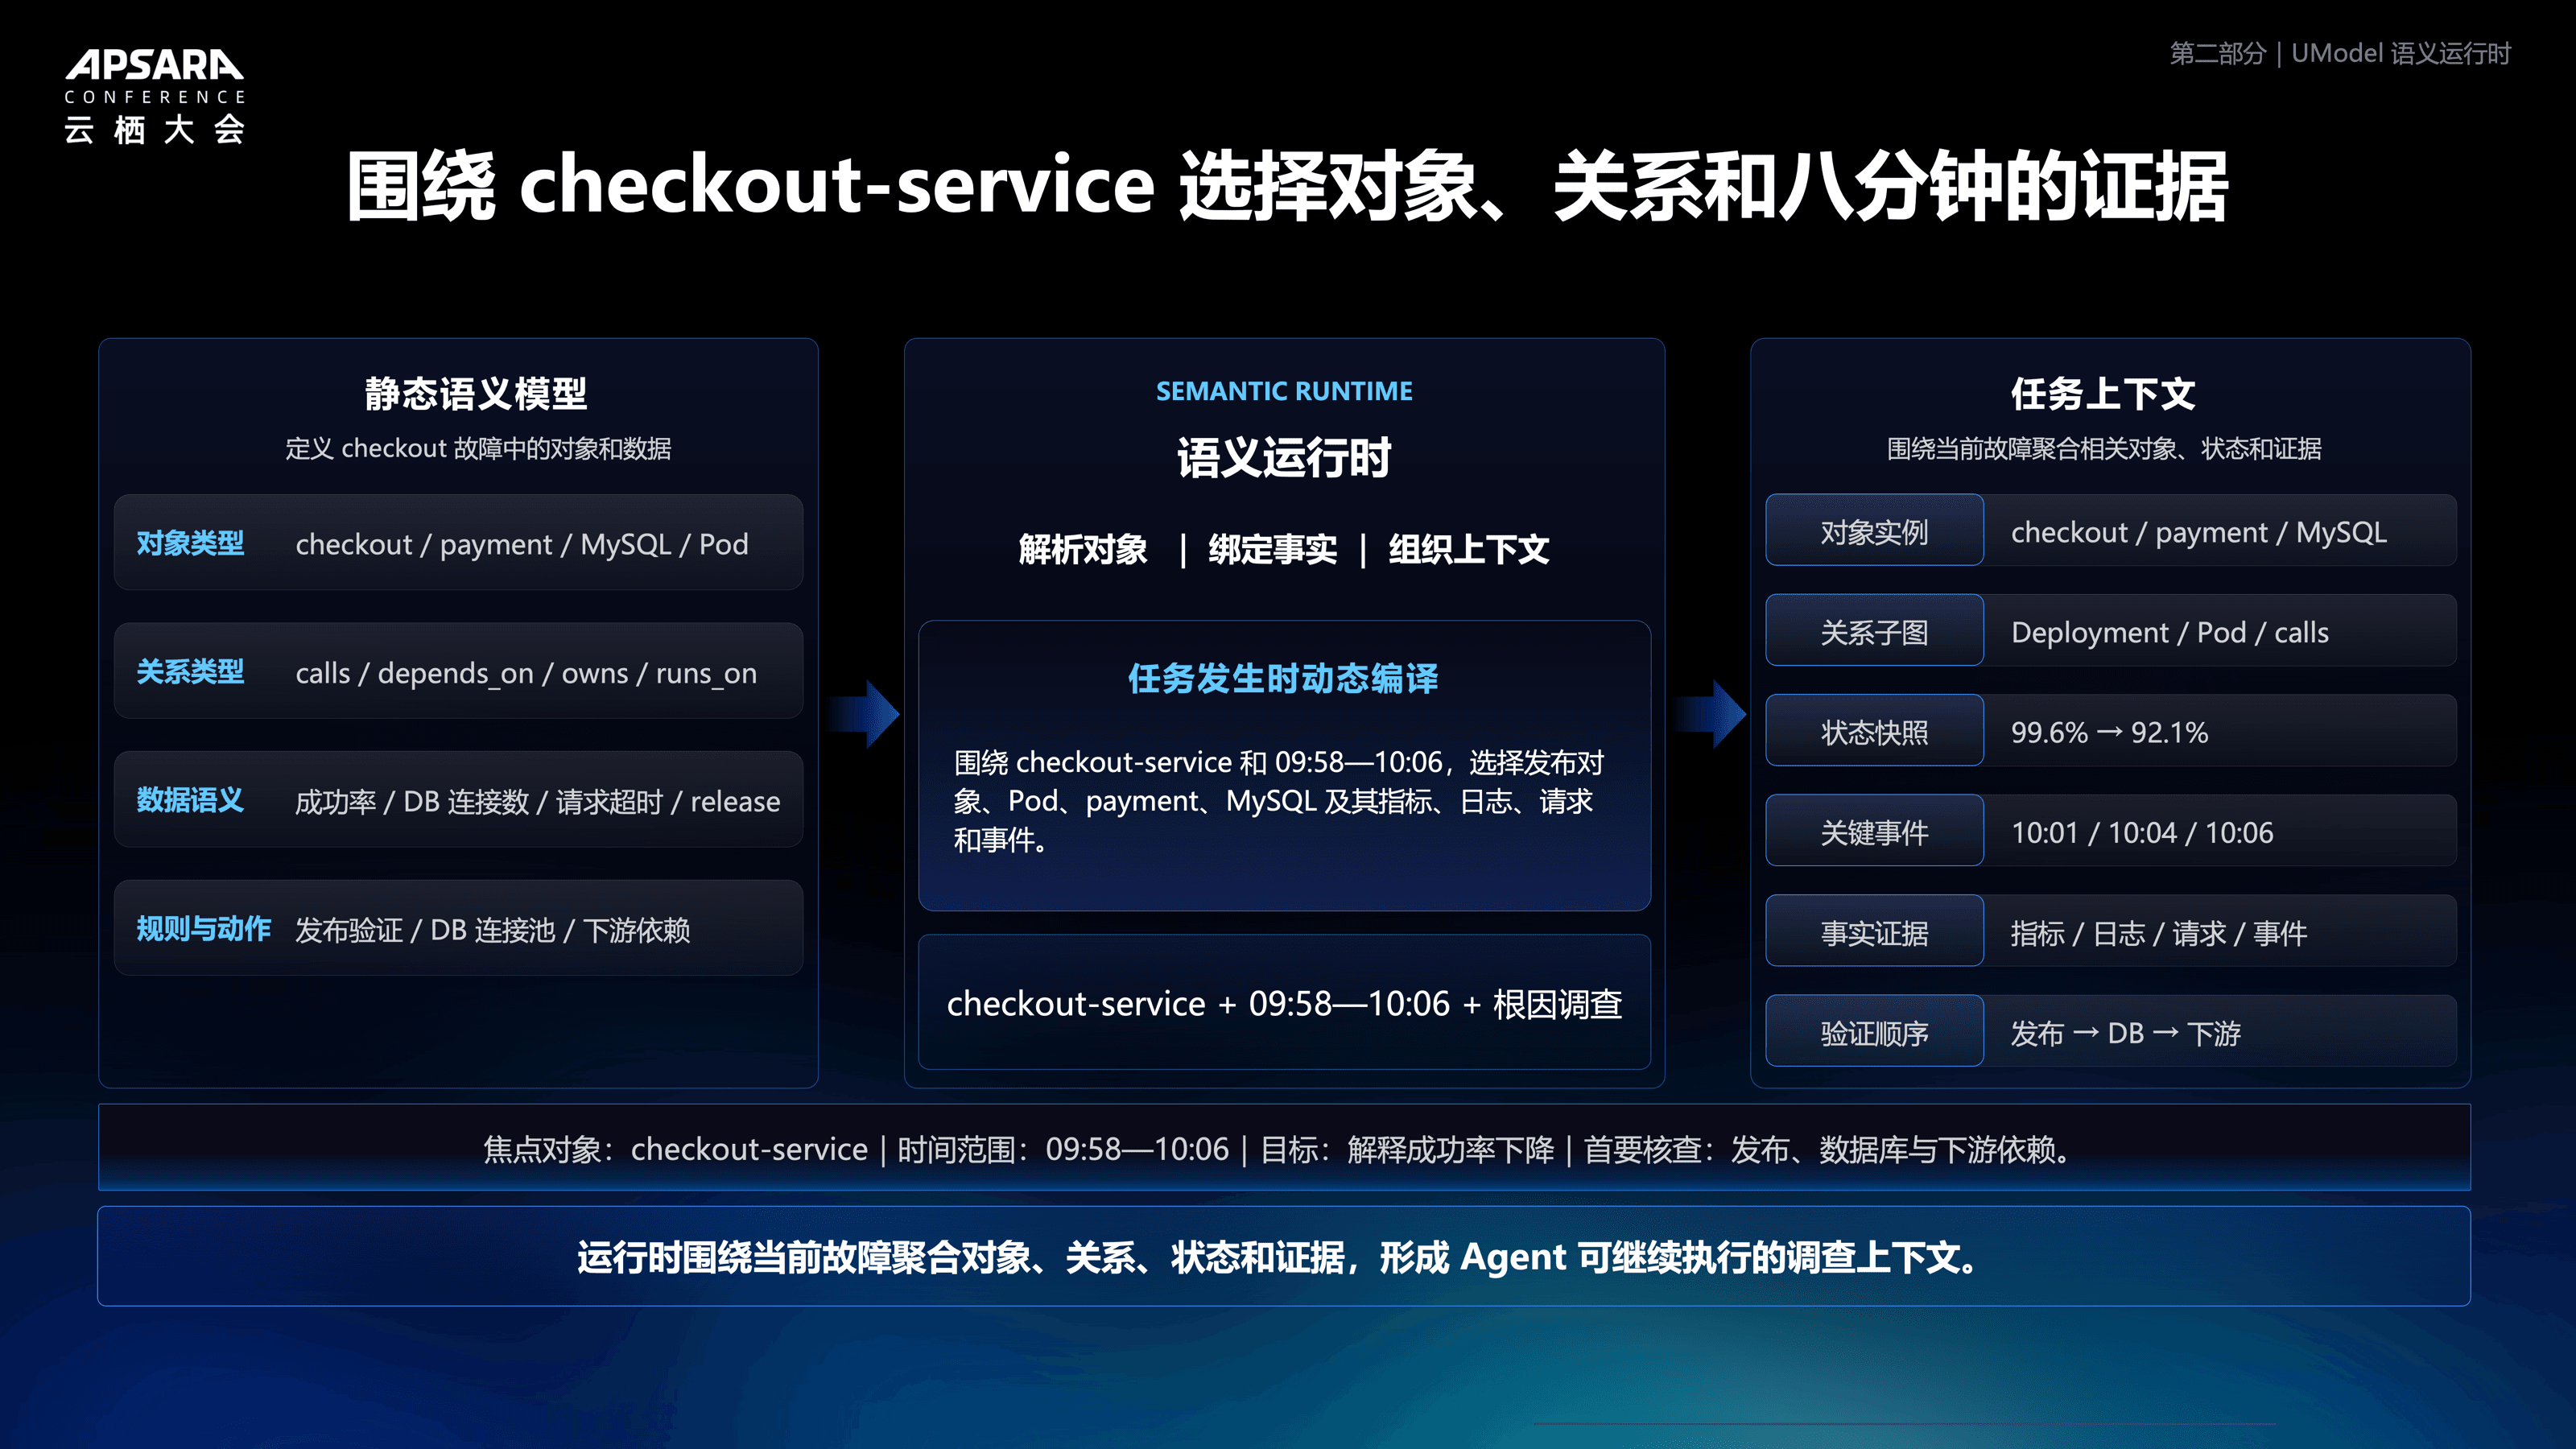
UModel 通过"静态语义模型 → 语义运行时 → 任务上下文"三层结构,把分散信息组成调查所需的上下文:
- 静态语义模型:定义 checkout、payment、MySQL、Pod 等对象类型,定义它们之间的关系类型(calls / depends_on / owns / runs_on),定义数据语义(成功率 / DB 连接数 / 请求超时 / release)以及规则与动作(发布验证 / DB 连接池 / 下游依赖)。没有这一层约束,同一个对象在不同系统里可能一直对不上。
- 语义运行时:任务发生时动态编译,只聚焦当前对象、当前时间窗口和与调查有关的事实。三个明确条件是——焦点对象 checkout-service、时间范围 09:58—10:06、目标是解释成功率下降(不是做巡检)。无关数据全部排除,只给 Agent 需要的关键数据。
- 任务上下文:输出的不是琐碎元数据,而是对象实例(Deployment/Pod/calls)、关系子图、状态快照(99.6%→92.1%)、关键事件(10:01/10:04/10:06)、事实证据(指标/日志/请求/事件),以及建议的验证顺序(发布 → DB → 下游)。
这样 Agent 既能看到成功率下降,也能知道这组变化对应到哪组数据里。
(三)跨域调查:保留对象、时间和来源
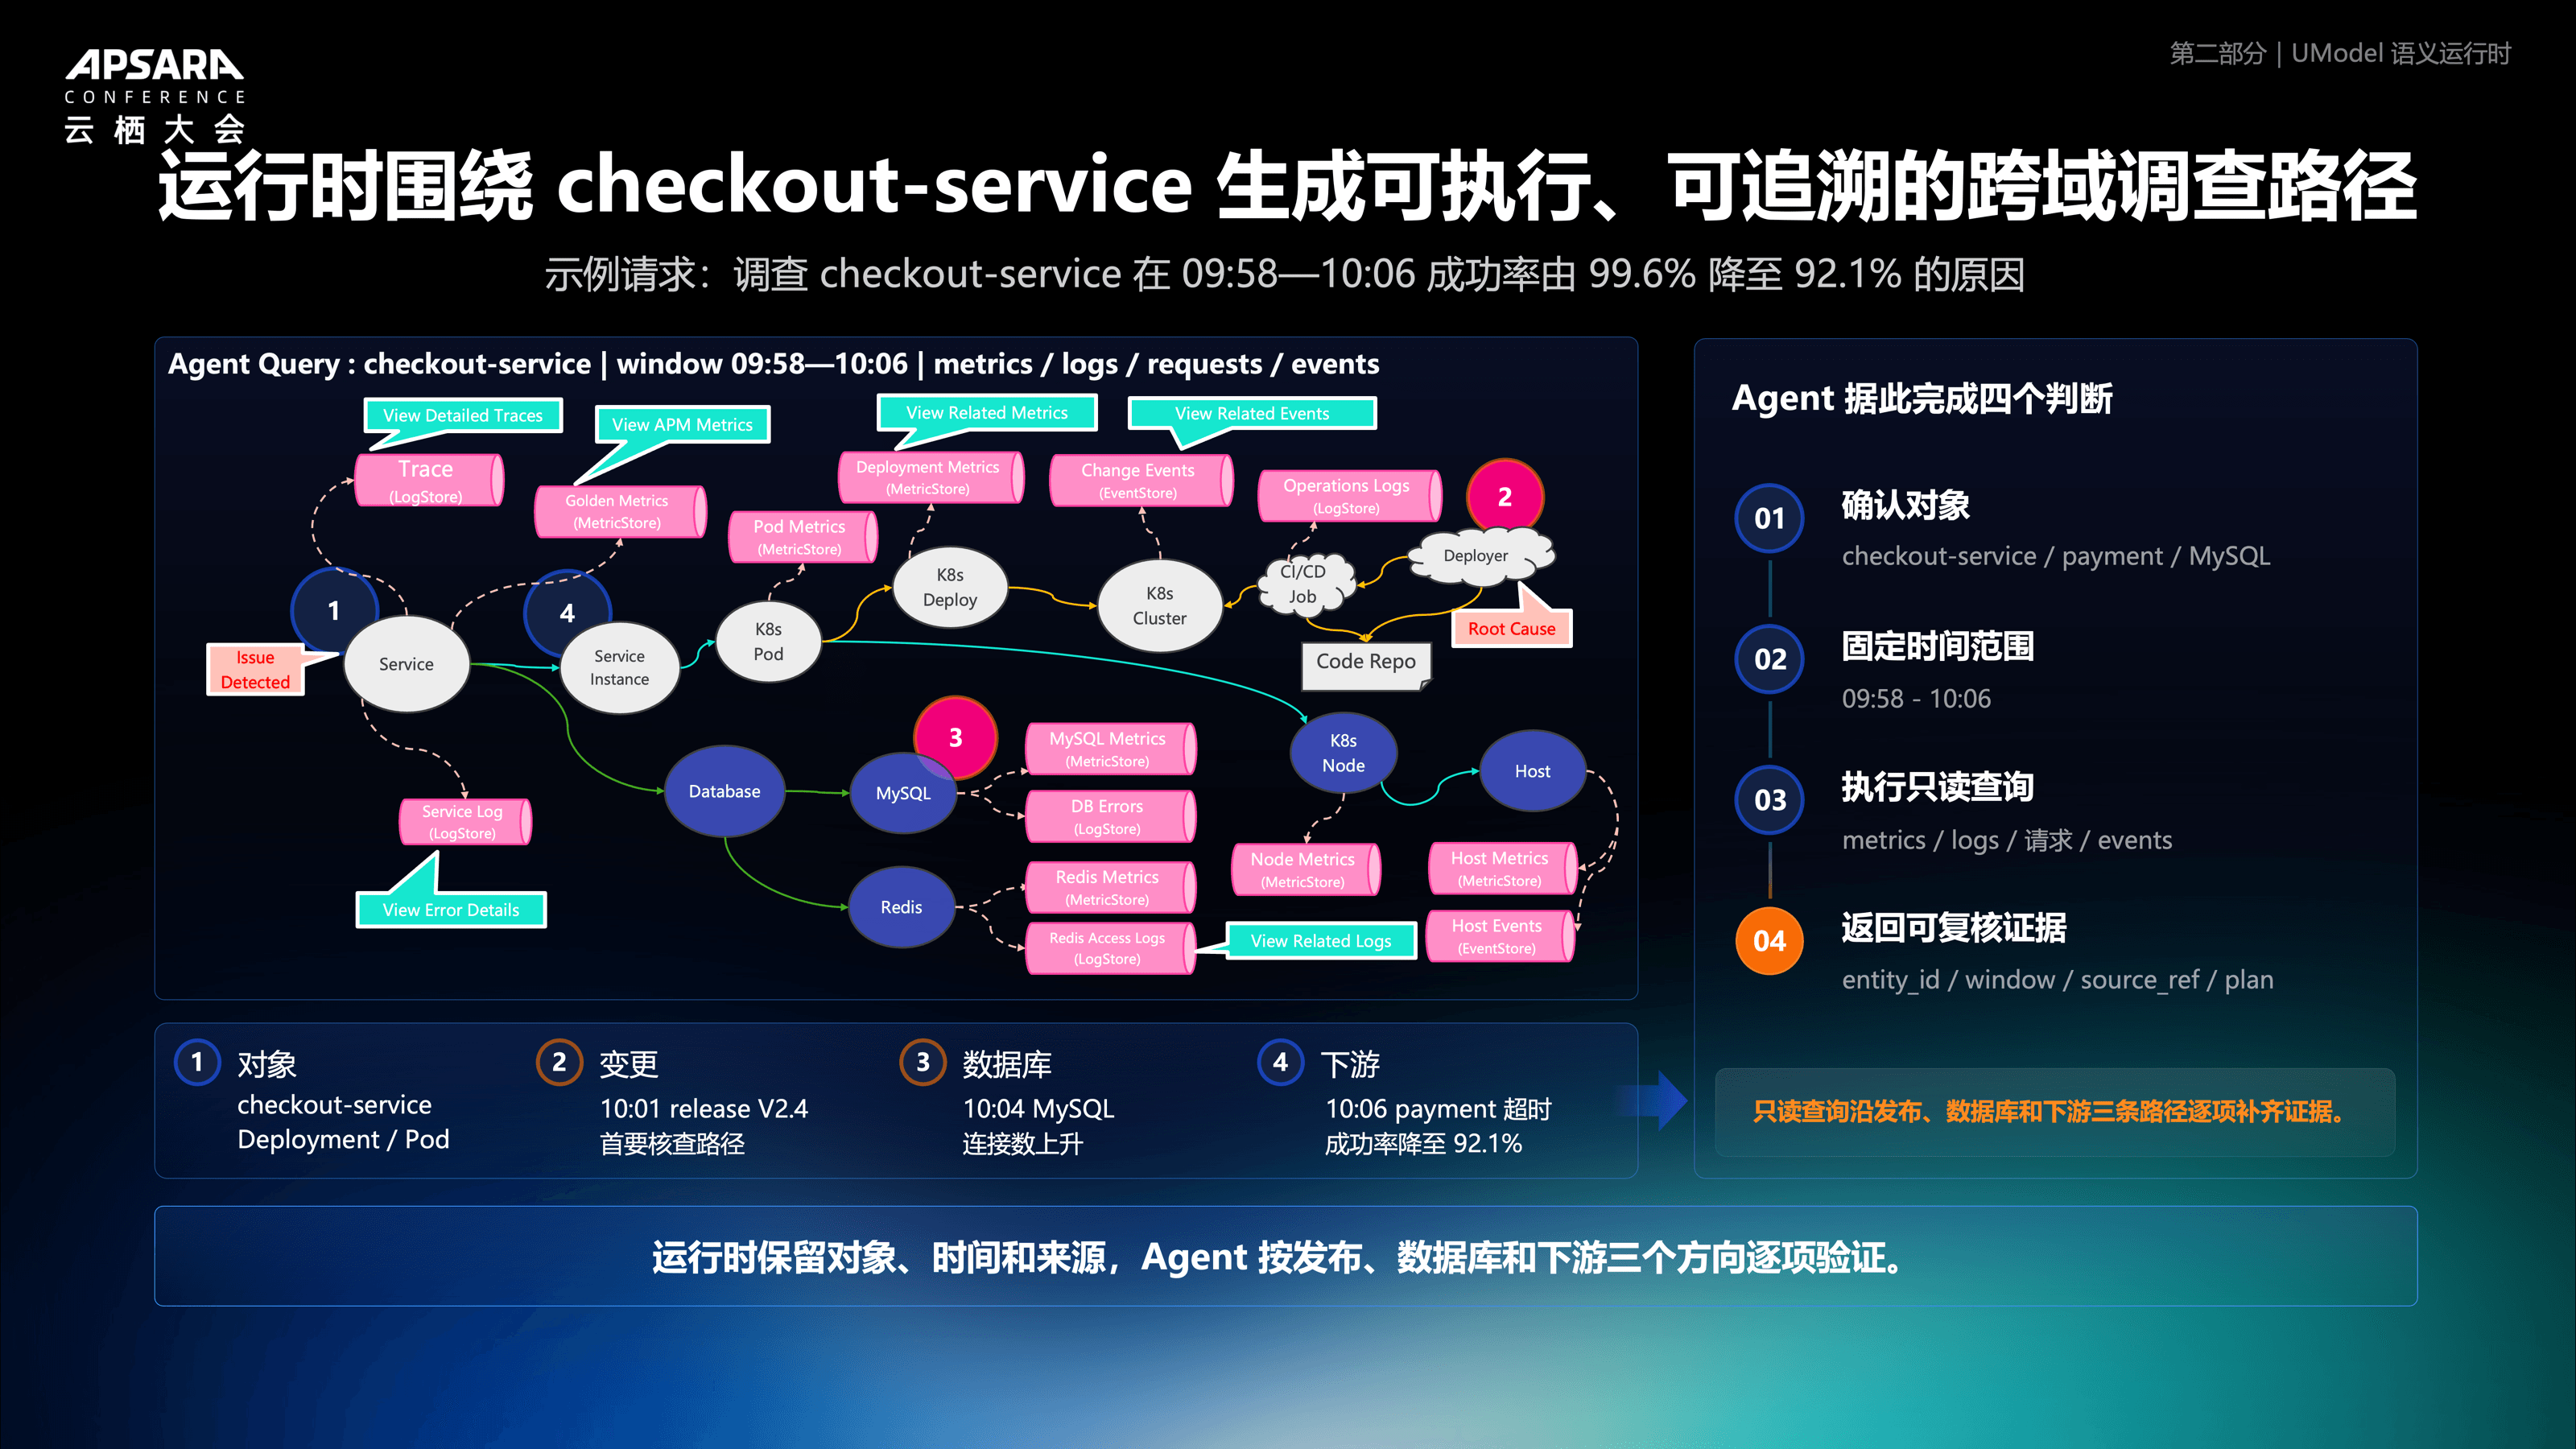
我们来看具体怎么排查,用户的请求很朴素:"请调查 checkout-service 在 09:58—10:06 成功率由 99.6% 降至 92.1% 的原因。"这背后要跨越发布系统、数据库、调用链、监控日志多个数据域。沿着确认的对象和时间窗口,Agent 执行只读的跨域调查,按三条路径逐项补齐证据:
- 变更方向:10:01 发布的 V2.4 版本到底影响了哪些对象;
- 数据库方向:10:04 连接数上升的具体表现和相关日志;
- 下游方向:10:06 payment 超时和 checkout 成功率之间的关系。
这里有一组关键字段是 Agent 必须反馈的:entity_id、window、source_ref、plan。也就是说,Agent 不光要自己排查,还要告诉用户——自己排查的对象是哪个实体、属于哪个时间范围、来自哪里,以及这次调查服务于整体排查链路中的哪一环。这样继续排查下去,就不会丢失最初定义的问题边界。
有了这样的排查记录,人可以复查 Agent 的排查过程是否靠谱,另一个 Agent 也可以按它的排查链路做 validate。通过实验我们发现,这能在不同模型上提高 50% 到 100% 的诊断质量。
(四)UModel 开源建设 :对象图、查询服务与 Agent 已形成公共语义标准
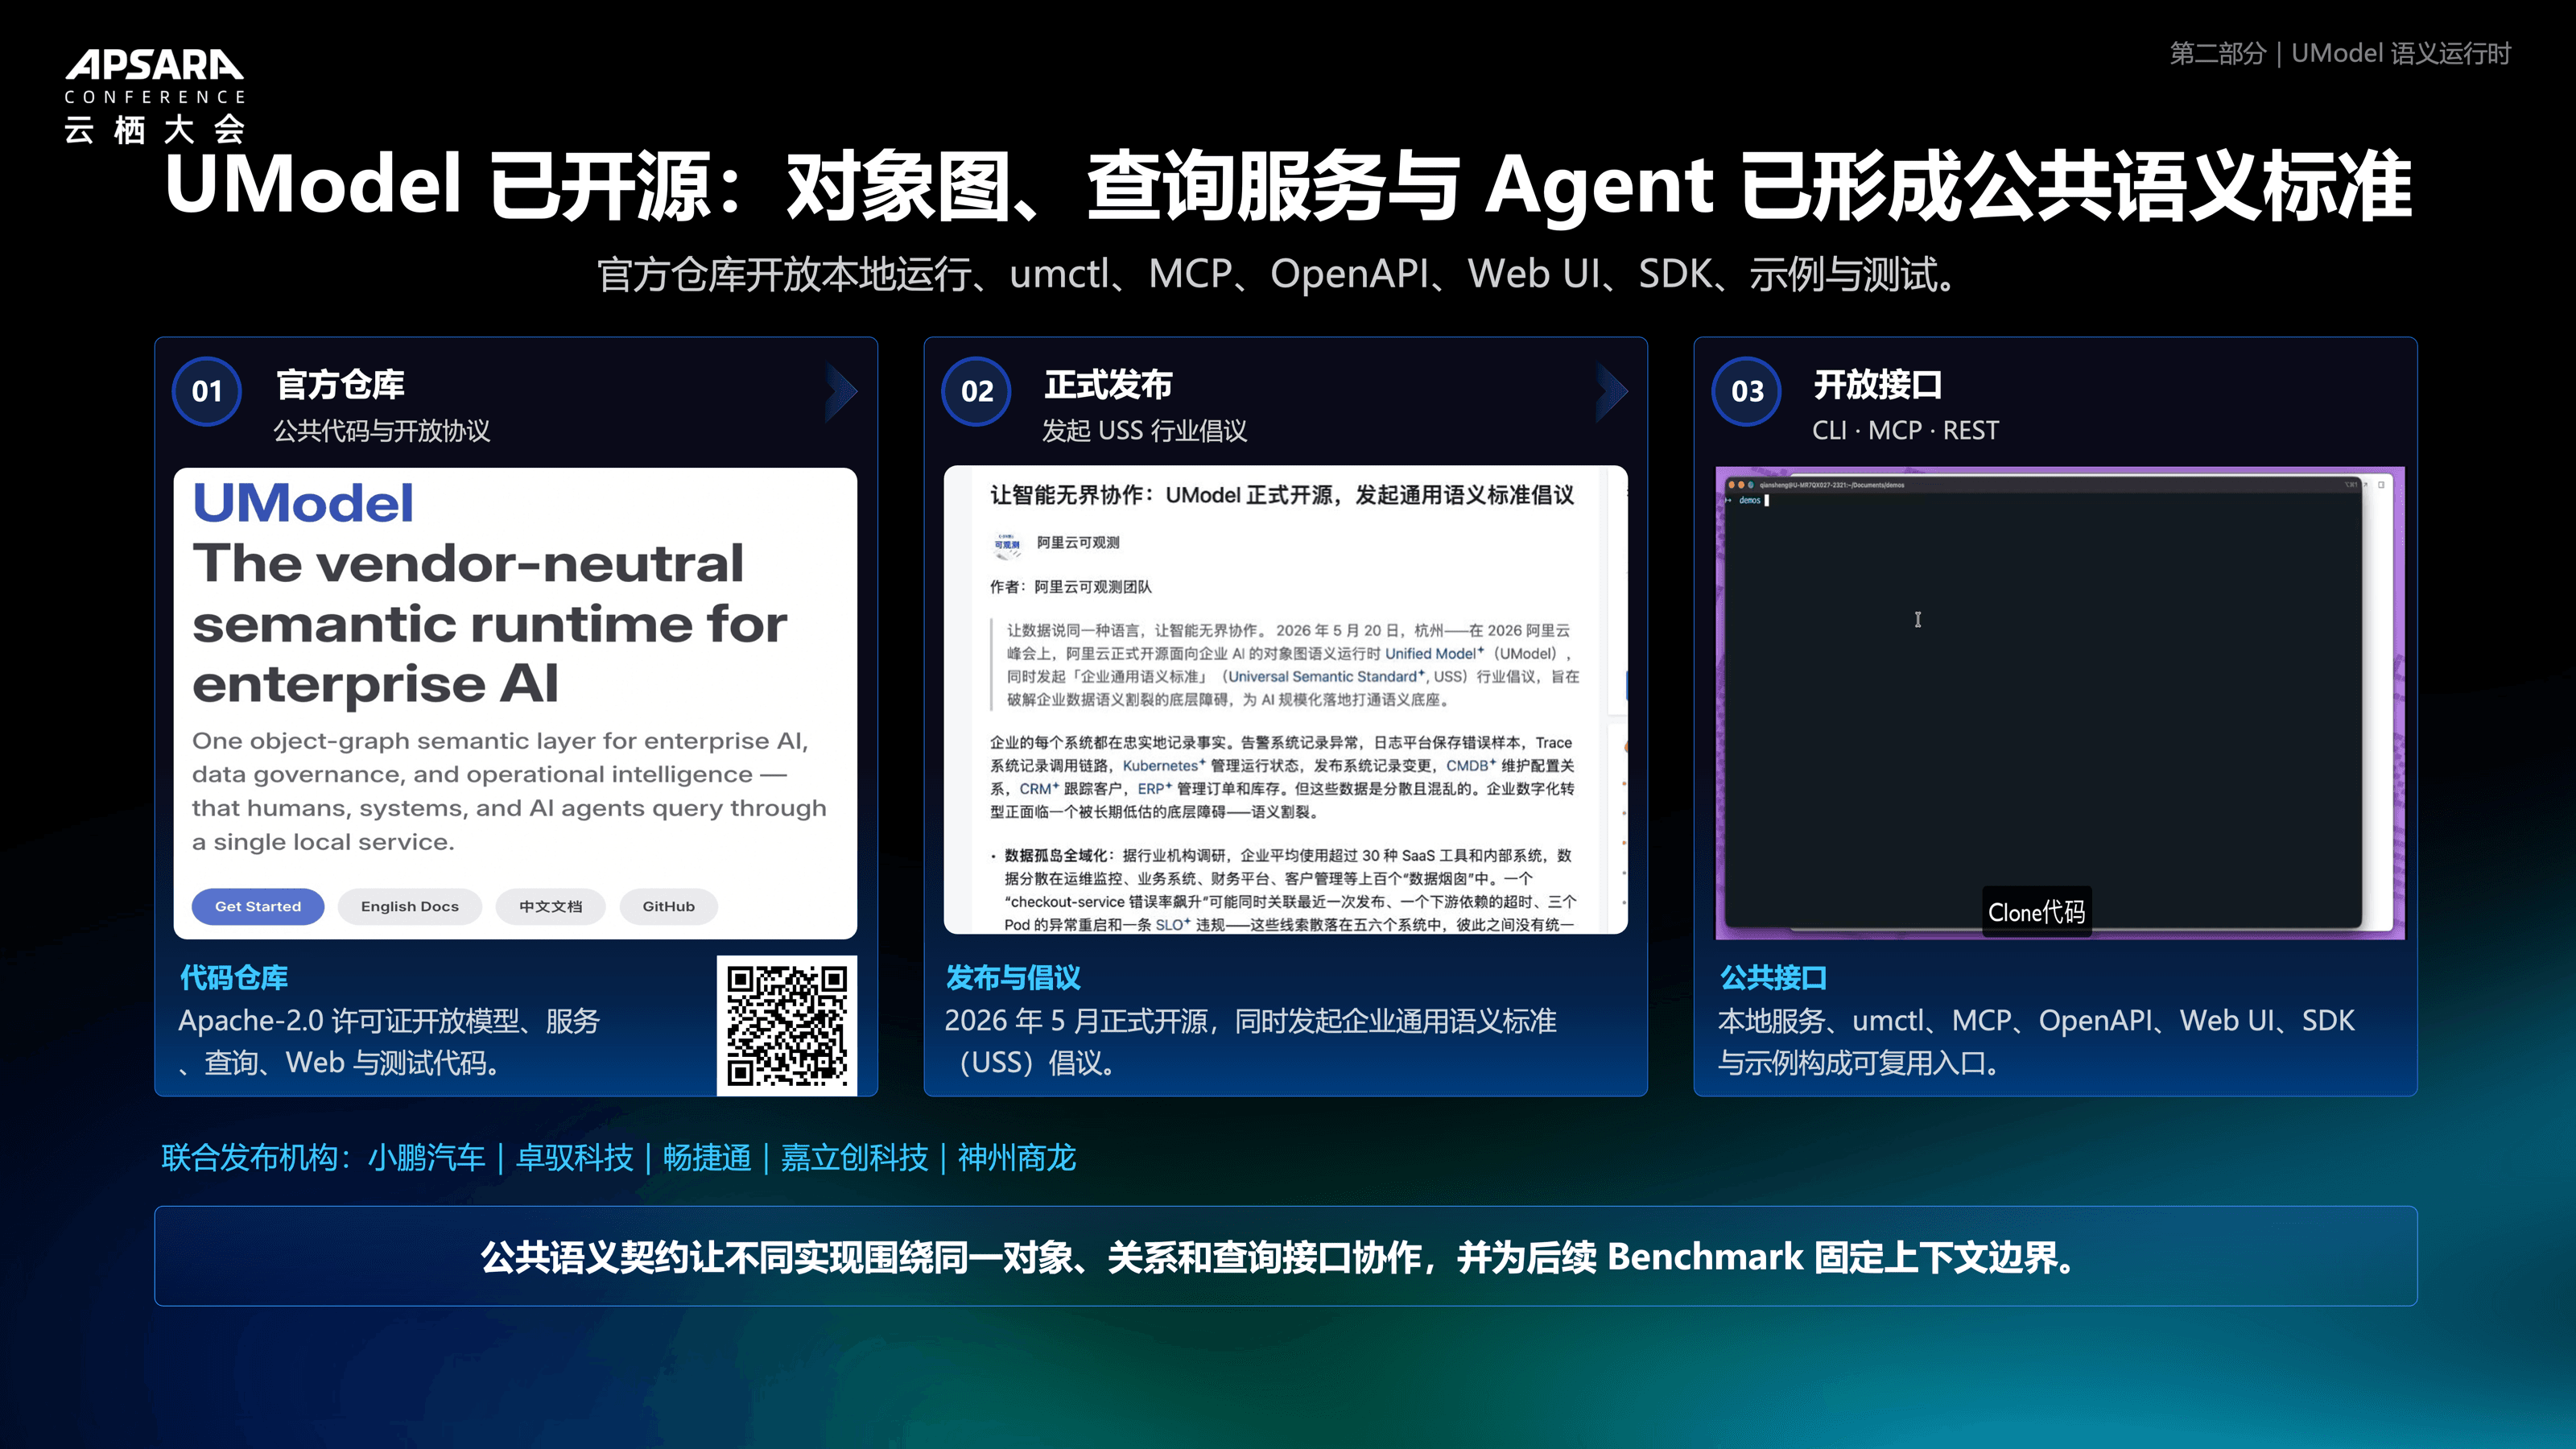
我们希望这种运维数据的语义建模不只内部团队使用,也希望对其他企业开放——尤其是现在大家可能是多云,我们希望不同产品都能用统一的方式建立运维的语义运行时,形成统一的语义规范,这样我们在跨产品问题追踪的时候可以使用相同的一套语言规范。这也是我们开源 UModel 的原因,具体包括三部分:
- 代码仓库:以 Apache-2.0 许可证开放模型、服务、查询、Web 与测试代码。它不只是一个概念或架构图,而是真正可运行、可查询、可接入 Agent 的公共资产。
- 发布与倡议:2026 年 5 月正式开源,同时发起企业通用语义标准(USS)倡议,联合发布机构包括小鹏汽车、卓驭科技、畅捷通、嘉立创科技、神州商龙。
- 开放接口:本地服务、umctl、MCP、OpenAPI、Web UI、SDK 与示例构成可复用入口,适配不同开发者的使用习惯。
统一的语义运行时对评测也很重要:可以固化对象关系、固化问题、固化查询时间与窗口、固化查询入口,这样不同 Agent 面对相同问题时,就能公平地比较分数——这也为后续的 Benchmark 固定了上下文边界。
Benchmark 建设:让能力经得起反复评测
第三道墙是——上下文准备好了,Agent 就一定能做对吗?不见得。Agent 在 Demo 场景下成功定位根因、偶尔在线上生产环境立功,都让人兴奋,但这不足以证明能力是稳定的、可靠的、可以让 SRE 信赖的。真实的系统状态随时在变,故障证据每次都不一样,模型、工具、Skill、提示词也在变。如果每次测试面对的条件都不同,就很难判断提升到底是不是真正的提升。
这本质上是一个系统化的实验设计与评估问题,是数据科学问题。我们要做的是降低它的门槛:把故障环境、故障任务和评分标准固化下来,让同一个问题可以被反复执行、被不同团队执行,从而在相同条件下得到相对公平的比较。BRiSE 就是负责这一部分的。
(一)行业需求决定 Benchmark 应该覆盖哪些真实任务
我们通过阿里云 STAROps 能触达到不同行业的用户,和他们的接触中去深入了解他们日常在做什么、问题背后需要什么样的评测。不同系统使用不同对象,但评测任务都需要说明对象、关系、时间范围、证据来源和交付结果:
| 行业 | 现场的真实问题 | Benchmark 必须保存的上下文 |
| 金融 | 查询互联网防火墙入向中 ANY 访问 ANY 的日志 | 防火墙方向、源和目的、时间范围、日志字段,以及异常请求是否集中在同一服务或路径 |
| 电力 | 看看这个月的情况,日志条数特别大 | 日志量的当前值、历史基线、采集器状态、应用重启和注册状态,以及对应时间窗口 |
| 制造 | 巡检 MongoDB 资源,再分析 Redis Top500 大 Key | 数据库实例、容量和慢查询,大 Key 占用、最近使用时间,以及应用和生产任务关系 |
| 通信 | 查询过去两小时 SLS 呼叫数据,识别接通率异常 | 号码池、时间范围、呼叫量、接通率、未响铃号码及其历史基线和异常持续时间 |
| 电商 | 对应用执行 RUM 页面性能和 API 异常巡检 | 页面流量、FCP/LCP、API 错误、异常堆栈、当前窗口和基线窗口,以及受影响页面 |
一个共同的启示是:关键词查到了,不代表题就答对了。比如金融场景听起来只是查日志,实际上必须明确方向、源、目的、时间范围和字段含义,才能判断异常请求是否集中在某个服务或路径上。
(二)可以重复评测和优化的流水线
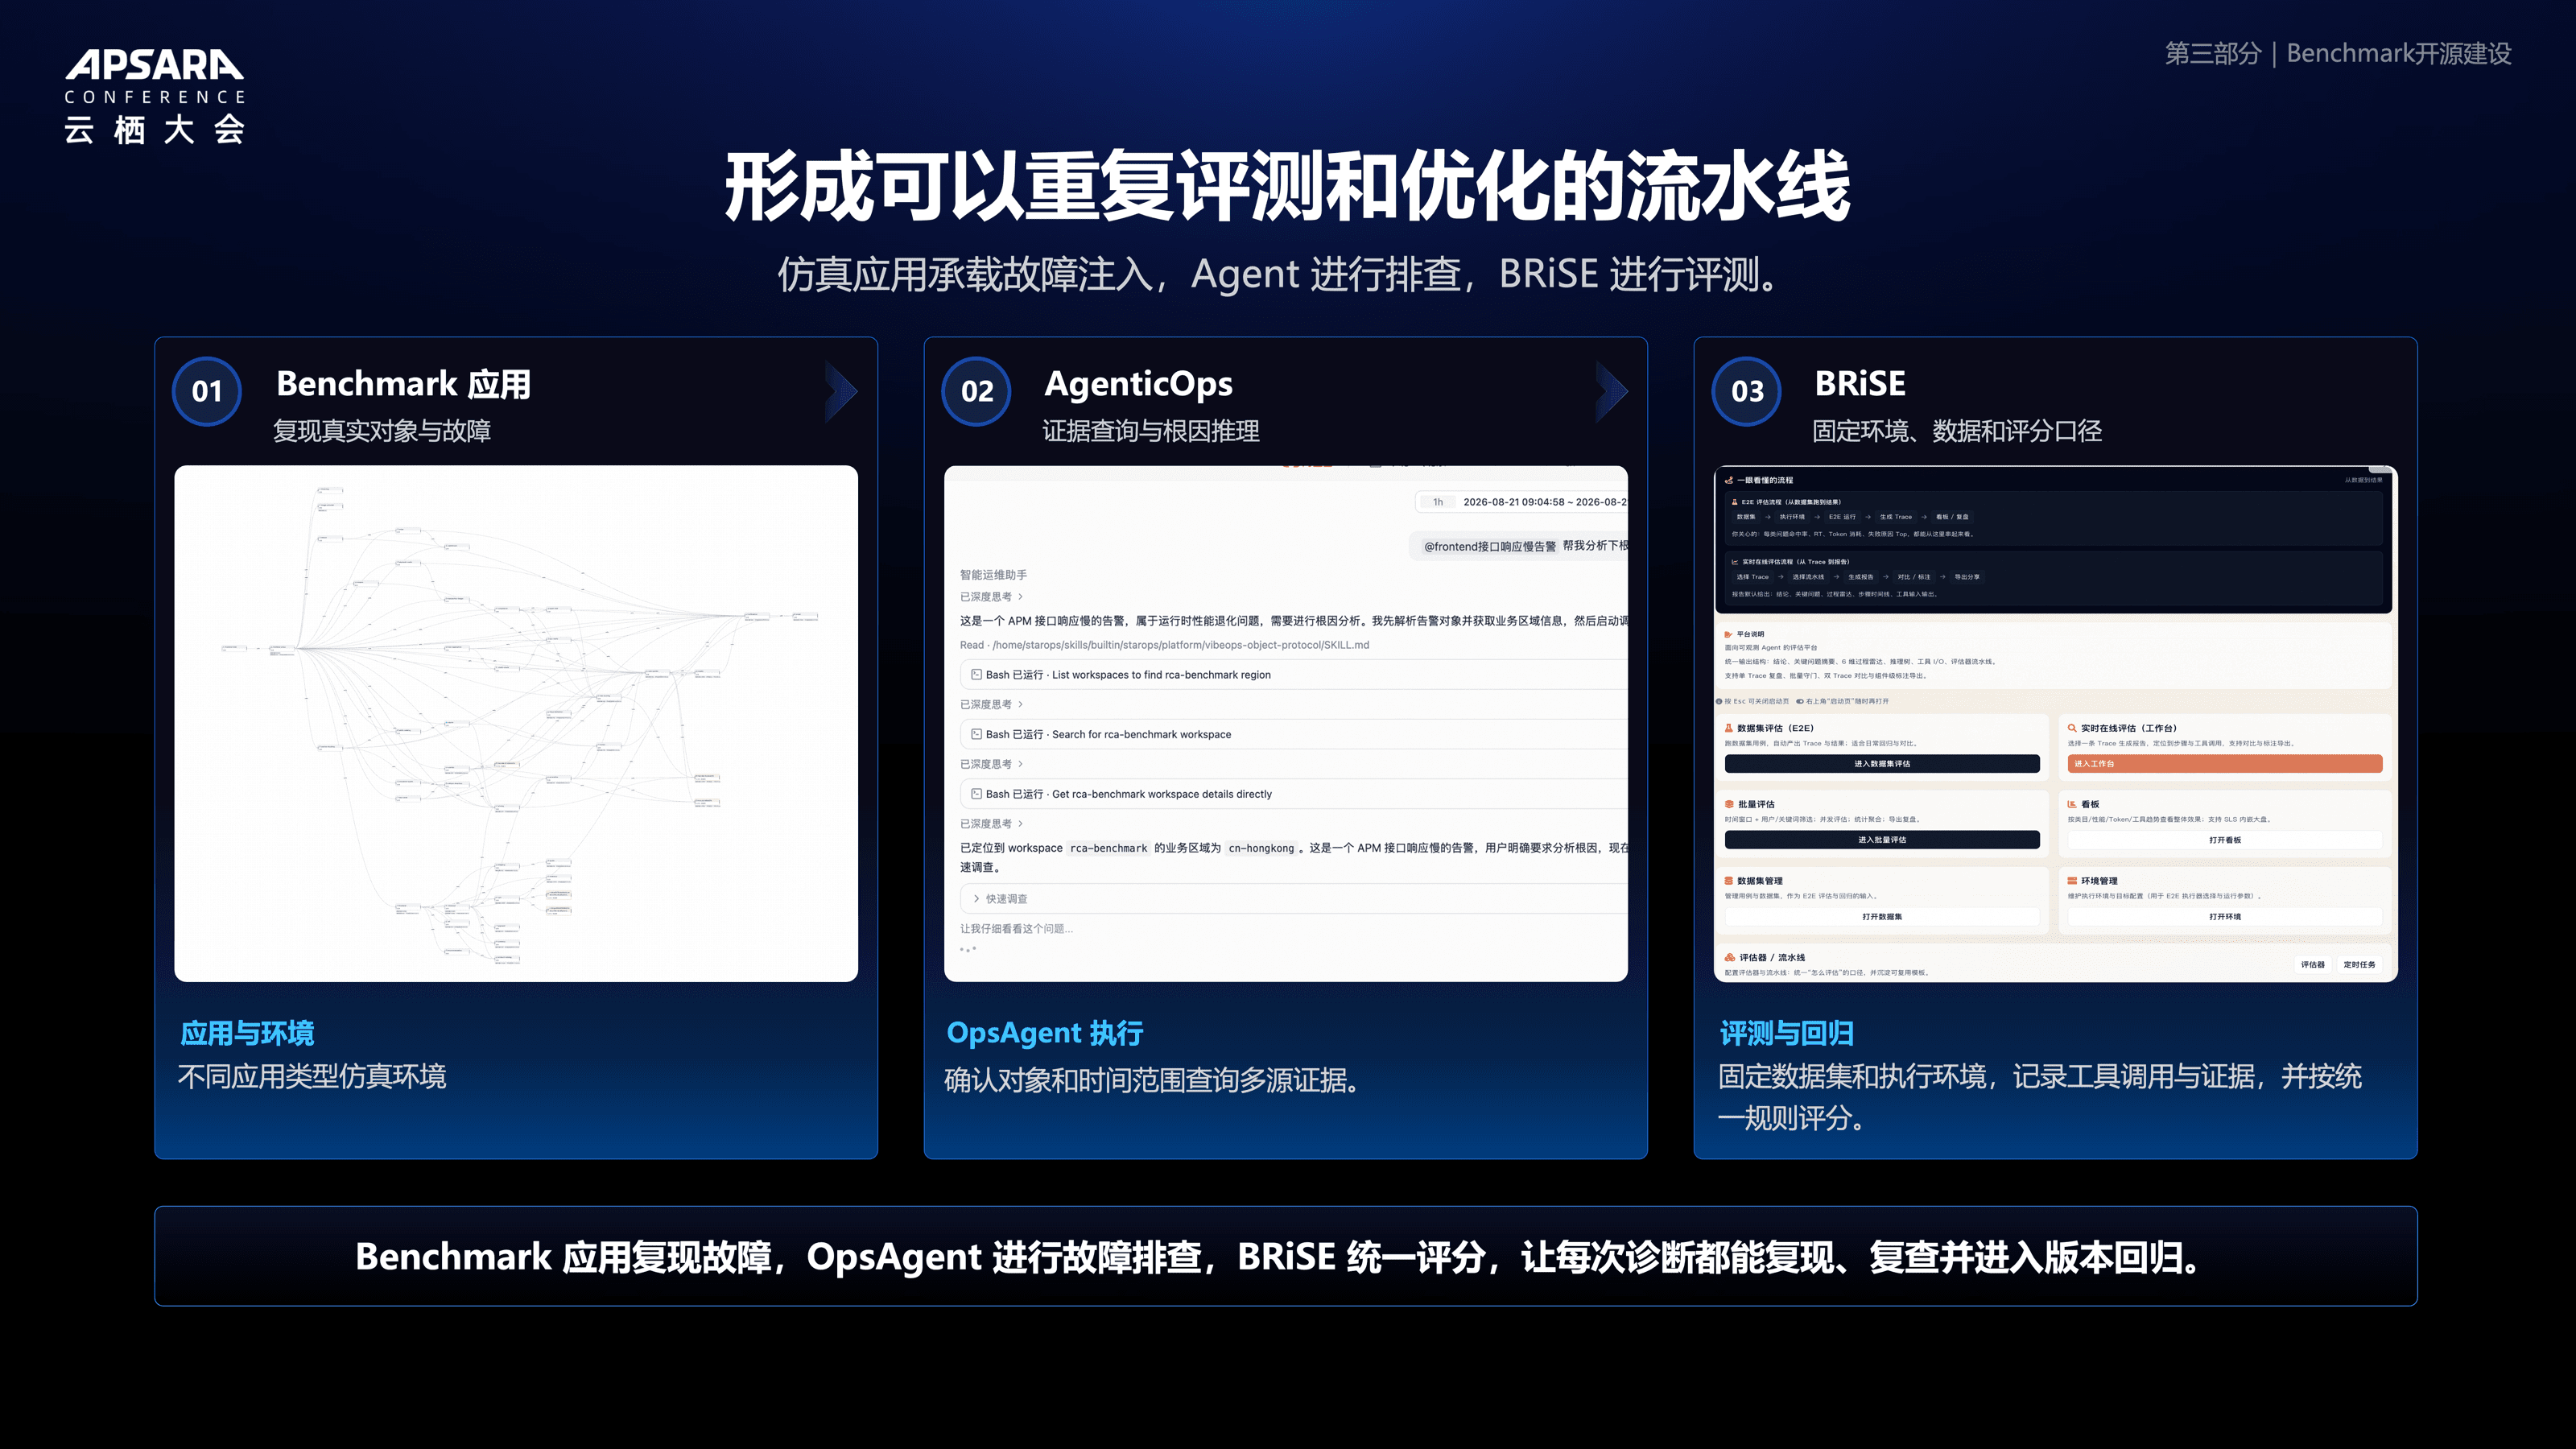
要验证这项工作,整个流程里有三个角色分工明确:
- Benchmark 应用:复现真实对象与故障数据。它负责提供问题发生的环境——"Checkout Service 过去一段时间成功率下降,什么原因"这句话的背后,是一个非常复杂的仿真应用和大量故障注入。
- OpsAgent(被测 Agent):证据查询与根因推理。可以是 STAROps Agents、任意 Ops Agents,或通用 Agents,负责确认对象和时间范围、查询多源证据,我们记录它的排查过程和结论。
- BRiSE:固定环境、数据和评分口径,统一评分。
把这三件事分开,就能分别检查:题目是否有效、有难度、有区分度;Agent 是怎么做的;结果怎么判断。固定数据集和执行环境,记录工具调用与证据,按统一规则评分——让每次诊断都能复现、复查并进入版本回归。
(三)面向真实生产环境的场景覆盖
我们评测到底评什么?我们看到目前的一些工作主要围绕故障定位——这是运维任务皇冠上的明珠。很多很棒的开源 Benchmark 也主要围绕 RCA,比如 OpenRCA 1.0/2.0、SREGym、AIOpsLab等。但我们发现它们和日常运维工作还有点距离。把日常工作分成三种后可以看到,巡检和异常分析这类自动化任务其实占了大头,而现有 Benchmark 极少关注:
| 场景 | 内部使用占比 | Benchmark 覆盖 |
| 数据查询 | ~10% | 知道查什么,并取得正确数据 |
| 巡检与异常分析 | ~70% | 在多源数据中识别异常模式 |
| 故障诊断 | ~10% | 围绕真实故障完成诊断 |
据此,BRiSE 按证据复杂度分层,构建了三类任务集,每道题都能在固定对象和时间范围内复跑:
- 数据查询(L2):1,360 道任务,每道题记录对象、时间范围、可用工具、预期结果和查询正确率。示例:查询指定应用过去 30 分钟的请求错误率;列出 CPU 最高的 5 台主机并返回聚合口径。
- 巡检与异常分析(L3):418 个任务,覆盖 11 类证据源、19 个技术域、1,576 项可观测证据信号,每个任务记录异常模式、证据匹配规则和评分方法。示例:识别 K8s Pod 重启、资源压力和副本异常;从日志聚类中找出新增或突增的异常模式。
- 故障诊断(L4):764 个 Case,覆盖 150+ 类故障、20+ 云产品,每个 Case 记录故障环境、Ground Truth、证据链和过程评分器。示例:判断流量突增如何影响下游调用与告警;区分代码延迟、依赖故障和发布变更。
每一级都记录对象、时间范围、可用工具、预期输出和评分规则,因此可以在不同模型、Harness 和查询工具之间复用。
(四)产业界、学术界与跨领域的评测实践
明确了用户需要什么,我们再退一步看产业界、学术界和其他 Agentic 领域是怎么做评测的:
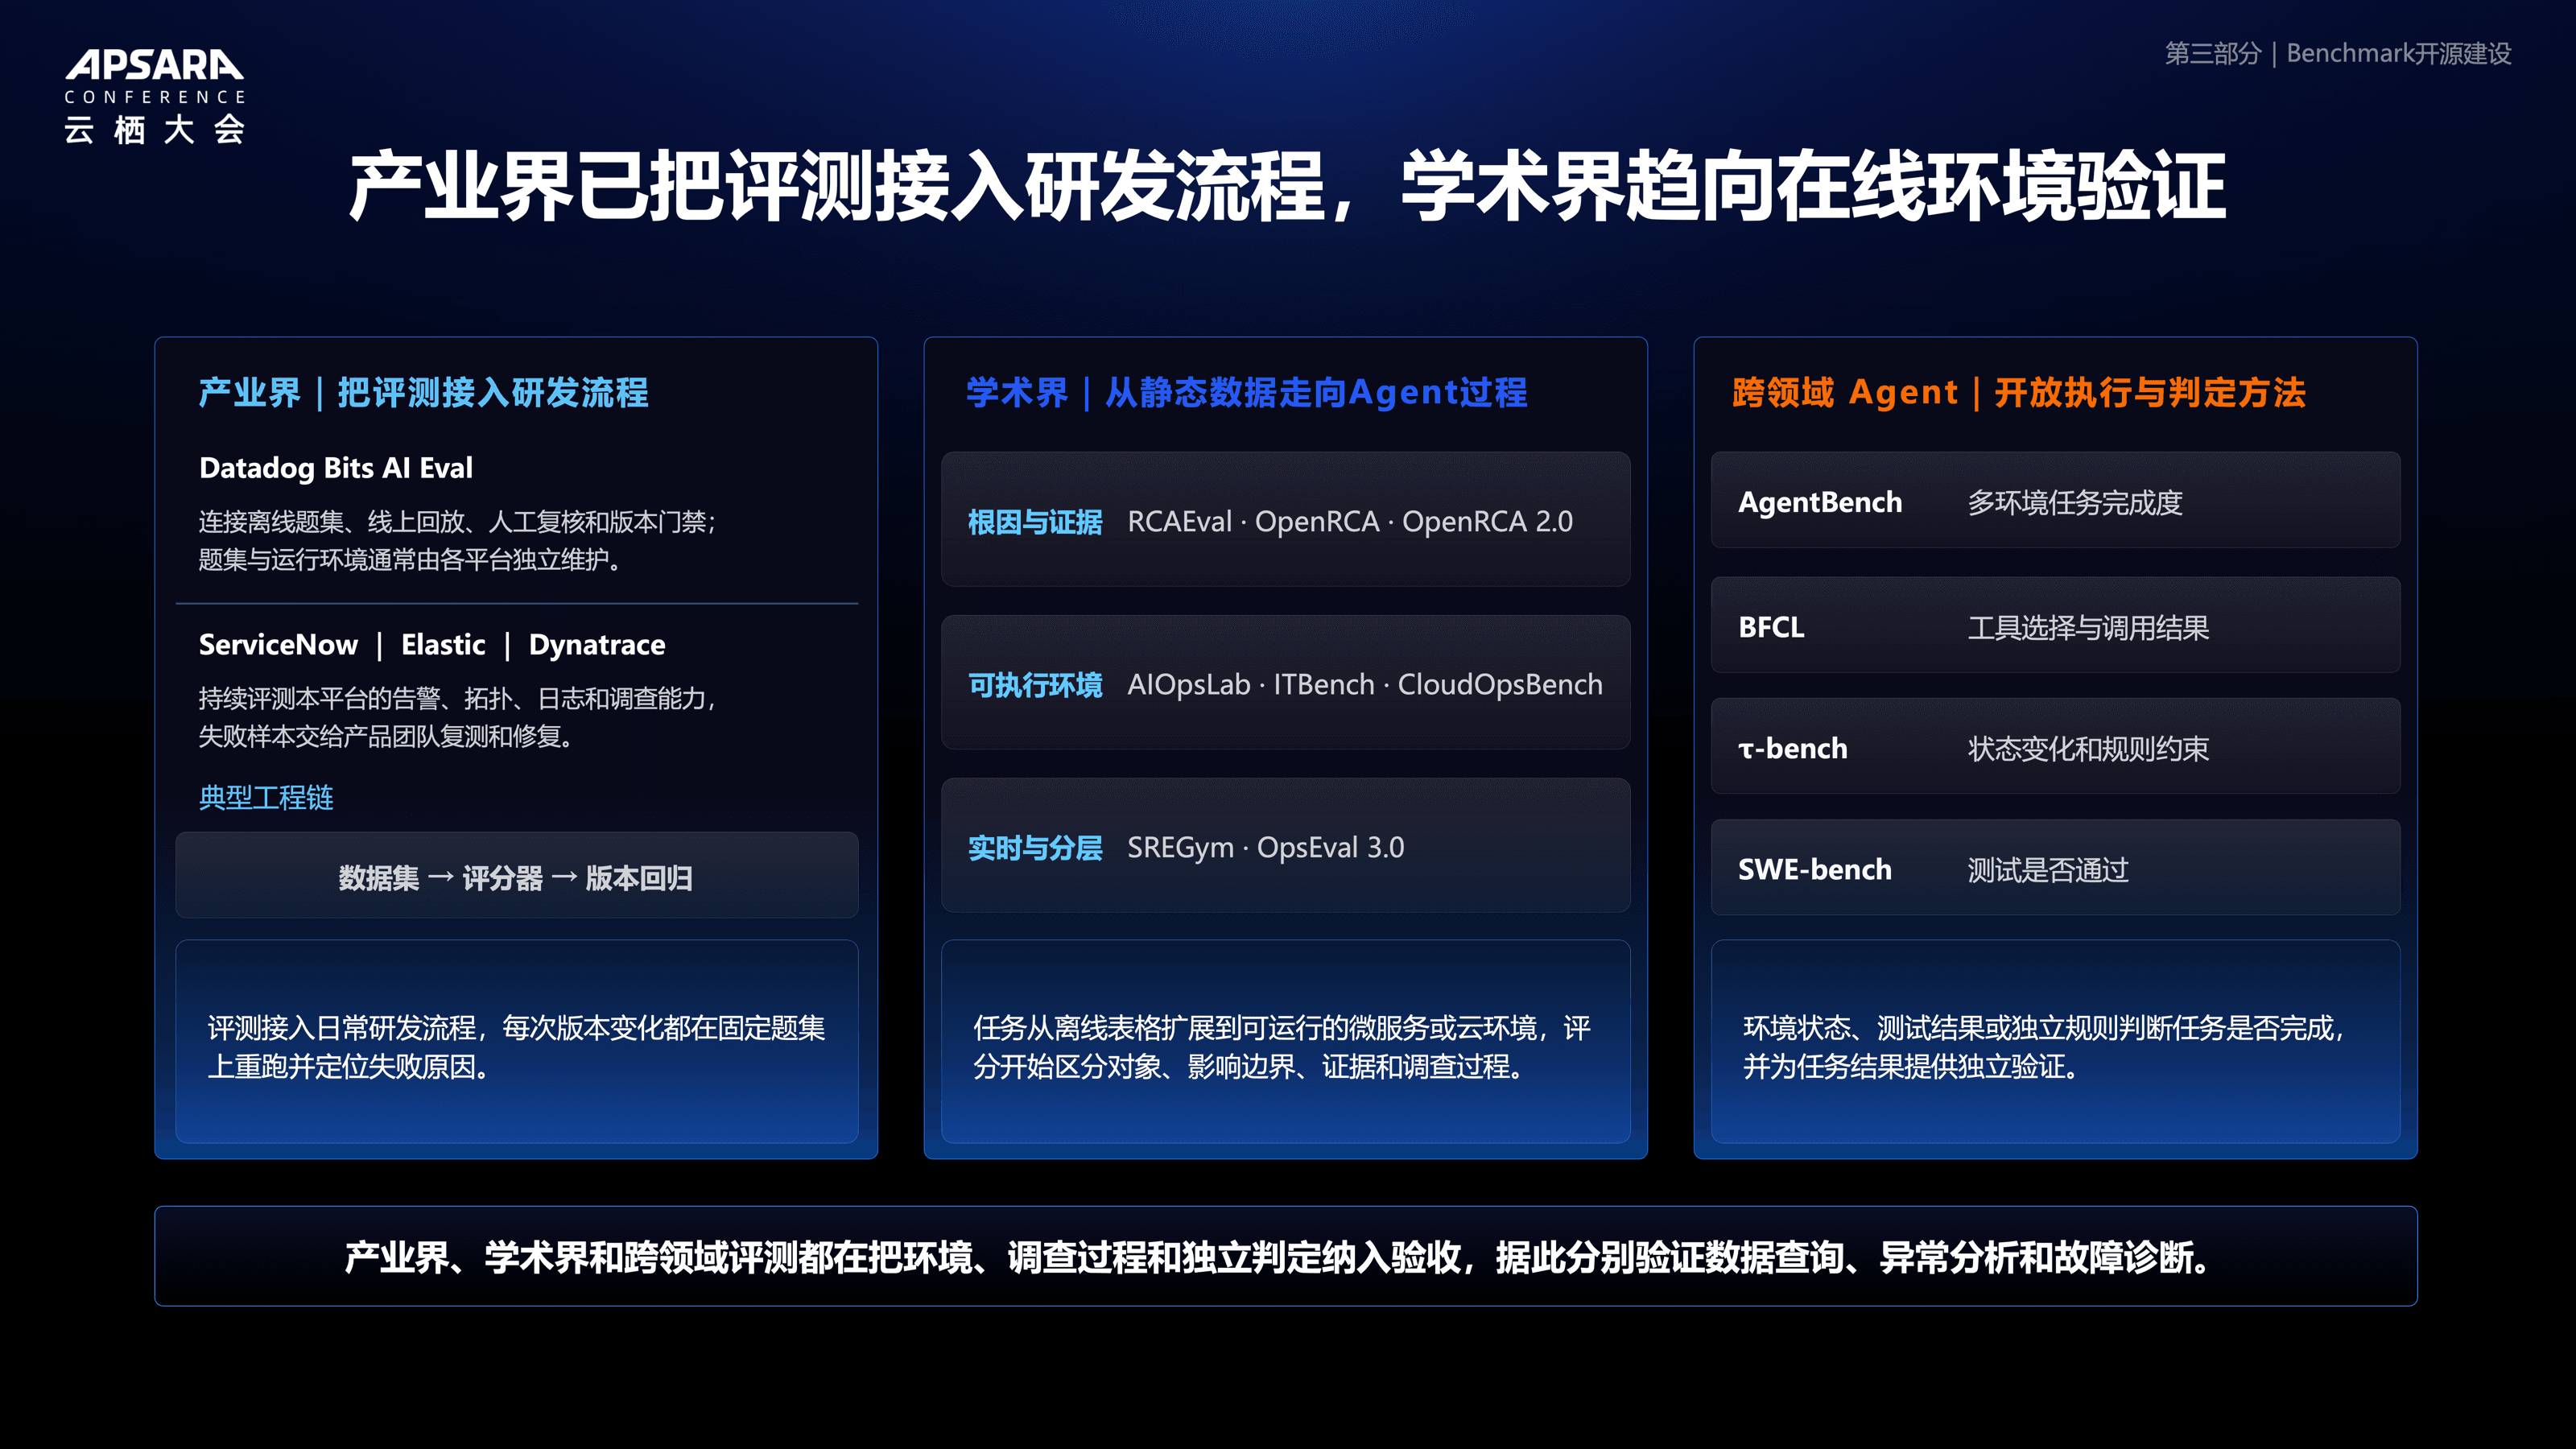
- 产业界|把评测接入研发流程:Datadog(Bits AI Eval)持续评测本平台的告警、拓扑、日志和调查能力,失败样本交给产品团队复测和修复;ServiceNow、Elastic、Dynatrace 连接离线题集、线上回放、人工复核和版本门禁。典型工程链是"数据集 → 评分器 → 版本回归",每次版本变化都在固定题集上重跑并定位失败原因。
- 学术界|从静态数据走向 Agent 过程:RCAEval、OpenRCA、OpenRCA 2.0 关注根因与证据;AIOpsLab、ITBench、CloudOpsBench 提供可执行环境;SREGym、OpsEval 3.0 强调实时与分层。任务从离线表格扩展到可运行的微服务或云环境,评分开始区分对象、影响边界、证据和调查过程。
- 跨领域 Agent|开放执行与判定方法:SWE-bench 看测试是否通过,AgentBench 看多环境任务完成度,BFCL 看工具选择与调用结果,τ-bench 看状态变化和规则约束。它们都通过环境状态、测试结果或独立规则判断任务是否完成——这提示我们,判断任务是否完成,要独立于 Agent 自己说的话,看它背后的轨迹是否合理。
(五)RCA100/200 已发布,社区持续共建
针对故障诊断,我们也发布了 RCA 数据集,收到积极的社区反馈。RCA100/200 已经发布,访问来源覆盖 36 个国家或地区、92 个城市,约 2.1 千个不同访问。故障大类分布广泛——应用代码/运行时、微服务依赖/自建中间件、K8s/容器平台、主机/OS、云产品实例、网络、LLM/Agent、流量/安全等。
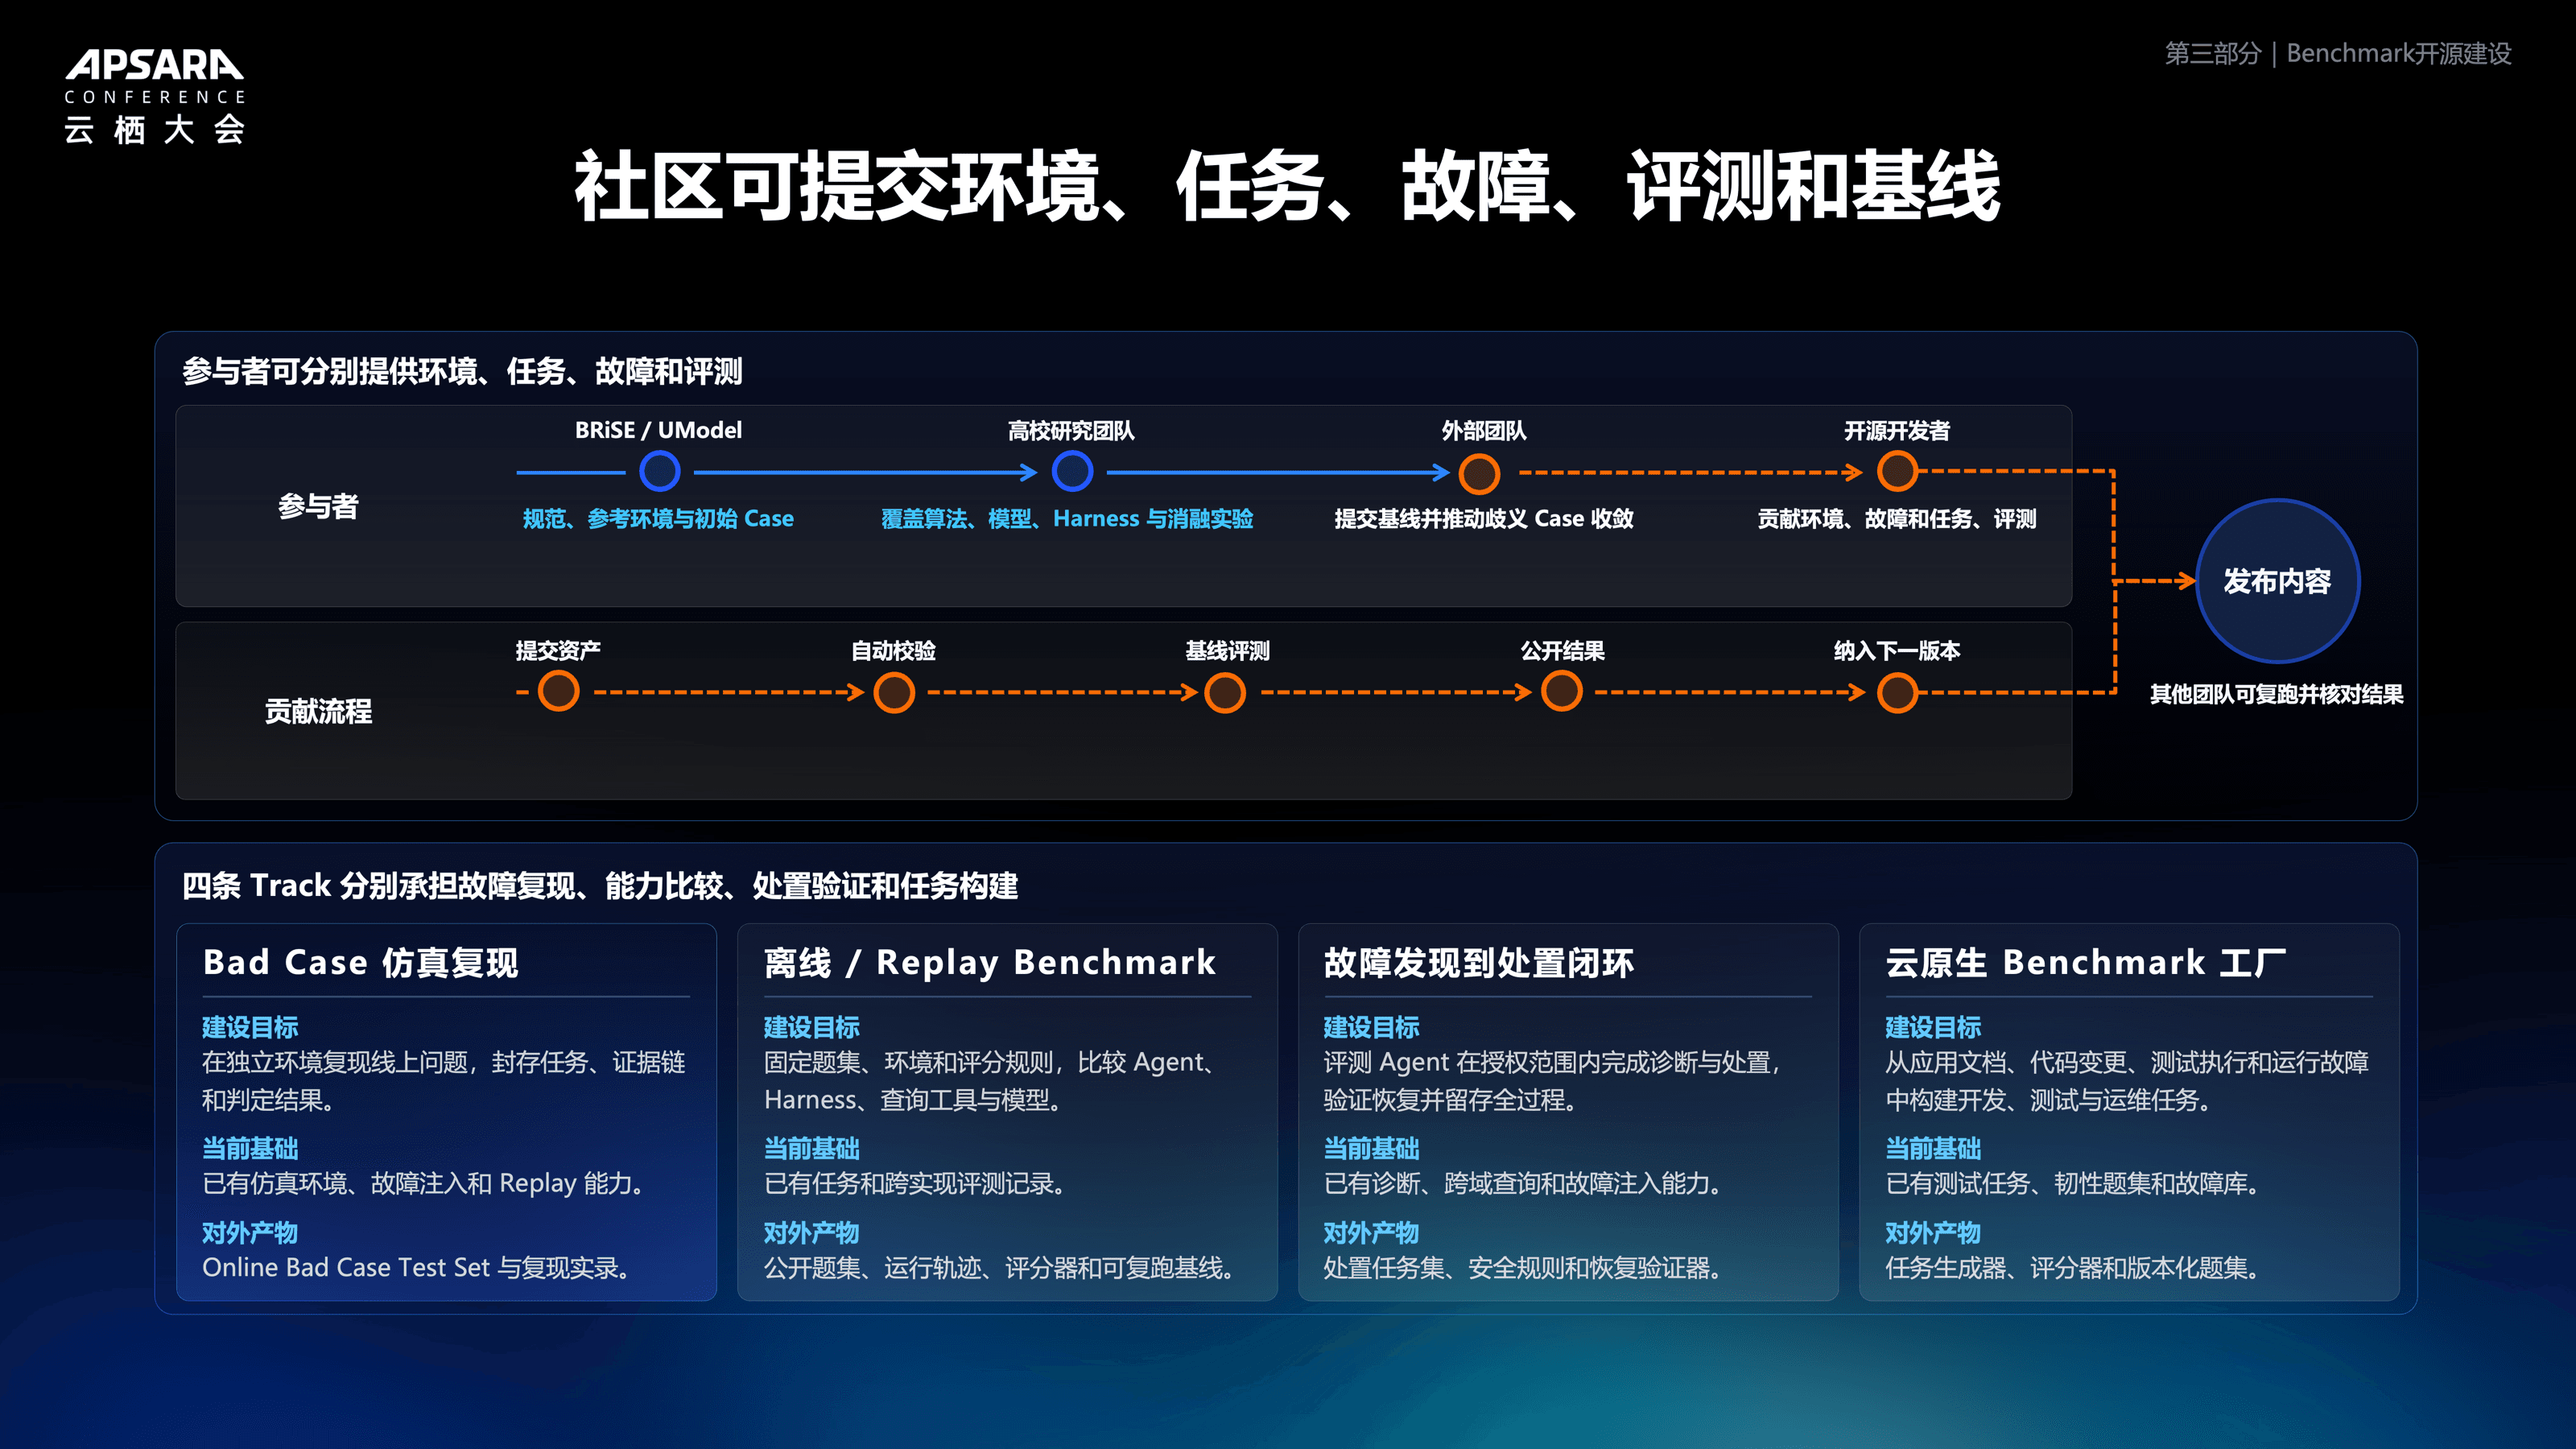
BRiSE 的开源建设由社区共同推进,四类参与者沿同一发布流程(提交资产 → 自动校验 → 基线评测 → 公开结果 → 纳入下一版本)协作:
- BRiSE / UModel:提供规范、参考环境与初始 Case;
- 高校研究团队:覆盖算法、模型、Harness 与消融实验;
- 外部团队:提交基线并推动歧义 Case 收敛;
- 开源开发者:贡献环境、故障、任务和评测。
对外,我们规划了四条 Track,分别承担不同工作:
| Track | 建设目标 | 对外产物 |
| Bad Case 仿真复现 | 在独立环境复现线上问题,封存任务、证据链和判定结果 | Online Bad Case Test Set 与复现实录 |
| 离线 / Replay Benchmark | 固定题集、环境和评分规则,比较 Agent、Harness、查询工具与模型 | 公开题集、运行轨迹、评分器和可复跑基线 |
| 故障发现到处置闭环 | 评测 Agent 在授权范围内完成诊断与处置,验证恢复并留存全过程 | 处置任务集、安全规则和恢复验证器 |
| 云原生 Benchmark 工厂 | 从应用文档、代码变更、测试执行和运行故障中构建开发、测试与运维任务 | 任务生成器、评分器和版本化题集 |
其中故障处置这一 Track 尤其需要谨慎——从故障发现到处置再到闭环,比过去的能力更进一步,需要定义非常合理、严谨的评测规范,可靠地验证系统是否正常恢复,并确保在安全边界内恢复。云原生 Benchmark 工厂则依托阿里云牵头的国家重点研发计划项目,与中科院软件所、清华、复旦、南开等高校合作团队共建,面向软件开发、测试、运维全生命周期的自动 Benchmark 构造。
结语
今天我们讲了三部分:采集把运行事实可靠地带回来,UModel 围绕故障对象组织调查上下文,BRiSE 用可复现的 Benchmark 度量 Agent 能力。三者共同构成由社区持续建设的 AgenticOps 开源底座。
我们希望能把运行事实通过采集可靠地拉回来,再让 Agent 清楚地获取任务所需要的调查上下文,最后让 AgenticOps 的能力经得起反复的、重复的评测。
AgenticOps 能力要走向生产,需要的不只是更强的模型,而是这样一套持续建设的工程基础。