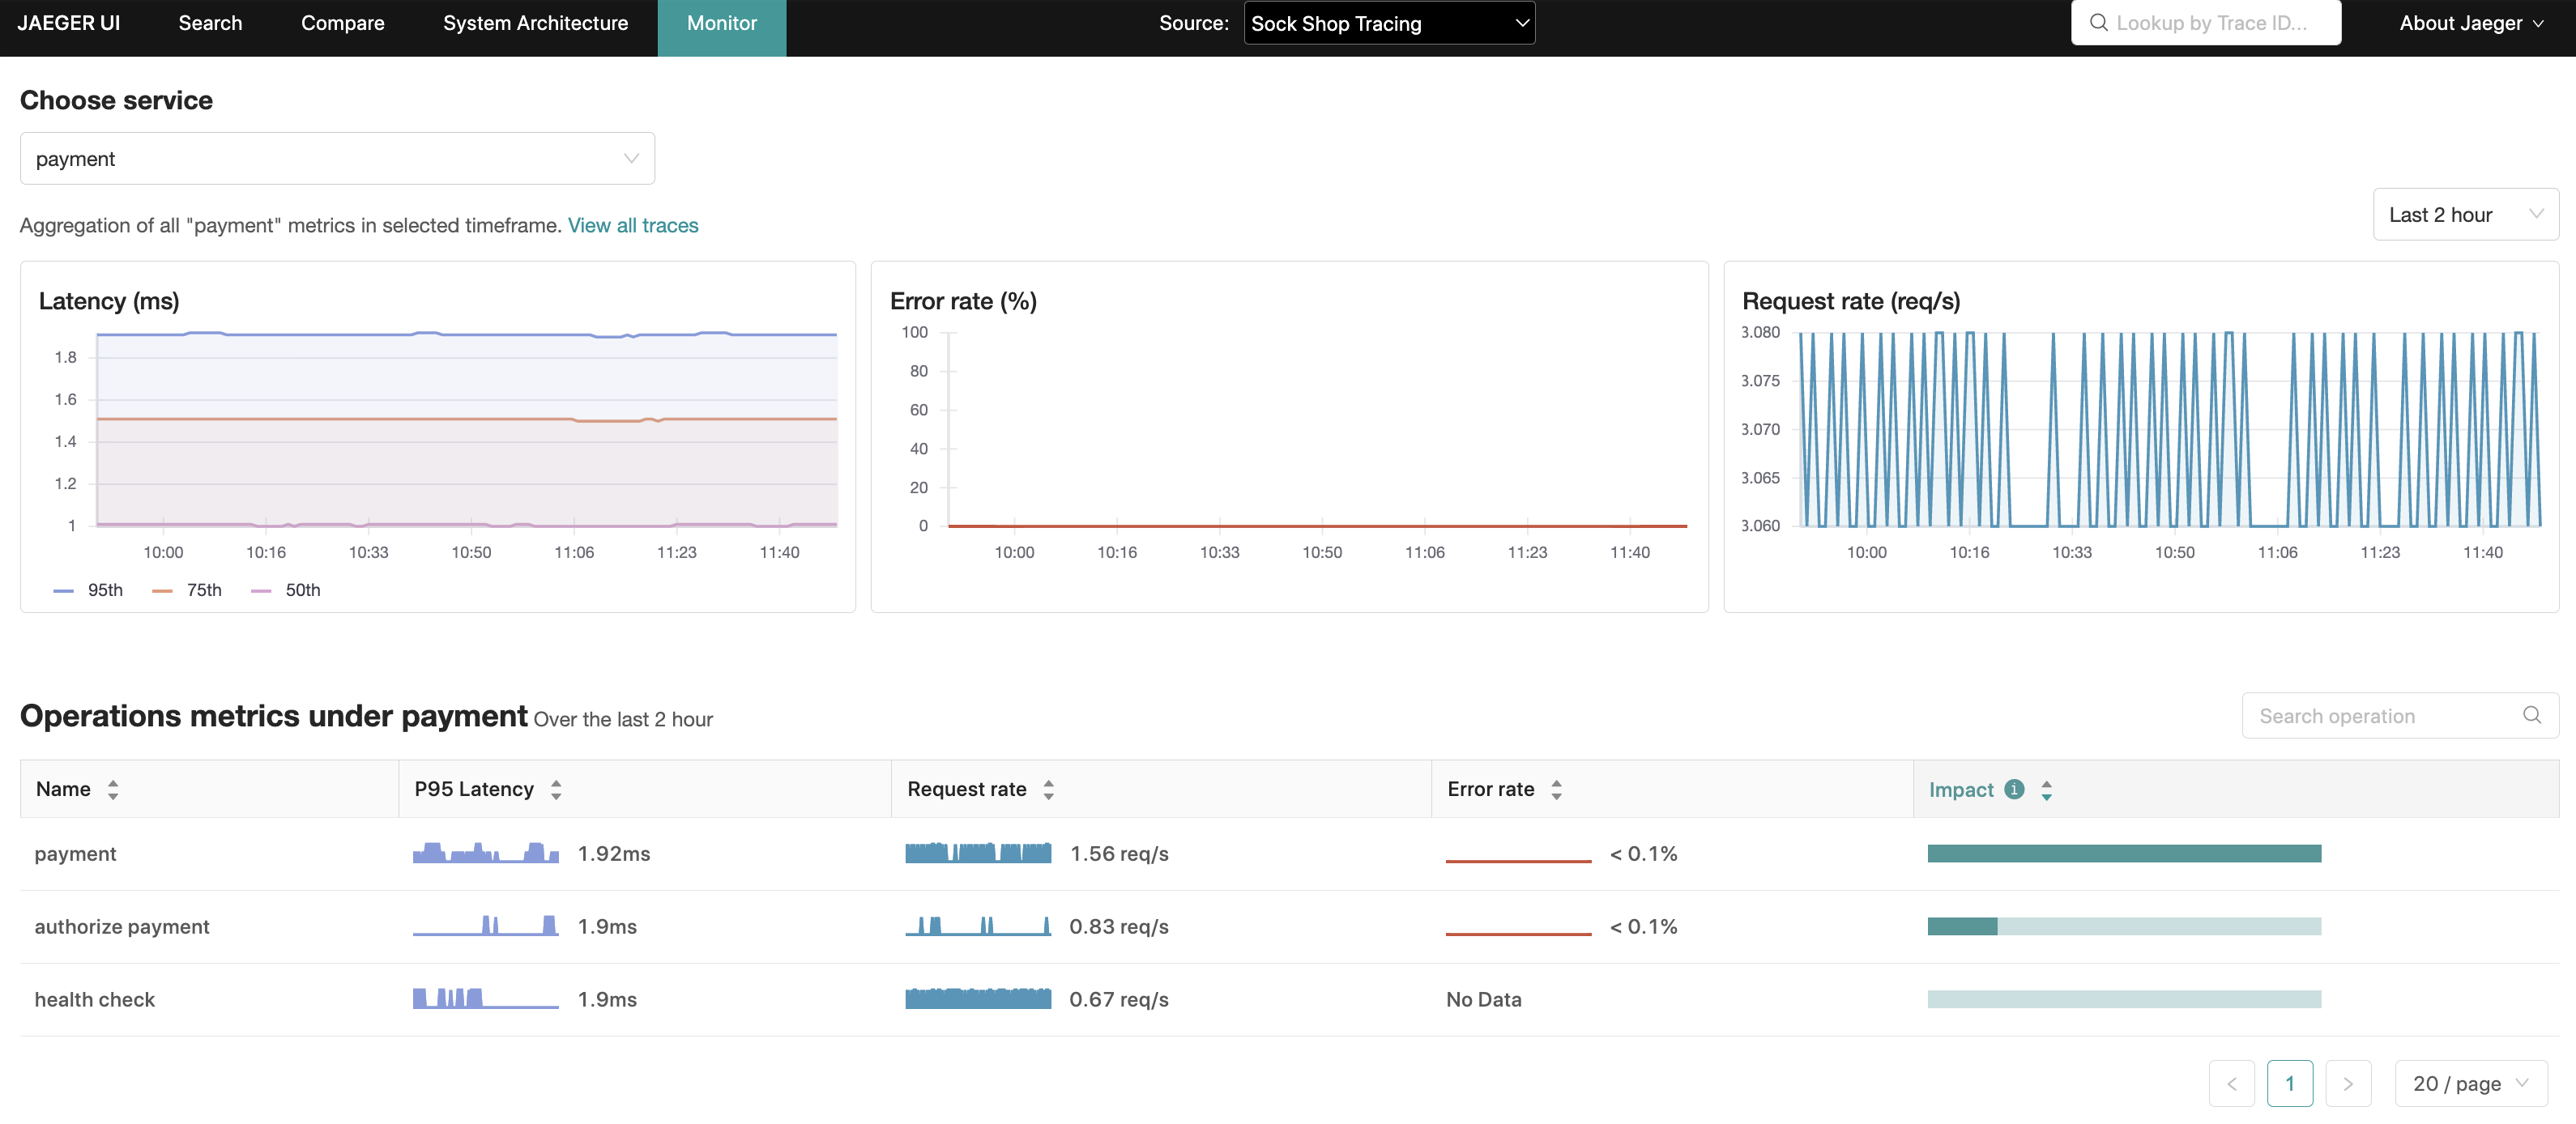
该功能在 Jaeger UI 中以"Monitor"选项卡的形式展现,其设计目的是
帮助识别有价值的追踪数据(例如高 QPS、慢请求或错误请求),
而无需事先知道服务名称或操作名称。
其本质上是通过聚合 span 数据来生成 RED
(请求率、错误率、持续时间)指标。
潜在的使用场景包括:
- 部署后在整个组织范围内,或对请求链路中已知的依赖服务进行健全性检查。
- 在收到告警后进行监控和根因分析。
- 为 Jaeger UI 新用户提供更好的入门体验。
- 对 QPS、错误率和延迟进行长期趋势分析。
- 容量规划。
UI 功能概览
"Monitor"选项卡提供服务级别的聚合,以及服务内操作级别的
请求率、错误率和持续时间(P95、P75 和 P50)聚合,
也称为 RED 指标。
在操作级别的聚合中,"Impact"指标(计算方式为延迟与请求率的乘积)
是另一个有用的信号,可以用来
排除那些天然具有高延迟特征的操作(如每日批处理任务),
或者反过来突出显示那些延迟排名较低
但具有高 RPS(每秒请求数)的操作。
通过这些聚合数据,Jaeger UI 能够使用相关的服务、操作和回溯时间段
预填充追踪搜索,
缩小这些更有价值的追踪数据的搜索范围。
快速开始
Info
这仅用于演示目的,不反映部署最佳实践。
Jaeger 仓库中提供了一个可本地运行的设置,
以及运行说明。
该功能可以从顶部菜单的"Monitor"选项卡访问。
此演示包含 Microsim;一个用于生成追踪数据的微服务模拟器。
如果偏好手动生成追踪数据,可以通过 docker 启动示例应用:HotROD。请确保在 docker run 命令中包含 --net monitor_backend。
配置
方式一:兼容 PromQL 的后端配置
Jaeger 仓库中提供了一个示例配置:config-spm.yaml。启用 SPM 功能需要以下步骤:
- 在管道中启用 SpanMetrics Connector:
# Declare an exporter for metrics produced by the connector.
# For example, a Prometheus server may be configured to scrape
# the metrics from this endpoint.
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"

# Declare spanmetrics connector.
connectors:
  spanmetrics:
    # any connector configuration options
    ...

# Enable the spanmetrics connector to bridge
# the traces pipeline into the metrics pipeline.
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [jaeger_storage_exporter, spanmetrics]
    metrics/spanmetrics:
      receivers: [spanmetrics]
      exporters: [prometheus]
- 在
jaeger_storageextension 的metric_backends:下定义一个远程的兼容 PromQL 的存储:
extensions:
  jaeger_storage:
    backends:
      some_trace_storage:
        ...
    metric_backends:
      some_metrics_storage:
        prometheus:
          endpoint: http://prometheus:9090
- 在
jaeger_queryextension 中引用此指标存储:
extensions:
  jaeger_query:
    traces: some_trace_storage
    metrics_storage: some_metrics_storage
- 在 Jaeger UI 配置中设置
monitor.menuEnabled=true属性。
方式二:Elasticsearch/OpenSearch 后端配置
Jaeger 仓库中提供了一个示例配置:config-spm-elasticsearch.yaml。
此配置更简单,因为它不需要 SpanMetrics Connector 或单独的指标管道。
- 确保您的
jaeger_storageextension 配置了 Elasticsearch 或 OpenSearch 后端以及 metric_backends。
extensions:
  jaeger_storage:
    backends:
      elasticsearch_trace_storage: &elasticsearch_config
        elasticsearch:
          ...
    metric_backends:
      elasticsearch_trace_storage: *elasticsearch_config # This points the metric backend to the same Elasticsearch trace storage configuration
extensions:
  jaeger_storage:
    backends:
      opensearch_trace_storage: &opensearch_config
        opensearch:
          ...
    metric_backends:
      opensearch_trace_storage: *opensearch_config # This points the metric backend to the same OpenSearch trace storage configuration
- 在
jaeger_queryextension 中,将traces和metrics存储都设置为使用jaeger_storage中定义的相同 Elasticsearch 或 OpenSearch 后端。
extensions:
  jaeger_query:
    storage:
      traces: elasticsearch_trace_storage # Must match the backend defined in jaeger_storage extension
      metrics: elasticsearch_trace_storage # Use the same storage for metrics
extensions:
  jaeger_query:
    storage:
      traces: opensearch_trace_storage # Must match the backend defined in jaeger_storage extension
      metrics: opensearch_trace_storage # Use the same storage for metrics
- 在 Jaeger UI 配置中设置
monitor.menuEnabled=true属性。
架构
生成 RED 指标有两种架构方式:
- 预计算指标:使用 SpanMetrics Connector 从 span 中计算指标,并将其存储在兼容 PromQL 的后端存储中,由 Jaeger 进行查询。
- 直连存储:Jaeger Query 在查询时通过直接查询主追踪存储后端(Elasticsearch 或 OpenSearch)来计算 RED 指标。这种方式通过消除对单独指标管道和存储的需求来简化架构。
方式一:预计算指标
除了标准的 Jaeger 架构之外,此方式还需要:
- 在管道中引入一个 SpanMetrics Connector,用于接收追踪数据(span)并生成 RED 指标。
- 将生成的指标导出到兼容 Prometheus 的指标存储。在提供的示例中,这通过定义一个打开 HTTP 端点的
prometheusexporter 来实现,并配置 Prometheus 服务器从该端点抓取指标。另一种方式可以是使用推送式 exporter 将数据写入远程指标存储。 - 支持 PromQL 查询的外部指标存储。
- 在
jaeger_queryextension 中配置引用外部指标存储。
graph LR
OTLP_EXPORTER[OTLP Exporter] --> TRACE_RECEIVER
subgraph Application
    subgraph OpenTelemetry SDK
        OTLP_EXPORTER
    end
end

TRACE_RECEIVER[Trace Receiver] --> |spans| SPANMETRICS_CONN[SpanMetrics Connector]
TRACE_RECEIVER --> |spans| TRACE_EXPORTER[Trace Exporter]
TRACE_EXPORTER --> |spans| SPAN_STORE[(Trace Storage)]
SPANMETRICS_CONN --> |metrics| PROMETHEUS_EXPORTER[Prometheus Exporter]
PROMETHEUS_EXPORTER --> |metrics| METRICS_STORE[(Metrics Storage)]

SPAN_STORE --> QUERY[Jaeger Query]
METRICS_STORE --> QUERY
QUERY --> UI[Jaeger UI]

subgraph Jaeger all-in-one
    subgraph Pipeline
        TRACE_RECEIVER
        SPANMETRICS_CONN
        TRACE_EXPORTER
        PROMETHEUS_EXPORTER
        QUERY
        UI
    end
end

style Application fill:#DFDFDF,color:black

style OTLP_EXPORTER fill:#404CA8,color:white
style TRACE_RECEIVER fill:#404CA8,color:white
style TRACE_EXPORTER fill:#404CA8,color:white
style SPANMETRICS_CONN fill:#404CA8,color:white
style PROMETHEUS_EXPORTER fill:#404CA8,color:white

style UI fill:#9AEBFE,color:black
style QUERY fill:#9AEBFE,color:black
方式二:Elasticsearch/OpenSearch 后端
此方式直接从 Elasticsearch 或 OpenSearch 中存储的追踪数据计算指标,无需 Prometheus 等单独的指标存储后端。仍然使用 OpenTelemetry Collector 来接收追踪数据并将其转发到 Jaeger,但不需要 SpanMetrics Connector。
graph LR
OTLP_EXPORTER[OTLP Exporter] --> TRACE_RECEIVER
subgraph Application
    subgraph OpenTelemetry SDK
        OTLP_EXPORTER
    end
end

TRACE_RECEIVER[Trace Receiver] --> |spans| TRACE_EXPORTER[Trace Exporter]
TRACE_EXPORTER --> |spans| TRACE_STORAGE[(Elasticsearch / OpenSearch)]

TRACE_STORAGE -->|traces & metrics queries| QUERY[Jaeger Query]
QUERY --> UI[Jaeger UI]

subgraph Jaeger all-in-one
    subgraph Pipeline
        TRACE_RECEIVER
        TRACE_EXPORTER
        QUERY
        UI
    end
end

style Application fill:#DFDFDF,color:black
style TRACE_RECEIVER fill:#404CA8,color:white
style TRACE_EXPORTER fill:#404CA8,color:white
style UI fill:#9AEBFE,color:black
style QUERY fill:#9AEBFE,color:black
指标存储
当使用兼容 PromQL 的后端架构时,Jaeger Query 支持任何兼容 PromQL 的后端。Julius Volz 整理了一份清单:https://promlabs.com/blog/2020/11/26/an-update-on-promql-compatibility-across-vendors
当使用直接查询架构时,Elasticsearch 和 OpenSearch 均支持追踪存储和指标计算。
派生时间序列
Info
本节仅适用于兼容 PromQL 的后端架构。
了解 SpanMetrics Connector 将在指标存储中生成的额外指标和时间序列是有价值的,
这有助于在部署 SPM 时进行容量规划。
请参阅 Prometheus 文档,
了解指标名称、类型、标签和时间序列的概念;这些术语将在本节的其余部分中使用。
将创建两个指标名称:
calls_total- 类型:counter
- 描述:计算 span 的总数,包括错误 span。
调用计数通过status_code标签与错误区分。错误
被标识为任何具有标签status_code = "STATUS_CODE_ERROR"的时间序列。
[namespace_]duration_[units]- 类型:histogram
- 描述:span 持续时间/延迟的直方图。在底层,Prometheus 直方图
会创建多个时间序列。为便于说明,假设未配置命名空间
且单位为milliseconds:duration_milliseconds_count:直方图中所有桶的数据点总数。duration_milliseconds_sum:所有数据点值的总和。duration_milliseconds_bucket:n个时间序列的集合(其中n是持续时间桶的数量),
每个持续时间桶由le(小于或等于)标签标识。对于每个 span,
具有最低le且le >= span 持续时间的duration_milliseconds_bucket计数器将递增。
以下公式旨在为新创建的时间序列数量提供一些指导:
num_status_codes * num_span_kinds * (1 + num_latency_buckets) * num_operations

Where:
  num_status_codes = 3 max (typically 2: ok/error)
  num_span_kinds = 6 max (typically 2: client/server)
  num_latency_buckets = 17 default
代入这些数字,假设默认配置:
max = 324 * num_operations
typical = 72 * num_operations
注意:
API
gRPC/Protobuf
以编程方式检索 RED 指标的推荐方式是通过 jaeger.api_v2.metrics.MetricsQueryService gRPC 端点,该端点定义在 metricsquery.proto IDL 文件中。
HTTP JSON
由 Jaeger UI 的 Monitor 选项卡内部使用,用于填充其可视化所需的指标。
请参阅此 README 文件以获取
HTTP API 的详细规范。
故障排除
检查 Jaeger-Prometheus 连接
通过检查 Jaeger 的内部遥测数据来验证 Jaeger query 是否能连接到兼容 Prometheus 的指标存储。
Jaeger 配置需要在 telemetry: 部分启用指标端点。请注意,内部遥测应暴露在与 spanmetrics connector 导出指标所用端口(例如 8889)不同的端口上(例如 8888)。
service:
  ...
  telemetry:
    resource:
      service.name: jaeger
    metrics:
      level: detailed
      address: 0.0.0.0:8888
该端口上的 /metrics 端点可用于检查 UI 对 SPM 数据的查询是否成功:
curl -s http://jaeger:8888/metrics | grep jaeger_metricstore
以下指标最值得关注:
jaeger_metricstore_requests_totaljaeger_metricstore_latency_bucket
每个指标都包含以下操作的标签:
get_call_ratesget_error_ratesget_latenciesget_min_step_duration
如果一切正常,带有 result="ok" 标签的指标应该在递增,
而 result="err" 应该保持不变。例如:
jaeger_metricstore_requests_total{operation="get_call_rates",result="ok"} 18
jaeger_metricstore_requests_total{operation="get_error_rates",result="ok"} 18
jaeger_metricstore_requests_total{operation="get_latencies",result="ok"} 36

jaeger_metricstore_latency_bucket{operation="get_call_rates",result="ok",le="0.005"} 5
jaeger_metricstore_latency_bucket{operation="get_call_rates",result="ok",le="0.01"} 13
jaeger_metricstore_latency_bucket{operation="get_call_rates",result="ok",le="0.025"} 18

jaeger_metricstore_latency_bucket{operation="get_error_rates",result="ok",le="0.005"} 7
jaeger_metricstore_latency_bucket{operation="get_error_rates",result="ok",le="0.01"} 13
jaeger_metricstore_latency_bucket{operation="get_error_rates",result="ok",le="0.025"} 18

jaeger_metricstore_latency_bucket{operation="get_latencies",result="ok",le="0.005"} 7
jaeger_metricstore_latency_bucket{operation="get_latencies",result="ok",le="0.01"} 25
jaeger_metricstore_latency_bucket{operation="get_latencies",result="ok",le="0.025"} 36
如果从 Prometheus 读取指标时出现问题(如无法连接到
Prometheus 服务器),则 result="err" 指标将递增。例如:
jaeger_metricstore_requests_total{operation="get_call_rates",result="err"} 4
jaeger_metricstore_requests_total{operation="get_error_rates",result="err"} 4
jaeger_metricstore_requests_total{operation="get_latencies",result="err"} 8
此时,检查日志将有助于进一步定位问题的根本原因。
查询 Prometheus
即使上述 Jaeger 指标显示成功从 Prometheus 读取数据,
图表仍可能显示为空。在这种情况下,直接在 Prometheus 中查询 spanmetrics connector 应该生成的任何指标:
traces_span_metrics_duration_milliseconds_buckettraces_span_metrics_calls_total
随着 Jaeger 接收到追踪数据,您应该看到这些计数器在递增。
检查日志
如果上述指标在 Prometheus 中存在,但未出现在 Monitor
选项卡中,则表示 Jaeger 期望在 Prometheus 中看到的指标与实际可用的指标之间存在差异。
可以通过提高日志级别来确认:
service:
  telemetry:
    ...
    logs:
      level: debug
输出类似以下的日志(已格式化以便阅读):
2024-11-26T19:09:43.152Z debug metricsstore/reader.go:258 Prometheus query results
{
  "kind": "extension",
  "name": "jaeger_storage",
  "results": "",
  "query": "sum(rate(traces_span_metrics_calls_total{service_name =~ \"redis\", span_kind =~ \"SPAN_KIND_SERVER\"}[10m])) by (service_name,span_name)",
  "range": {
    "Start": "2024-11-26T19:04:43.14Z",
    "End": "2024-11-26T19:09:43.14Z",
    "Step": 60000000000
  }
}
在这个例子中,假设 OpenTelemetry Collector 的 prometheusexporter 引入了
一个破坏性更改,在 counter 指标后附加 _total 后缀,
并在 histogram 指标中附加持续时间单位(例如 duration_milliseconds_bucket)。如我们所发现的,
Jaeger 正在查找 calls(和 duration_bucket)指标名称,
而 OpenTelemetry Collector 写入的是 calls_total(和 duration_milliseconds_bucket)。
此特定情况的解决方案是向指标后端配置传递参数,告诉 Jaeger
规范化指标名称,使其知道搜索 calls_total 和duration_milliseconds_bucket,如下所示:
extensions:
  jaeger_storage:
    backends:
      ...
    metric_backends:
      some_metrics_storage:
        prometheus:
          endpoint: http://prometheus:9090
          normalize_calls: true
          normalize_duration: true
检查 OpenTelemetry Collector 配置
如果 Jaeger 中出现错误 span,但没有对应的错误指标:
检查 Prometheus 中由 spanmetrics connector 生成的原始指标
(如上所列:calls、calls_total、duration_bucket等)中,
该 span 所属的指标是否包含status.code标签。如果没有
status.code标签,请检查 OpenTelemetry Collector
配置文件,特别注意是否存在以下配置:exclude_dimensions: ['status.code']Jaeger 使用此标签来确定请求是否有错误。
检查 OpenTelemetry Collector
如果上述 latency_bucket 和 calls_total 指标为空,则可能
是 OpenTelemetry Collector 或其上游的配置问题。
故障排除时可以考虑以下问题:
- OpenTelemetry Collector 是否配置正确?
- OpenTelemetry Collector 能否访问 Prometheus 服务器?
- 服务是否正在向 OpenTelemetry Collector 发送 span?
服务/操作在 Monitor 选项卡中缺失
如果服务/操作在 Monitor 选项卡中缺失,但在 Jaeger
追踪搜索的服务和操作下拉菜单中可见,常见原因是
指标查询中使用了默认的 server span kind。
您看不到的服务/操作可能来自非 server
span kind 的 span,例如 client 或更糟糕的 unspecified。因此,这是一个数据
质量问题,应在应用埋点时设置 span kind。
默认使用 server span kind 的原因是为了避免在 server 和 client span kind 中
分别对入站和出站 span 进行重复计数。
执行指标查询时返回 403
如果日志中出现类似以下的错误:failed executing metrics query: client_error: client error: 403,
可能是 Prometheus 服务器需要 bearer token。
Jaeger 可以配置为在指标查询中传递 bearer token。可以通过 token_file_path: 属性定义 token:
extensions:
  jaeger_storage:
    backends:
      ...
    metric_backends:
      some_metrics_storage:
        prometheus:
          endpoint: http://prometheus:9090
          token_file_path: /path/to/token/file
          token_override_from_context: true