Prometheus 支持四种指标类型:
- Counter(计数器)
- Gauge(仪表盘)
- Histogram(直方图)
- Summary(摘要)
Counter
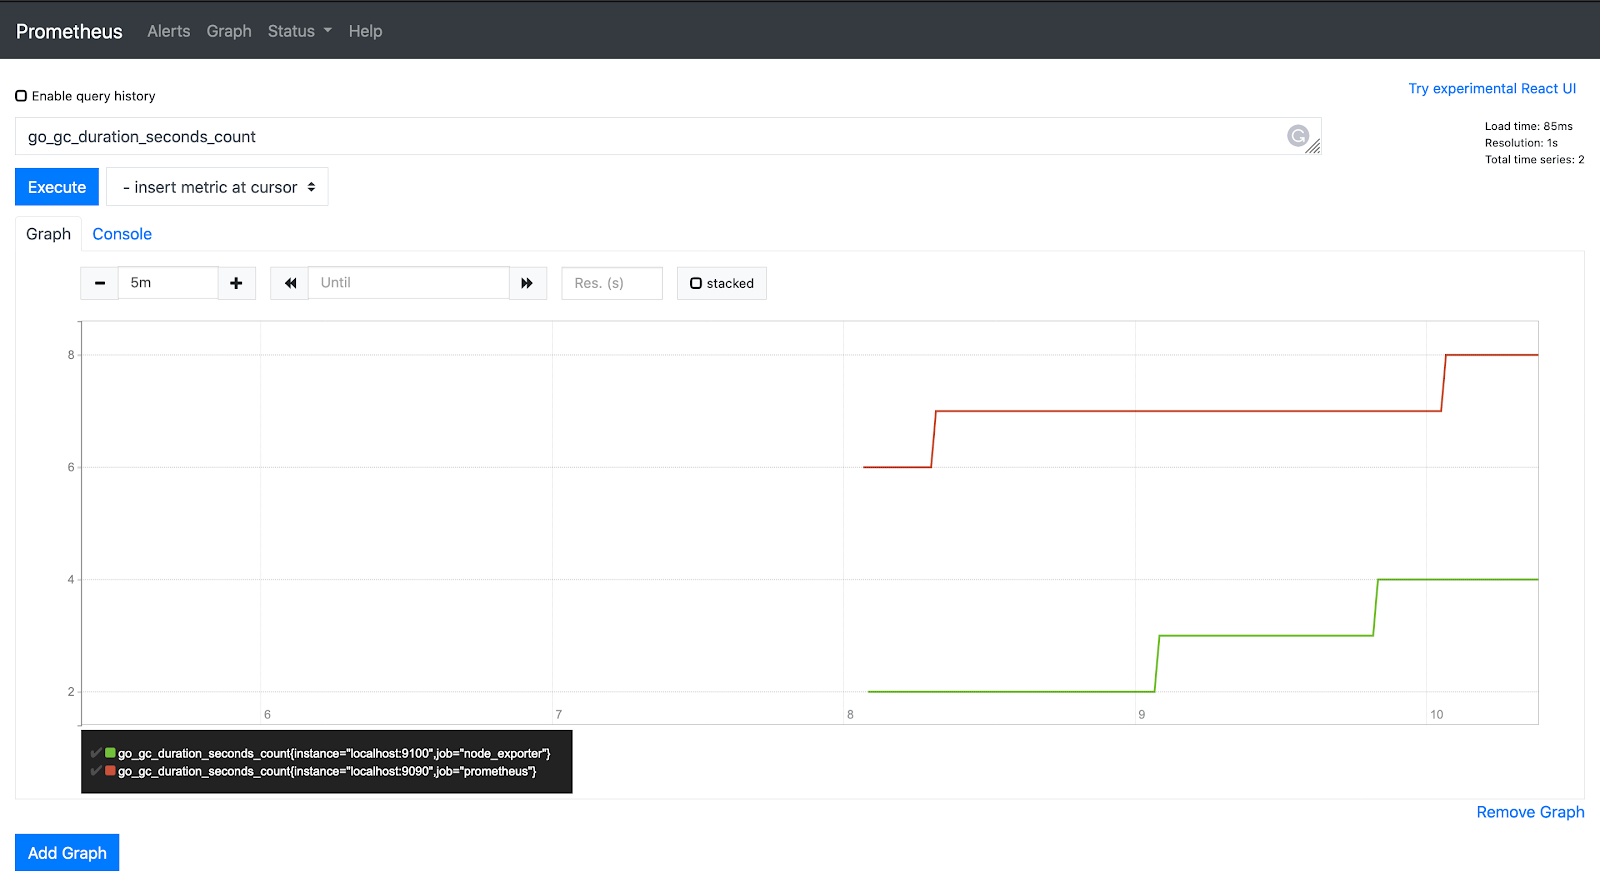
Counter 是一个只能增加或重置的指标值,即该值不能减少到低于前一个值。它可以用于请求数量、错误数量等指标。
在查询栏中输入以下查询并点击执行。
go_gc_duration_seconds_count
PromQL 中的 rate() 函数获取一个时间范围内的指标历史,并计算每秒值增长的速度。Rate 仅适用于 counter 值。
rate(go_gc_duration_seconds_count[5m])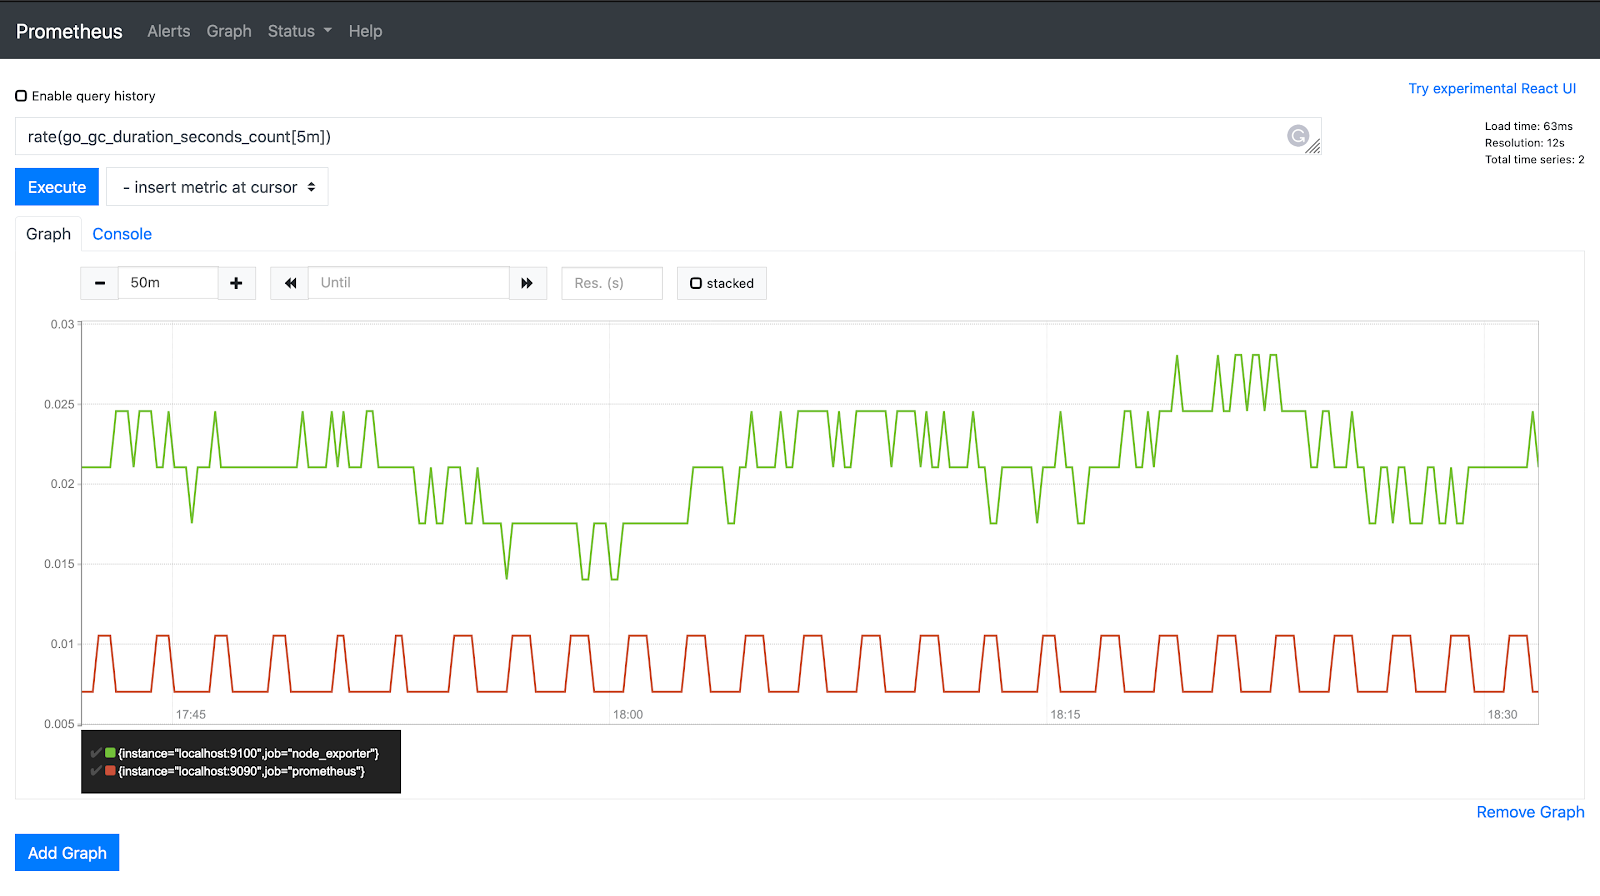
Gauge
Gauge 是一个可以上升或下降的数值。它可以用于集群中的 pod 数量、队列中的事件数量等指标。
go_memstats_heap_alloc_bytes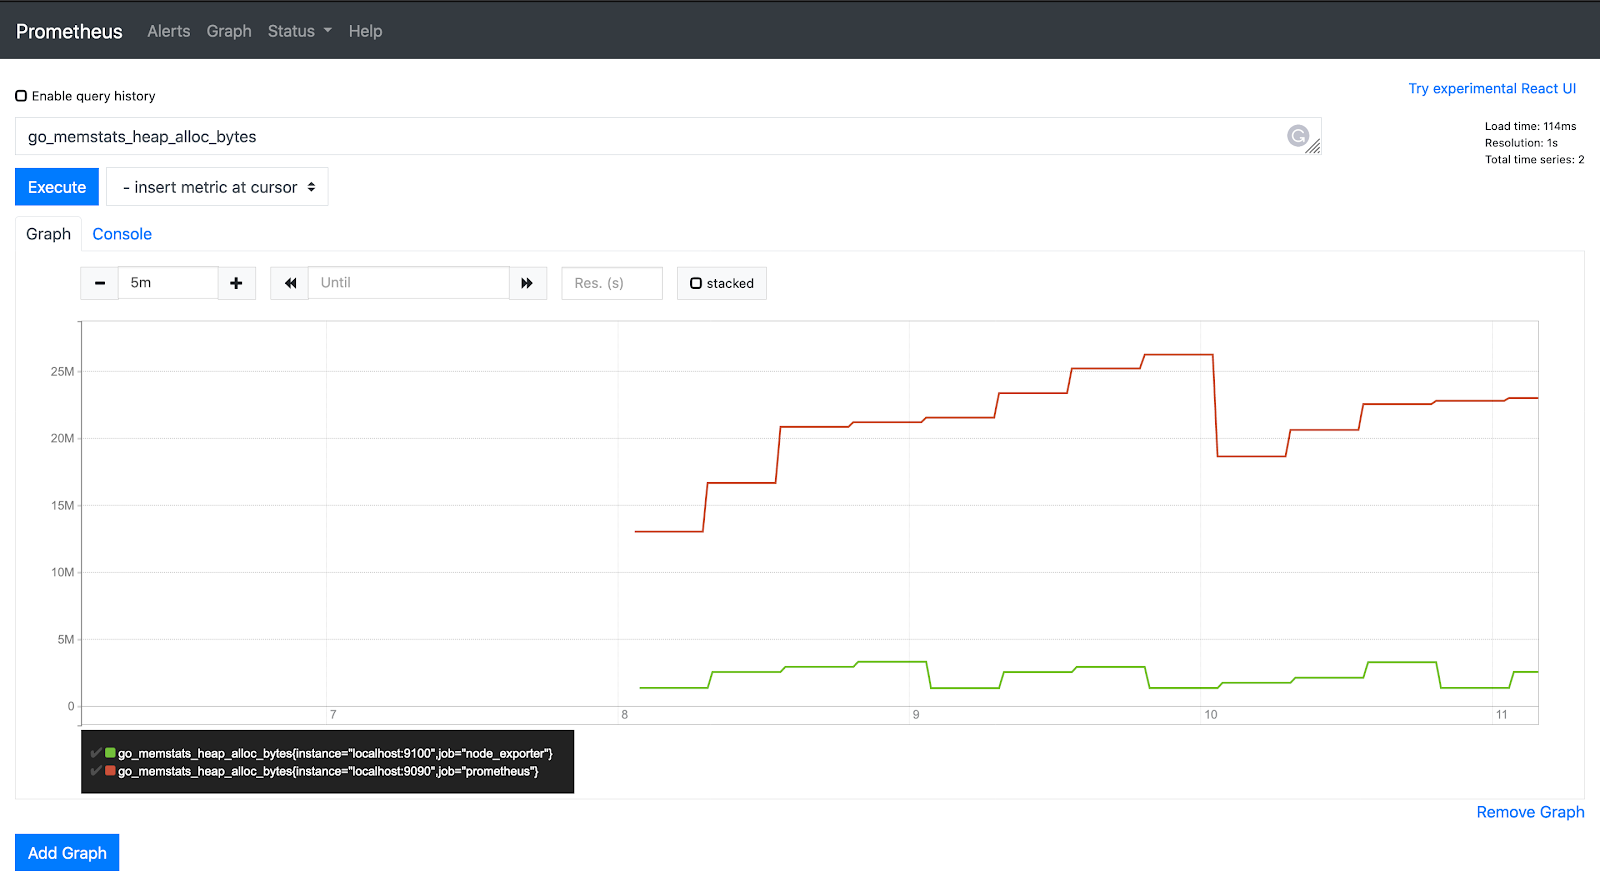
PromQL 函数如 max_over_time、min_over_time 和 avg_over_time 可以用于 gauge 指标。
Histogram
与前两种相比,Histogram 是一种更复杂的指标类型。Histogram 可以用于任何基于桶值计算的值。桶边界可以由开发者配置。一个常见的例子是响应请求所需的时间,称为延迟。
示例:假设我们想观察处理 API 请求所花费的时间。我们不是为每个请求存储请求时间,而是使用直方图将它们存储在桶中。我们定义时间的桶,例如 lower or equal 0.3、le 0.5、le 0.7、le 1 和 le 1.2。这些就是我们的桶,一旦计算出请求的处理时间,它就会被添加到所有桶边界高于测量值的桶的计数中。
假设端点 "/ping" 的请求 1 花费了 0.25 秒。各桶的计数值将是:
/ping
| 桶 | 计数 |
|---|---|
| 0 - 0.3 | 1 |
| 0 - 0.5 | 1 |
| 0 - 0.7 | 1 |
| 0 - 1 | 1 |
| 0 - 1.2 | 1 |
| 0 - +Inf | 1 |
注意:+Inf 桶是默认添加的。
(由于直方图是累积频率,所以 1 被添加到所有大于该值的桶中)
端点 "/ping" 的请求 2 花费了 0.4 秒。各桶的计数值将是:
/ping
| 桶 | 计数 |
|---|---|
| 0 - 0.3 | 1 |
| 0 - 0.5 | 2 |
| 0 - 0.7 | 2 |
| 0 - 1 | 2 |
| 0 - 1.2 | 2 |
| 0 - +Inf | 2 |
由于 0.4 低于 0.5,所有到该边界的桶都增加了计数。
让我们从 Prometheus UI 中探索一个直方图指标并应用一些函数。
prometheus_http_request_duration_seconds_bucket{handler="/graph"}
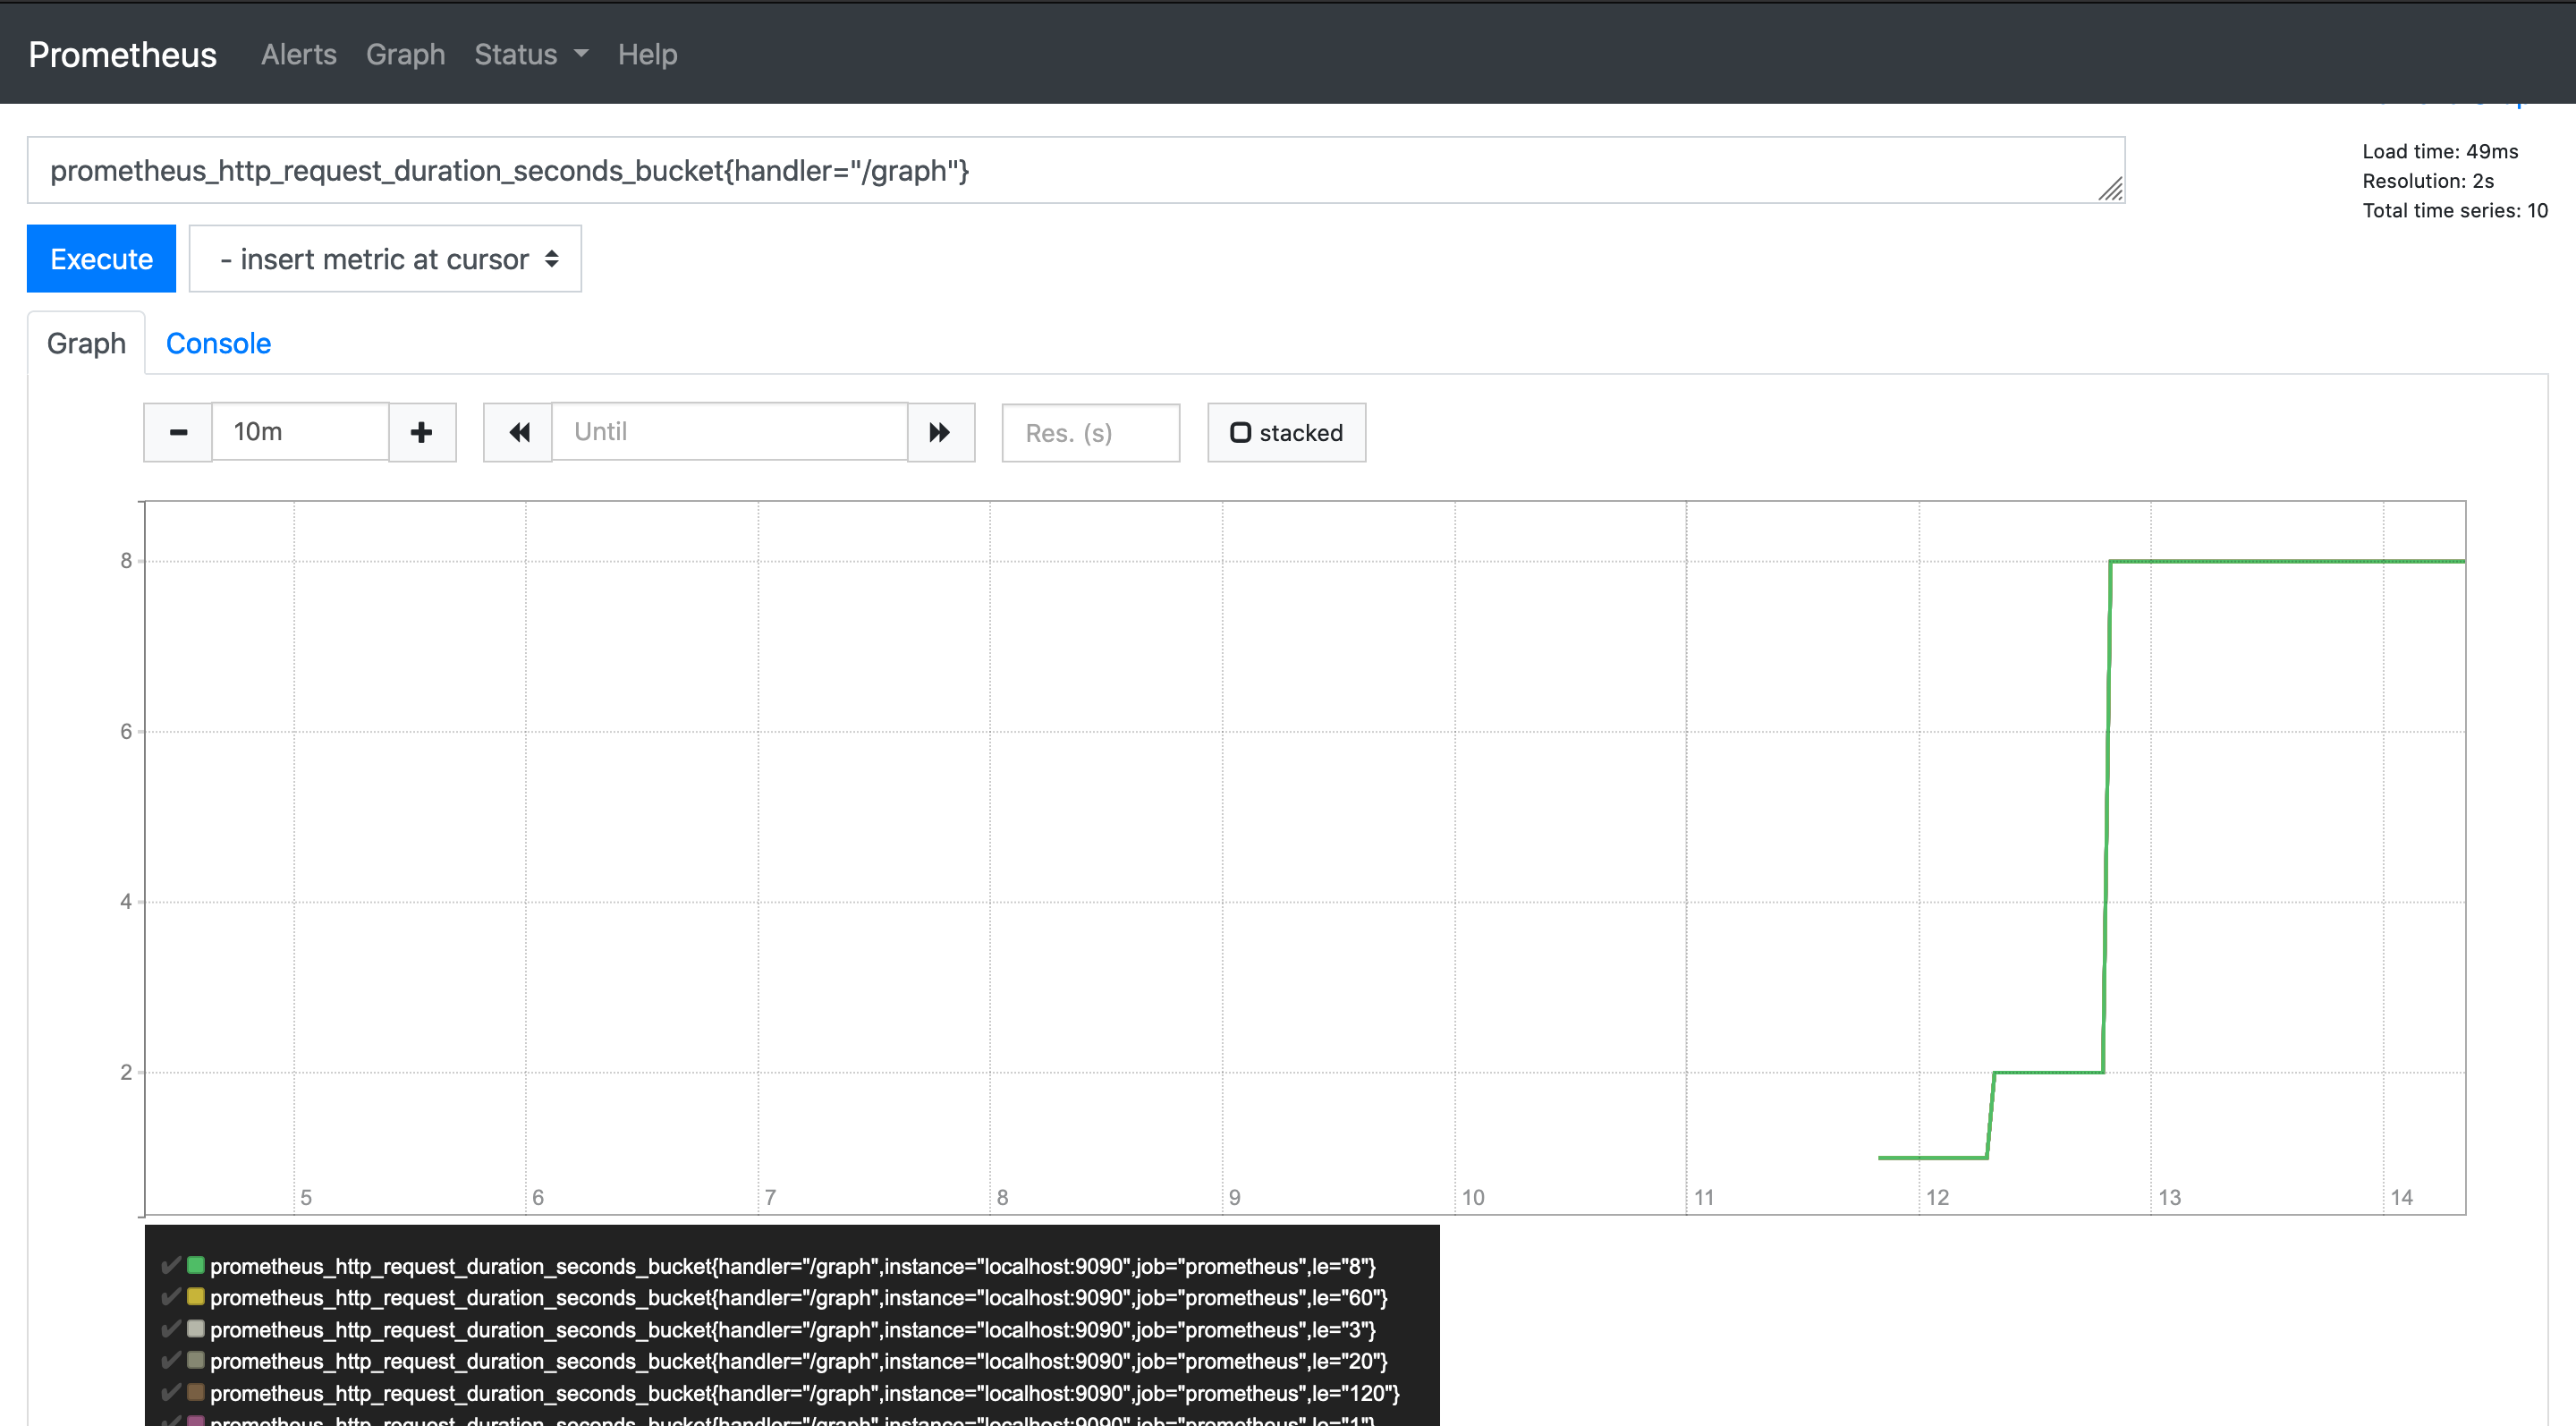
histogram_quantile() 函数可用于从直方图计算分位数
histogram_quantile(0.9,prometheus_http_request_duration_seconds_bucket{handler="/graph"})
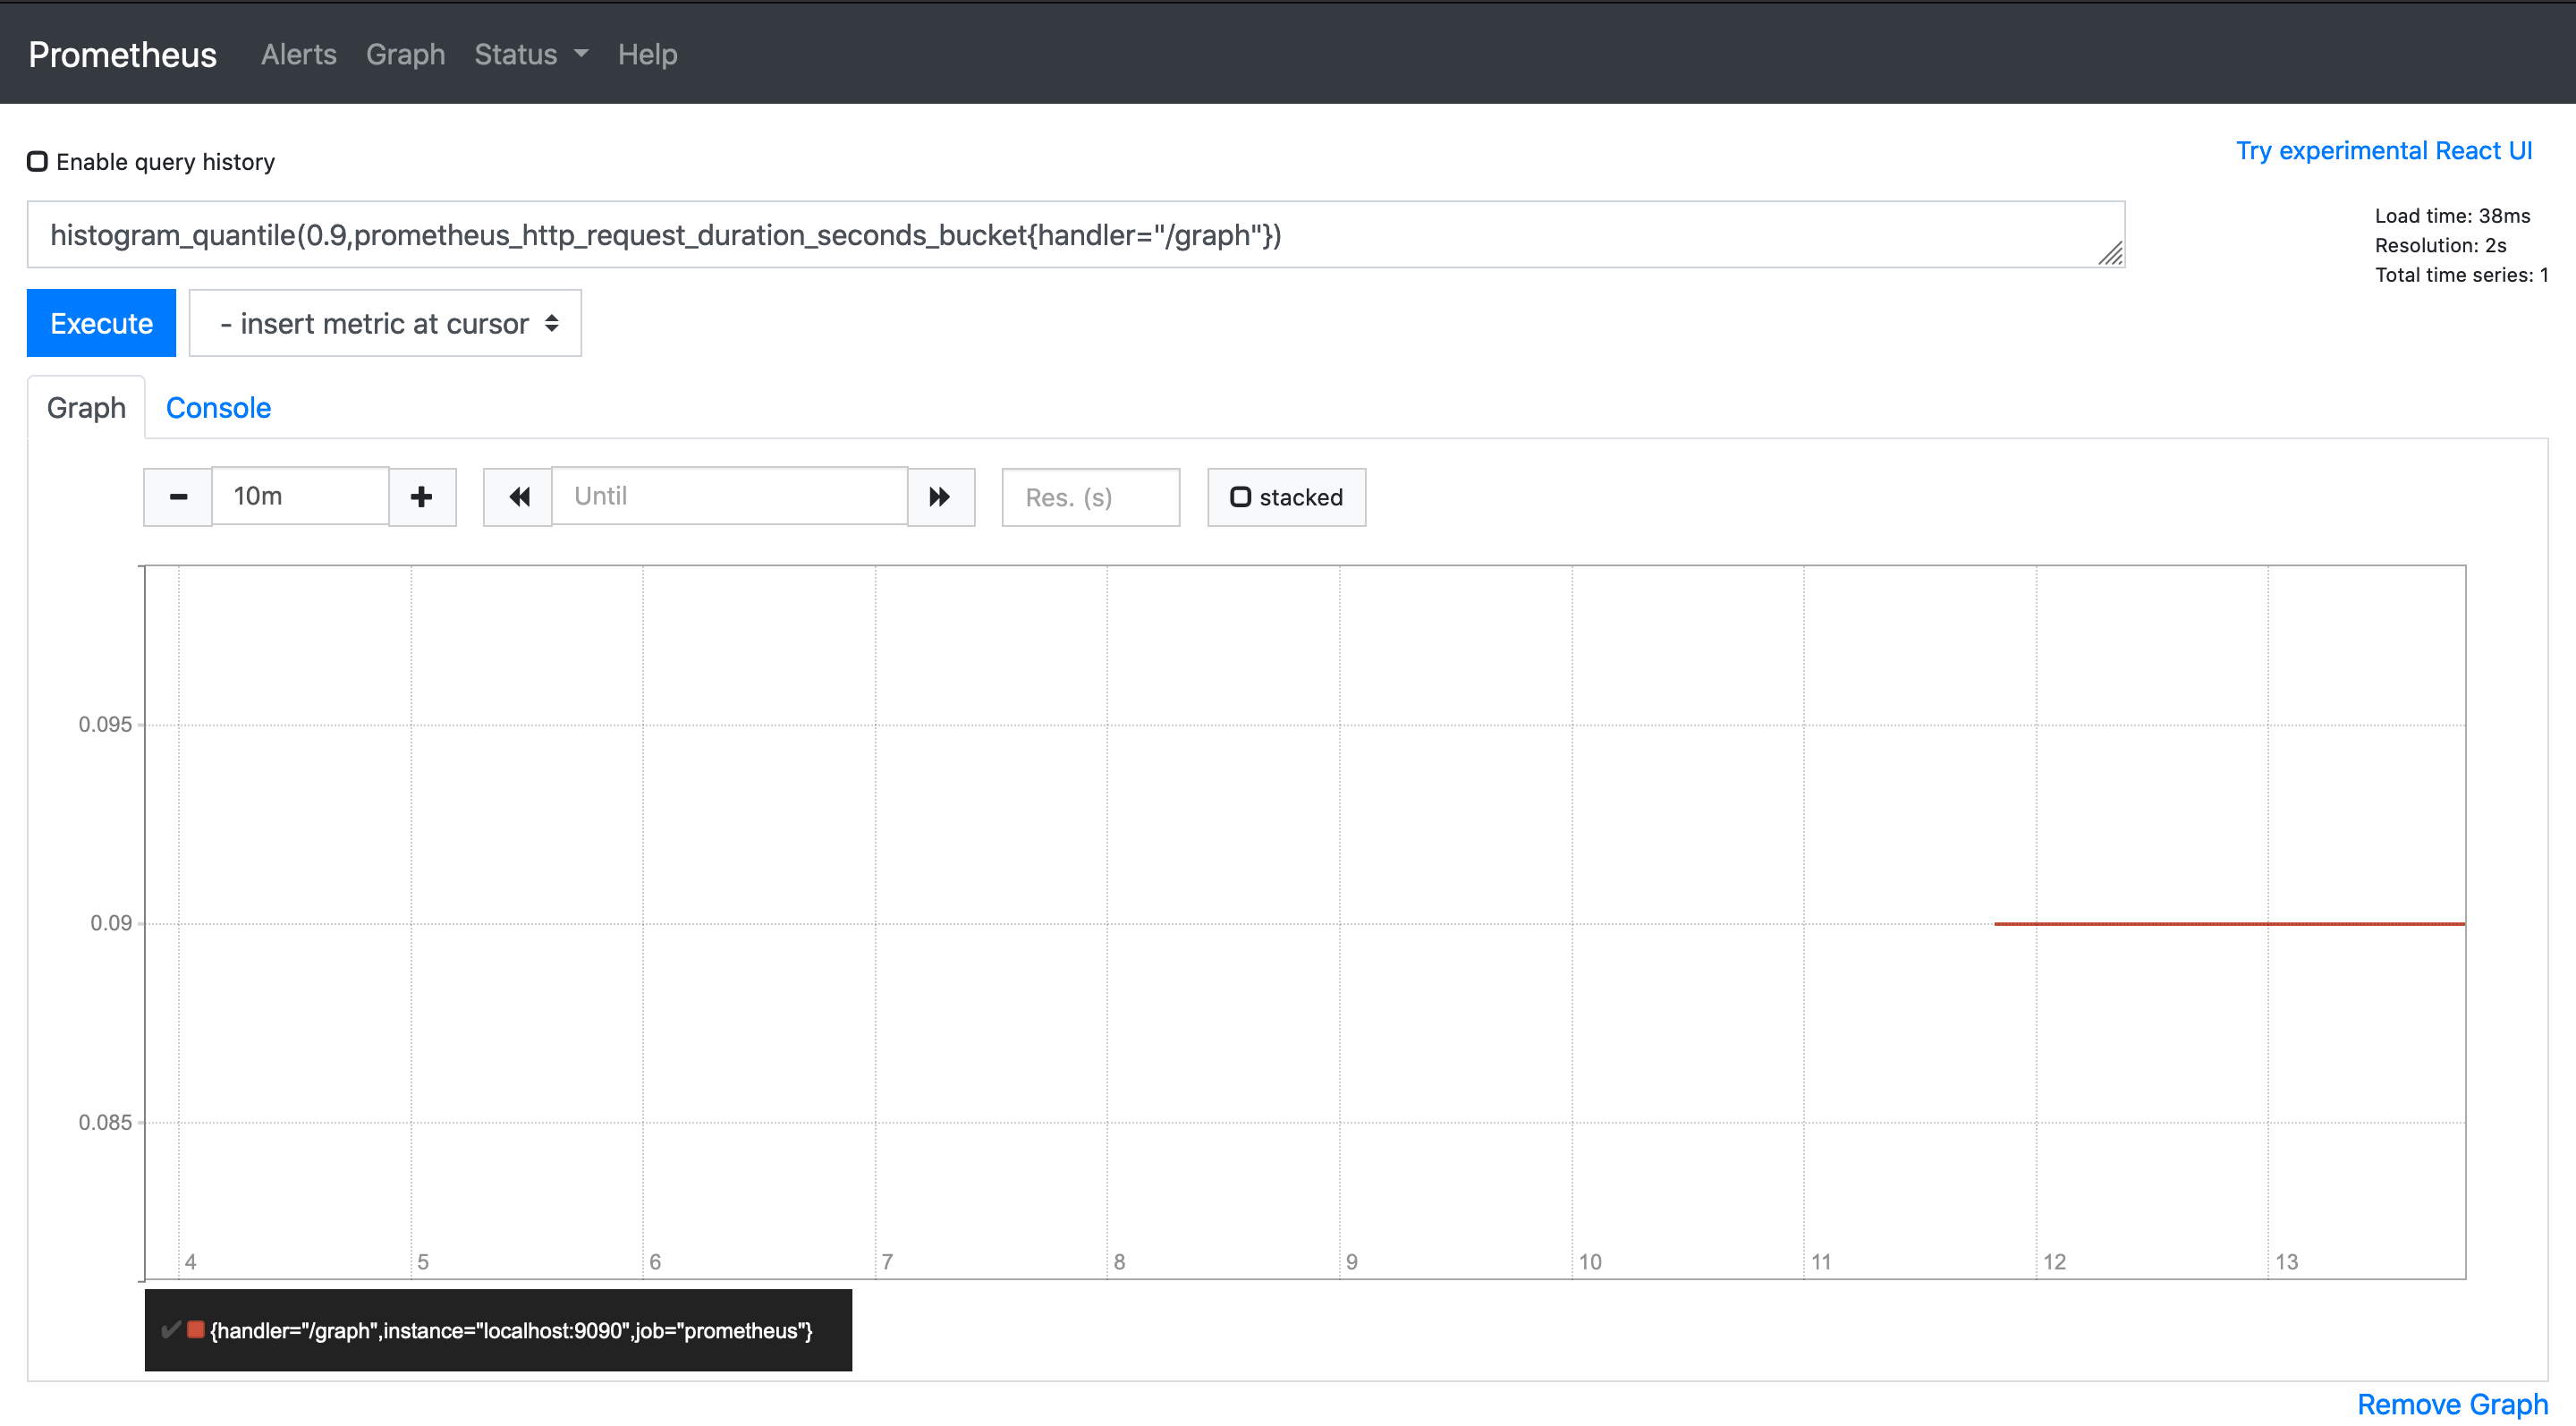
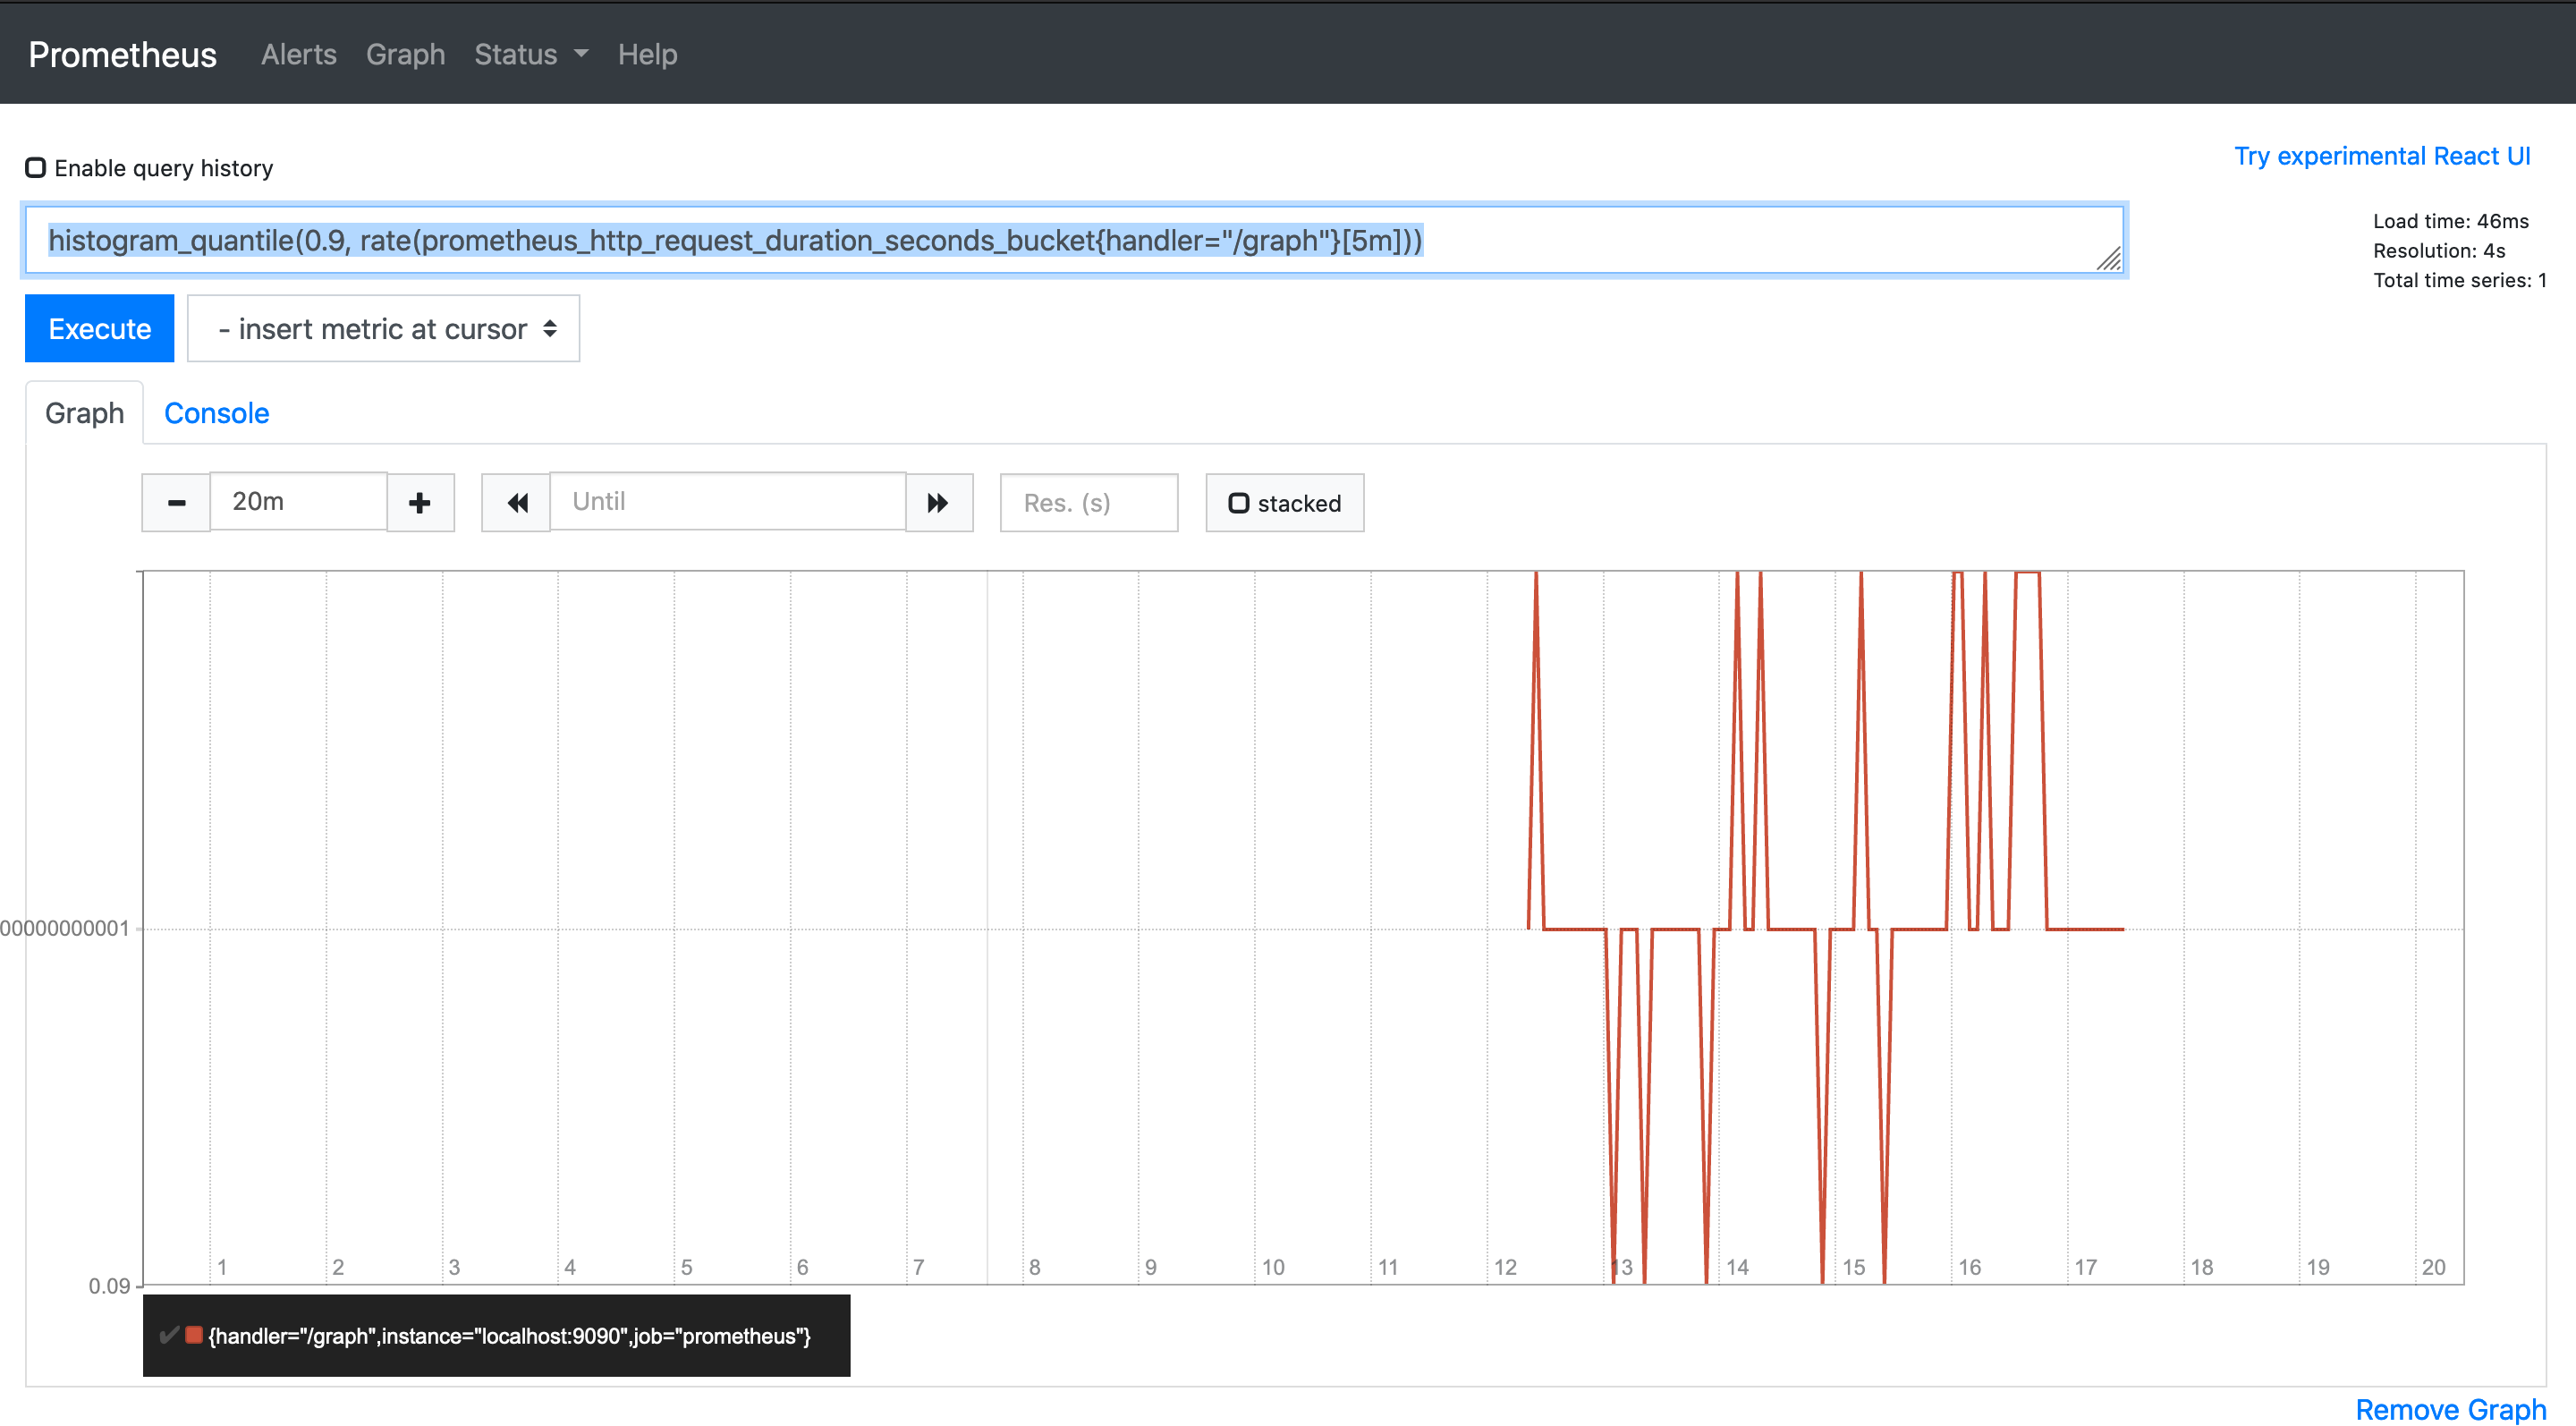
图表显示第 90 百分位数为 0.09。要计算最近 5 分钟内的 histogram_quantile,可以使用 rate() 和时间范围
histogram_quantile(0.9, rate(prometheus_http_request_duration_seconds_bucket{handler="/graph"}[5m]))
Summary
Summary 也用于测量事件,是直方图的替代方案。它们更节省资源但会丢失更多数据。它们在应用程序级别进行计算,因此无法聚合来自同一进程多个实例的指标。当事先不知道指标的桶时可以使用它们,但强烈建议尽可能使用直方图而不是摘要。
在本教程中,我们详细介绍了指标类型以及一些 PromQL 操作,如 rate、histogram_quantile 等。